





Cas métier de bout en bout
Trois déploiements réels d'agents LLM outillés — support client, ops et back-office — analysés de bout en bout pour montrer comment les principes des chapitres précédents se combinent en production.
Table des matières
Pourquoi ce chapitre clôt la formation
Les huit chapitres précédents ont isolé chaque brique séparément : la boucle reason-act, le contrat d'un outil, la mémoire, la planification, la coordination multi-agentsagentIASystème qui enchaîne des appels d'outils de façon autonome pour atteindre un objectif : il planifie, agit, observe, recommence. Sa fiabilité décroît exponentiellement avec le nombre d'étapes.Voir dans le glossaire, les garde-fous, l'observabilité. Cette décomposition est nécessaire pour comprendre chaque mécanisme, mais elle ne montre pas comment ces briques s'assemblent quand il faut livrer quelque chose qui tourne réellement en production, sous une charge réelle, avec de vrais coûts et de vraies conséquences en cas d'erreur.
Ce chapitre part dans l'autre sens. Il prend trois cas métier représentatifs — support client, exploitation informatique (ops), back-office administratif — et les déroule intégralement : déclencheur, outilstool callingIACapacité d'un agent ou d'un LLM à invoquer des outils externes (API, calcul, recherche) pendant le raisonnement.Voir dans le glossaire mobilisés, points de décision, échecs les plus probables, validation humaine. L'objectif n'est pas de fournir un code prêt à copier, mais un gabarit de raisonnement transférable à n'importe quel projet d'agent que vous aurez à concevoir ensuite.
Un agent LLMLLMIAGrand modèle de langage (Large Language Model) entraîné sur d'énormes corpus pour prédire et générer du texte.Voir dans le glossaire outillé est un composant qui s'insère dans un système existant : CRM, ERP, ticketing, supervision. Sa valeur ne se mesure pas à la sophistication du raisonnement du modèle mais à la fiabilité de bout en bout de la chaîne dans laquelle il s'insère — y compris les parties qui ne sont pas du LLMgrand modèle de langageIAModèle entraîné à prédire le token suivant d'une séquence de texte. Toutes ses capacités apparentes — résumer, traduire, coder — découlent de cette unique tâche.Voir dans le glossaire.
Cas 1 — Agent de support client
Déclencheur. Un ticket entre par email, formulaire ou chat. Le déclencheur porte un texte libre, parfois une pièce jointe, rarement une structure exploitable telle quelle.
Chaîne d'outils typique. L'agent commence presque toujours par une recherche dans la base de connaissances (RAGRAGIATechnique consistant à rechercher les documents pertinents et à les fournir au modèle dans son contexte. Elle permet des réponses à jour et citables, ce que l'affinage ne permet pas.Voir dans le glossaire) pour situer le sujet, puis interroge le CRM pour retrouver le client et son historique, avant d'envisager une action : générer un avoir, réexpédier un colis, ouvrir un dossier de réclamation, escalader vers un humain. Chaque étape est un appel d'outil distinct, avec un résultat observé avant de décider de la suivante — c'est la boucle reason-act posée au chapitre correspondant, appliquée ici à un cas concret.
Le point sensible. La recherche documentaire (répondre à une question) et l'action transactionnelle (rembourser, modifier un abonnement) n'ont pas le même niveau de risque. Un agent qui traite les deux avec la même latitude de décision est mal conçu : consulter une FAQ n'engage rien, émettre un avoir de 300 € engage de l'argent réel. La classification du risque par type d'action, vue au chapitre sur les garde-fous, trouve ici son application la plus directe.
Un agent support est autorisé à exécuter automatiquement un remboursement si trois conditions sont réunies : le montant est inférieur à 50 €, la commande a moins de 30 jours, et le motif correspond à une catégorie pré-validée par l'équipe support (article non reçu, défaut constaté avec photo). Hors de ce périmètre, l'agent prépare l'action et la soumet à validation humaine avant exécution. Le périmètre n'est pas décidé par le modèle : il est codé en dur dans l'outil
create_refund, qui refuse l'appel si les conditions ne sont pas remplies, quelle que soit l'insistance du raisonnement du modèle.
Cas 2 — Agent ops et supervision
Déclencheur. Une alerte de monitoring : latence anormale, taux d'erreur en hausse, service indisponible. Le déclencheur est structuré (métrique, seuil, service concerné), ce qui change la nature du problème par rapport au support client : l'ambiguïté porte moins sur la compréhension de la demande que sur le diagnostic de la cause.
Chaîne d'outils typique. L'agent interroge les logs applicatifs, croise avec les métriques d'infrastructure, consulte l'historique des déploiements récents pour repérer une corrélation temporelle, puis propose une remédiation : redémarrage d'un service, rollback d'un déploiement, scaling horizontal, ou simple notification si aucune action automatisée n'est jugée sûre.
Le point sensible. Ici, le risque n'est pas financier mais opérationnel : une action de remédiation mal choisie peut aggraver l'incident au lieu de le résoudre. Un rollback déclenché sur un mauvais diagnostic peut réintroduire un bug déjà corrigé. C'est un terrain où la planification (chapitre correspondant) compte autant que l'exécution : l'agent doit être capable d'formuler un diagnostic vérifiable avant d'agir, pas seulement d'enchaîner des actions plausibles.
Un modèle peut produire un enchaînement de causes très convaincant sans qu'aucune étape n'ait été confirmée par une donnée réelle. En ops, exigez que chaque hypothèse de cause soit adossée à un appel d'outil qui la confirme ou l'infirme (requête de log précise, comparaison de métrique avant/après déploiement) avant d'autoriser une action corrective. Un agent qui « raisonne juste » sans vérifier reste un générateur de texte plausible, pas un outil de diagnostic.
Cas 3 — Agent back-office
Déclencheur. Un document arrive : facture fournisseur, bon de livraison, relevé bancaire. Le déclencheur est un fichier non structuré (PDF, image scannée, email avec pièce jointe) qu'il faut d'abord transformerTransformerIAArchitecture introduite en 2017, fondée sur le mécanisme d'attention, qui traite une séquence entière en parallèle. Elle sert de base à tous les grands modèles de langage actuels.Voir dans le glossaire en donnéesdonnéesIAEnsemble d'informations structurées ou non utilisées pour entraîner, évaluer ou alimenter un modèle. La qualité, la quantité et la représentativité des données sont les facteurs décisifs pour les performances en apprentissage automatique.Voir dans le glossaire exploitables.
Chaîne d'outils typique. Extraction des champs (montant, fournisseur, numéro de commande, date d'échéance), recherche du bon de commande correspondant dans l'ERP, comparaison ligne à ligne, puis selon le résultat : validation automatique du paiement, mise en attente pour écart constaté, ou relance du fournisseur si une pièce manque.
Le point sensible. L'extraction de champs à partir d'un document scanné est probabiliste par nature — un montant mal reconnu, un numéro de commande tronqué. Contrairement au support client où l'erreur porte sur une décision, ici l'erreur peut se nicher dans la donnée d'entrée elle-même, avant même que l'agent ne décide quoi que ce soit. Le contrôle porte donc autant sur la qualité de l'extraction que sur la logique de rapprochement.
Face à un écart entre facture et bon de commande, la tentation est de laisser l'agent ajuster automatiquement pour que les chiffres correspondent. C'est l'erreur la plus coûteuse observée dans ce type de déploiement : elle transforme un contrôle comptable en simple formalité contournable. Un écart doit systématiquement être journalisé et soumis à validation, jamais résorbé silencieusement par l'agent lui-même.
Anatomie commune de la boucle agentique
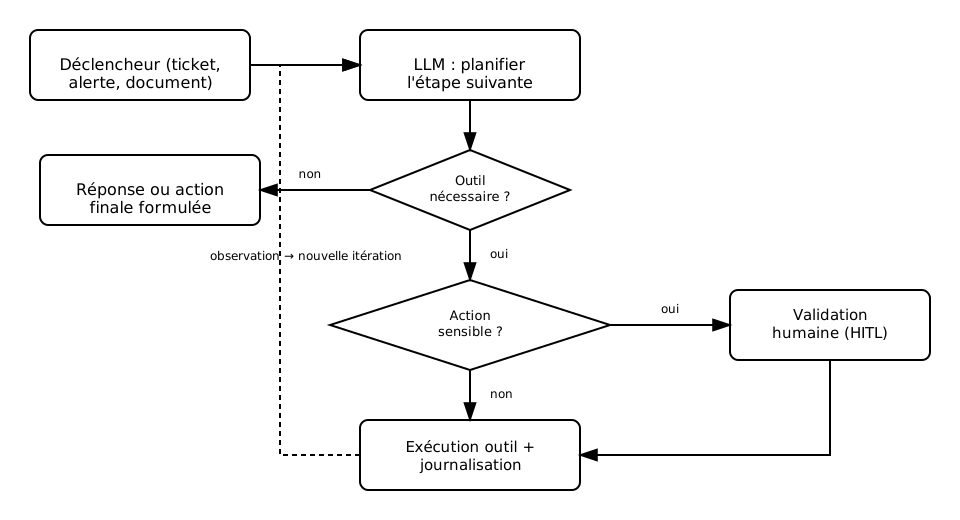
Les trois cas, malgré des métiers très différents, partagent la même structure de boucle : le modèle reçoit un état (ticket, alerte, document), décide s'il a besoin d'un outil, observe le résultat de l'appel, et recommence jusqu'à disposer d'assez d'information pour conclure — répondre, agir, ou transmettre à un humain.
Ce schéma est le même quel que soit le métier. Ce qui change d'un cas à l'autre, c'est le contenu des outils, le seuil de ce qui est classé « sensible », et qui est habilité à valider. C'est précisément parce que la structure est stable qu'elle mérite d'être conçue une fois, proprement, puis réutilisée.
Concevoir les outils : contrat, permissions, idempotence
Trois propriétés reviennent dans les trois cas métier, indépendamment du domaine.
Le contrat d'outil doit être étroit. Un outil update_customer qui accepte n'importe quel champ du CRM en paramètre libre est une invitation à l'erreur : le modèle peut modifier une adresse email en pensant corriger un numéro de téléphone. Un outil update_customer_phone qui n'accepte qu'un numéro de téléphone au format validé réduit l'espace des erreurs possibles à la source, avant même que la question de la permission ne se pose.
Les permissions sont attachées à l'outil, pas au modèle. Le modèle ne « sait » pas ce qu'il a le droit de faire — il essaie, et c'est le code qui accepte ou refuse. Un agent support ne doit techniquement pas pouvoir appeler l'outil de rollback de déploiement, même s'il le mentionne dans son raisonnement : l'outil ne doit pas être dans sa liste de fonctions disponibles.
Les actions doivent être idempotentes. Un appel d'outil qui échoue à mi-chemin (timeout réseau, erreur transitoire) sera souvent retenté par l'orchestrateur. Si create_refund crée un nouvel avoir à chaque appel sans vérifier qu'un avoir identique n'existe pas déjà pour ce ticket, deux tentatives sur un incident réseau produisent deux remboursements. La solution standard est une clé d'idempotence : l'appelant transmet un identifiant unique (l'identifiant du ticket, par exemple), et l'outil garantit qu'un même identifiant ne produit l'effet qu'une seule fois.
| Cas métier | Déclencheur | Action à risque | Idempotence critique sur |
|---|---|---|---|
| Support client | Ticket entrant | Remboursement, modification d'abonnement | create_refund, cancel_subscription |
| Ops / supervision | Alerte de monitoring | Rollback, redémarrage, scaling | trigger_rollback, restart_service |
| Back-office | Document reçu | Validation de paiement, écriture ERP | post_payment, create_journal_entry |
Le point de bascule humain
Dans les trois cas, la question n'est pas « faut-il un humain dans la boucleHuman-in-the-loopIABoucle où un opérateur humain valide, corrige ou arbitre les décisions du système IA avant une action irréversible.Voir dans le glossaire ? » mais « à quel endroit précis, et sur quel critère objectif ? ». Un montant, un score de confiance d'extraction, une catégorie de service touché — le critère de bascule doit être mesurable, pas laissé à l'appréciation du modèle sur sa propre confiance. Un modèle peut se déclarer confiant à tort ; un seuil défini à l'avance sur une variable métier (montant, ancienneté du compte, criticité du service) ne dépend pas de cette auto-évaluation.
Plutôt que de choisir entre « validation systématique » et « exécution automatique », faites varier le seuil de déclenchement de la validation à mesure que la confiance dans l'agent se construit avec des données de production. Commencez avec un seuil bas (beaucoup de validations humaines), resserrez-le progressivement en observant le taux d'accord entre la proposition de l'agent et la décision humaine. C'est une mise en production graduelle, pas un choix binaire figé au lancement.
Journalisation, coûts et supervision en production
Chaque appel d'outil, qu'il aboutisse ou non, doit être journalisé avec son entrée, sa sortie, et l'identité de ce qui l'a validé (agent seul ou humain). Ce journal sert trois usages distincts : l'audit de conformité, le débogage d'un incident, et l'amélioration continue du seuil de validation évoqué plus haut.
Le coût mérite d'être surveillé dès le premier déploiement, pas après coup. Chaque itération de la boucle reason-act consomme un appel au modèle ; un ticket support qui déclenche cinq itérations avant de conclure coûte cinq fois plus qu'un ticket résolu en une itération. Un agent mal borné, qui boucle sur un outil qui échoue de façon répétée sans condition d'arrêt, peut faire exploser une facture en quelques heures avant que quiconque ne le remarque. Un nombre maximal d'itérations par exécution, avec sortie explicite (« transmis à un humain, cause : nombre d'itérations dépassé ») plutôt qu'un arrêt silencieux, est une protection élémentaire, au même titre qu'un timeout sur un appel réseau classique.
Checklist avant mise en production
- Chaque outil a un contrat de paramètres étroit, validé côté code, pas seulement décrit dans le promptpromptIAConsigne ou contexte fourni à un modèle de langage pour orienter sa réponse. La qualité du prompt conditionne souvent la qualité du résultat.Voir dans le glossaire.
- Les permissions par outil sont explicites et testées : un agent support ne peut techniquement pas appeler un outil ops.
- Les actions à effet de bord (paiement, remboursement, modification de configuration) sont idempotentes via une clé unique.
- Un seuil objectif, mesurable, détermine quelles actions passent par une validation humaine.
- Chaque appel d'outil est journalisé avec entrée, sortie et validateur.
- Un nombre maximal d'itérations par exécution est fixé, avec sortie explicite en cas de dépassement.
- Un budget de coût par exécution (ou par période) est surveillé avec alerte, pas seulement facturé a posteriori.
- Le comportement en cas d'échec d'un outil (erreur réseau, réponse invalide) est défini : retry borné, ou transmission à un humain.
Ce qu'il faut retenir
Les trois cas métier de ce chapitre n'ont en commun ni le secteur, ni les outils, ni le profil de risque. Ils partagent une architecture : une boucle qui observe avant d'agir, des outils au périmètre étroit et aux permissions explicites, une bascule humaine posée sur un critère mesurable, et une journalisation systématique. C'est cette architecture, plus que le choix du modèle, qui détermine si un déploiement d'agent tient dans la durée ou finit par produire un incident qu'aucune amélioration ultérieure du modèle n'aurait empêché.
L'essentiel à retenir
Ce chapitre applique les mécanismes vus jusqu'ici — boucle reason-act, outils, mémoire, planification, garde-fous et observabilité — à trois cas métier complets : un agent de support client, un agent d'exploitation (ops) et un agent de back-office. Chaque cas est décomposé selon son déclencheur, ses outils, son niveau de risque et son point de validation humaine. Le chapitre en tire une anatomie commune de la boucle agentique, des règles de conception d'outils (contrat, permissions, idempotence) et une checklist de mise en production. Il se conclut sur les pièges récurrents observés dans des déploiements réels : sur-permission, absence d'idempotence, boucles non bornées et confiance excessive dans un modèle plus capable.
Questions fréquentes
Faut-il toujours un humain dans la boucle pour un agent LLM en production ?
Comment éviter qu'un agent boucle indéfiniment sur un outil qui échoue ?
Quelle différence entre le RAG utilisé en support client et le function calling ?
Comment sécuriser les outils exposés à un agent contre un usage détourné ?
Quel est le coût réel d'un agent LLM en production par rapport à un appel de modèle unique ?
Comment tester un agent outillé avant de le déployer en production ?
L'agent ops peut-il déclencher un rollback sans validation humaine ?
Progression sauvegardée dans votre navigateur.
Quiz de validation
Quiz Player
Quiz de validation
Plusieurs réponses possibles — validez ensuite.
Vrai ou faux.
Quiz indisponible (données invalides).