





Playbook SOC pour incidents IA
Un cadre opérationnel pour détecter, contenir et documenter un incident impliquant un système d'IA en production, avec les runbooks et les artefacts de preuve spécifiques à ces systèmes.
Table des matières
Pourquoi un playbook générique ne suffit pas
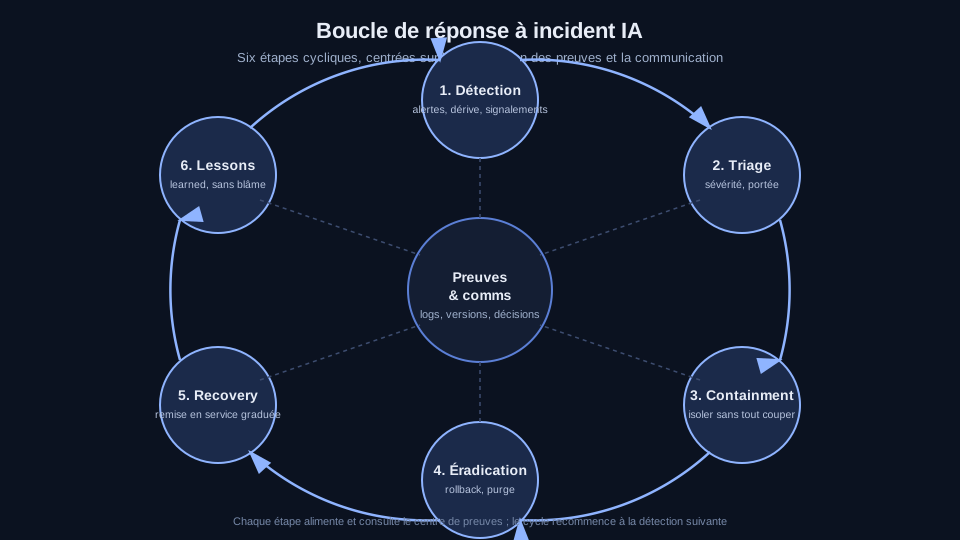
Un centre opérationnel de sécurité (SOC) sait déjà répondre à un incident : détecter, qualifier, contenir, éradiquer, restaurer, documenter. Cette boucle — souvent résumée par le cycle du NIST SP 800-61 — reste valable pour un système d'IAintelligence artificielleIAEnsemble des techniques permettant à un programme d'accomplir une tâche qui demanderait de l'intelligence humaine. Le terme couvre aussi bien les systèmes à règles écrites que ceux qui apprennent de données.Voir dans le glossaire. Ce qui change, ce sont les signaux à surveiller, les preuves à préserver et les options de containment disponibles. Un analyste habitué à isoler une machine compromise ou à révoquer un jeton d'accès se retrouve démuni face à un modèle qui a halluciné une action destructrice, ou face à une injection de promptInjection de promptCybersécuritéAttaque visant à détourner un LLM en insérant des instructions malveillantes dans le contexte (entrée utilisateur, document RAG, etc.).Voir dans le glossaire qui a fait fuiter des donnéesdonnéesIAEnsemble d'informations structurées ou non utilisées pour entraîner, évaluer ou alimenter un modèle. La qualité, la quantité et la représentativité des données sont les facteurs décisifs pour les performances en apprentissage automatique.Voir dans le glossaire sans qu'aucun malware n'ait jamais été exécuté.
La différence tient à la nature de l'attaque et de la défaillance. Un système d'IA agentique combine un modèle probabiliste, un orchestrateur, des outilstool callingIACapacité d'un agent ou d'un LLM à invoquer des outils externes (API, calcul, recherche) pendant le raisonnement.Voir dans le glossaire appelés par ce modèle et des données ingérées en continu. Une compromission ne laisse pas nécessairement de trace binaire — pas de fichier malveillant, pas de processus suspect. Elle laisse une trace textuelle : un promptpromptIAConsigne ou contexte fourni à un modèle de langage pour orienter sa réponse. La qualité du prompt conditionne souvent la qualité du résultat.Voir dans le glossaire, une réponse, une séquence d'appels d'outils. Le playbook doit donc être réécrit autour de ces artefacts-là.
Ce chapitre suppose que les défenses préventives décrites dans les chapitres précédents — architecture zero-trust, tests de sécurité, supply chain — sont déjà en place. Il traite de la réponse une fois qu'un signal d'alerte s'est déclenché malgré ces défenses. Un playbook de réponse ne remplace jamais la prévention ; il en limite les dégâts quand elle échoue.
Détection : quels signaux surveiller
Les sources de détection classiques — SIEM, EDR, journaux réseau — restent pertinentes mais insuffisantes seules. Un incident IA se manifeste souvent d'abord dans des signaux applicatifs propres au système d'IA lui-même :
- DérivedériveIADégradation progressive des performances d'un modèle après son déploiement, causée par l'évolution des comportements ou du contexte. Elle impose surveillance et réentraînement.Voir dans le glossaire comportementale : le taux de refus du modèle chute, le ton des réponses change, la longueur moyenne des sorties augmente sans changement de code — signe possible d'un changement de version amont non annoncé ou d'une manipulation du prompt système.
- Séquences d'appels d'outils inhabituelles : un agentagentIASystème qui enchaîne des appels d'outils de façon autonome pour atteindre un objectif : il planifie, agit, observe, recommence. Sa fiabilité décroît exponentiellement avec le nombre d'étapes.Voir dans le glossaire qui invoque un outil d'écriture après une série de requêtes en lecture seule, ou qui enchaîne des appels vers un domaine externe jamais vu.
- Motifs répétés dans les prompts entrants : plusieurs utilisateurs soumettent des variantes d'une même structure de texte suspecte (jailbreakJailbreakCybersécuritéTentative de contourner les garde-fous d'un LLM pour obtenir des sorties interdites ou dangereuses.Voir dans le glossaire partagé publiquement, technique d'injection en circulation).
- Volumes de sortie anormaux : une réponse contenant un volume de texte structuré (JSON, listes, blocs de code) disproportionné par rapport à la question posée, souvent le signe d'une exfiltration encodée dans la réponse.
- Signalement humain : un utilisateur ou un modérateur rapporte une réponse incohérente, dangereuse ou hors politique. C'est encore aujourd'hui la source de détection la plus fiable pour les incidents subtils, faute d'instrumentation automatisée mature.
La détection dépend entièrement de ce qui est journalisé. Si les prompts, les sorties et les appels d'outils ne sont pas conservés avec un identifiant de session et un horodatage, aucun signal ne pourra être corrélé après coup. L'investissement minimal : journaliser chaque échange (entrée, sortie, outils appelés, version de modèle) avec une rétention d'au moins 90 jours pour les usages sensibles.
Un piège fréquent : confondre absence d'alerte et absence d'incident. Un LLMLLMIAGrand modèle de langage (Large Language Model) entraîné sur d'énormes corpus pour prédire et générer du texte.Voir dans le glossaire manipulé ne génère pas d'erreur système — il produit une réponse fluide et confiante, correcte ou non. D'où l'intérêt de combiner règles de détection, tests de dérive périodiques (rejouer un jeu de prompts canoniques et comparer les sorties) et canaux de signalement humain.
Triage : classifier avant d'agir
Une fois l'alerte reçue, la première tâche est de la qualifier, pas de réagir. Le triage détermine la sévérité, la portée et l'urgence, en général sur un axe à quatre niveaux :
| Sévérité | Critère typique | Délai de réponse cible |
|---|---|---|
| Critique (S1) | Fuite de donnéesfuite de donnéesIAErreur consistant à laisser entrer dans l'entraînement une information qui n'existera pas au moment réel de la prédiction. Le modèle affiche des scores excellents puis s'effondre en production.Voir dans le glossaire sensibles confirmée, action destructrice exécutée via un outil, atteinte à la sécurité physique | Immédiat, astreinte déclenchée |
| Élevée (S2) | Injection de prompt reproductible affectant plusieurs utilisateurs, sortie dangereuse diffusée publiquement | < 4 heures |
| Modérée (S3) | Dérive comportementale isolée, jailbreak ponctuel sans propagation constatée | < 24 heures |
| Faible (S4) | Signalement isolé, cause probable non malveillante (hallucinationhallucinationIAProduction par un modèle d'un énoncé faux formulé avec la même assurance qu'un fait établi. Le phénomène est structurel : le modèle optimise la vraisemblance, pas la vérité.Voir dans le glossaire classique) | Traitement dans le backlog courant |
Le triage répond à trois questions avant toute action : le comportement est-il reproductible ? Combien de sessions sont affectées ? Y a-t-il eu une action irréversible (écriture en base, e-mail, transaction) ou seulement une réponse textuelle ? Ces réponses conditionnent le niveau de containment — inutile de couper un service entier pour un jailbreak isolé sans conséquence constatée.
Un modèle compromis ne signale jamais lui-même qu'il l'est. Si le triage s'appuie uniquement sur ce que le modèle « dit » de son propre état (« je n'ai pas accès à ces informations », « je ne peux pas faire cela »), il repose sur une source non fiable. Les décisions de sévérité doivent s'appuyer sur les journaux d'appels d'outils et les sorties effectivement produites, jamais sur les déclarations du modèle lui-même.
Containment : isoler sans tout arrêter
Le réflexe hérité de la réponse à incident classique — débrancher la machine compromise — a un équivalent tentant mais souvent disproportionné pour l'IA : couper le service entier. Ce choix a un coût métier réel et n'est justifié que pour les incidents S1. Le containment gradué offre des options intermédiaires :
- Révocation ciblée : désactiver les jetons d'accès de la session ou de l'utilisateur impliqué, sans affecter les autres utilisateurs.
- Désactivation d'un outil précis : si l'agent dispose de plusieurs outils (recherche web, exécution de code, écriture en base), retirer temporairement uniquement celui qui a été exploité, en laissant le reste du service fonctionnel.
- Rollback de version : revenir à la version de modèle ou de prompt système précédente si le comportement anormal coïncide avec un déploiement récent. C'est l'option de containment la plus fréquente en pratique, car une part importante des incidents IA suit un changement de configuration.
- Mode dégradé : basculer vers un modèle plus restreint ou vers des réponses pré-validées pour les cas d'usage sensibles, le temps de l'investigation.
- Filtrage en entrée ou en sortie : ajouter une règle de blocage temporaire sur le motif de prompt identifié, en attendant un correctif structurel.
Un agent connecté à un outil de lecture de tickets internes commence, pour certains utilisateurs, à inclure des extraits de tickets sans rapport avec la question posée. Le triage confirme une injection de prompt logée dans le corps d'un ticket, conçue pour faire lister le contenu d'autres tickets par l'agent. Le containment immédiat consiste à désactiver l'outil de lecture de tickets pour tous les agents (pas le service entier), le temps d'ajouter une étape de nettoyage du contenu ingéré. Le rollback complet du modèle n'est pas nécessaire : la faille est dans l'intégration de l'outil, pas dans le modèle.
La règle générale : contenir au niveau le plus bas qui neutralise effectivement le risque constaté. Un containment trop large interrompt un service pour des utilisateurs non affectés et génère une pression pour rétablir le service avant que l'investigation soit terminée — ce qui conduit souvent à rouvrir prématurément l'accès compromis.
Éradication : traiter la cause, pas le symptôme
L'éradication corrige la faille qui a permis l'incident, distincte du containment qui en limite l'impact. Pour l'IA, elle prend des formes sans équivalent en réponse à incident réseau classique :
- Purge de contextefenêtre de contexteIAQuantité de texte qu'un modèle peut prendre en compte simultanément : question, documents fournis et historique. Au-delà, les éléments les plus anciens sortent du champ.Voir dans le glossaire empoisonné : si l'incident provient d'un document ingéré par un pipeline RAGRAGIATechnique consistant à rechercher les documents pertinents et à les fournir au modèle dans son contexte. Elle permet des réponses à jour et citables, ce que l'affinage ne permet pas.Voir dans le glossaire, retirer ce document de l'index vectorielbase vectorielleIABase spécialisée qui indexe des embeddings pour retrouver rapidement les passages les plus proches d'une requête (cœur du RAG).Voir dans le glossaire et vérifier qu'aucun autre document du même lot ne contient un motif similaire.
- Correction du prompt système : ajouter une instruction explicite contre le motif d'attaque identifié — en sachant que cette mesure seule est fragile et doit être complétée par un filtrage structurel.
- Réentraînement ou fine-tuningFine-tuningIAAjustement des poids d'un modèle pré-entraîné sur un jeu de données spécifique pour adapter son comportement à un domaine ou une tâche cible.Voir dans le glossaire correctif : dans les cas où la dérive vient d'un ajustement de modèle (fine-tuningaffinageIAPoursuite de l'entraînement d'un modèle existant sur des données propres à un usage. Il enseigne une manière de répondre, non des connaissances fiables — d'où la préférence pour le RAG en entreprise.Voir dans le glossaire, RLHF) ayant introduit un biaisbiaisIARégularité correctement apprise dans des données qui ne représentent pas la réalité visée, ou qui enregistrent des décisions passées avec leurs préjugés. Changer d'algorithme ne le corrige pas.Voir dans le glossaire indésirable, un nouveau cycle d'entraînement correctif peut être nécessaire — option coûteuse, réservée aux incidents récurrents ou structurels.
- Durcissement des permissions d'outilsPermissions Claude CodeIAContrôles qui limitent ce que l'agent peut lire, écrire ou exécuter (shell) ; un périmètre trop large expose secrets et modifications non revues.Voir dans le glossaire : réduire la portée d'un outil (lecture seule au lieu de lecture-écriture, périmètre de données restreint) pour qu'une répétition de l'attaque ne produise plus le même impact, même si l'injection elle-même n'est pas totalement neutralisée.
Contrairement à un malware qu'on peut supprimer avec certitude, une vulnérabilité de prompt injectioninjection de requêteCybersécuritéAttaque consistant à dissimuler des instructions dans un contenu que le modèle va lire, afin de détourner son comportement. Le risque devient critique dès qu'un agent peut agir.Voir dans le glossaire ne se « patche » jamais totalement : le canal d'attaque est le langage naturel lui-même, dont l'espace des variantes est infini. L'objectif réaliste est de réduire la surface et l'impact, pas d'atteindre un état où l'attaque devient impossible.
Ce qu'il faut préserver pour l'investigation
La phase d'investigation dépend entièrement des artefacts conservés au moment de l'incident. Pour un système d'IA, la liste diffère sensiblement de celle d'un incident réseau classique :
- Le prompt exact envoyé au modèle, y compris le prompt système et tout contexte injecté (documents RAG, historique de conversation), pas seulement la question de l'utilisateur.
- La sortie brute du modèle, avant tout post-traitement ou filtrage applicatif, pour distinguer une défaillance du modèle d'une défaillance du filtre.
- La version exacte du modèle et du prompt système au moment de l'incident — nom, date de déploiement, hash de configuration si disponible.
- La séquence complète des appels d'outils, avec leurs paramètres et leurs résultats, pour un agent.
- Les paramètres d'inférenceinférenceIAUtilisation d'un modèle déjà entraîné sur une donnée nouvelle. Peu coûteuse à l'unité mais répétée à chaque requête, elle constitue le coût récurrent d'exploitation.Voir dans le glossaire (température, top-p) si le comportement peut dépendre de la stochasticité.
- L'identité et le contexte de la session (utilisateur, canal, horodatage) pour évaluer la portée.
Ces éléments doivent être extraits et archivés séparément du système en production dès le déclenchement de l'incident, avant tout rollback ou purge : un rollback exécuté avant l'archivage rend l'investigation quasiment impossible.
Point souvent négligé : la stochasticité des modèles complique la reproduction. Un comportement anormal observé une fois peut ne jamais se reproduire à l'identique, même à température nulle, si le modèle sous-jacent a changé entre-temps chez le fournisseur — d'où l'intérêt de capturer l'artefact original plutôt que de le reconstruire a posteriori.
Runbooks types
Trois scénarios couvrent une large part des incidents rencontrés en production. Chacun mérite un runbook écrit à l'avance, testé au moins une fois par un exercice de simulation.
Runbook 1 — Injection de prompt reproductible. Détection : signalement ou motif de sortie récurrent. Triage : confirmer la reproductibilité. Containment : filtrage du motif en entrée, désactivation de l'outil exploité. Éradication : durcissement du prompt système, règle de détection permanente. Recovery : réactivation graduée, surveillance renforcée 48 heures.
Runbook 2 — Dérive comportementale après déploiement. Détection : tests de régression automatisés ou plaintes groupées. Triage : comparer aux sorties d'un jeu de prompts canoniques archivé avant déploiement. Containment : rollback vers la version précédente. Éradication : analyse du changement en cause (modèle, prompt, paramètres). Recovery : nouveau déploiement après validation complète du jeu de tests.
Runbook 3 — Action destructrice exécutée par un agent. Détection : alerte sur l'outil concerné (base de données, fichiers, messagerie). Triage : S1 par défaut, quelle que soit l'ampleur apparente. Containment : révocation immédiate des permissions d'écriture, isolement de la session. Éradication : audit de la chaîne de décision ayant conduit à l'appel de l'outil. Recovery : réactivation uniquement après ajout d'une confirmation humaine pour cette catégorie d'action.
Lessons learned : la boucle qui referme le cycle
Le post-mortem d'un incident IA suit les mêmes principes qu'un post-mortem classique — factuel, chronologique, sans recherche de responsable individuel — avec un accent particulier sur deux points spécifiques à ces systèmes.
D'abord, distinguer la cause profonde de la manifestation. Une réponse dangereuse n'est presque jamais la cause : elle est le symptôme d'une absence de garde-fou en amont (validation d'entrée, permission d'outil trop large, absence de confirmation humaine). Conclure « le modèle a mal répondu » sans creuser plus loin ne produit aucune action correctrice utile.
Ensuite, documenter la reproductibilité pour l'avenir. Contrairement à un bug logiciel classique, un incident IA n'a souvent pas de correctif définitif — seulement des mesures qui réduisent la probabilité et l'impact d'une récidive. Le post-mortem doit donc inclure un jeu de tests de régression dérivé de l'incident, rejoué à chaque déploiement futur, plutôt qu'une simple case cochée « corrigé ».
La structure recommandée pour le document de post-mortem :
- Chronologie factuelle (horodatages, actions, décisions) sans interprétation.
- Impact réel constaté, distinct de l'impact potentiel.
- Cause profonde, avec la chaîne causale complète jusqu'au garde-fou manquant.
- Ce qui a bien fonctionné dans la détection et la réponse.
- Actions correctrices, chacune assignée et datée.
- Jeu de tests de régression ajouté au pipeline de déploiement.
Un incident d'injection de prompt découvert sur un agent est souvent transposable à d'autres agents de l'organisation utilisant une architecture similaire : diffuser le post-mortem, anonymisé si nécessaire, évite qu'une même classe de faille soit redécouverte indépendamment plusieurs fois.
Checklist opérationnelle
Ces éléments doivent exister avant le premier incident, pas être improvisés pendant :
- Journalisation complète des échanges (prompt, sortie, outils, version) avec rétention définie.
- Jeu de prompts canoniques archivé pour détecter la dérive après chaque déploiement.
- Matrice de sévérité adaptée aux scénarios IA, validée par les équipes sécurité et produit.
- Mécanismes de containment gradué déjà implémentés (révocation par session, désactivation par outil, rollback de version) et testés en amont, pas conçus pendant l'incident.
- Canal de signalement accessible aux utilisateurs et aux équipes internes, avec un délai de traitement affiché.
- Trois runbooks minimum rédigés et testés par simulation (injection, dérive, action destructrice).
- Modèle de post-mortem sans blâme, connu et accepté par les équipes concernées avant qu'un incident ne survienne.
Un playbook jamais testé échoue généralement au premier vrai incident — pas parce que les étapes sont mal conçues, mais parce que les outils de containment n'ont jamais été exercés et que personne ne sait qui décide d'un rollback en pleine nuit. L'exercice de simulation, même simplifié, reste la meilleure préparation disponible.
L'essentiel à retenir
Ce chapitre décrit comment un centre opérationnel de sécurité (SOC) adapte sa boucle de réponse à incident classique — détection, triage, containment, éradication, recovery, lessons learned — aux spécificités des systèmes d'IA générative et agentique. Il détaille les signaux de détection propres aux LLM (dérive, injection, exfiltration via les sorties), les options de containment qui n'imposent pas de tout arrêter, et les artefacts qu'il faut préserver pour l'investigation — prompts, sorties, versions de modèle, journaux d'appels d'outils. Il propose des runbooks types pour trois scénarios fréquents et une checklist de post-mortem sans blâme adaptée aux incidents IA.
- Boucle de réponse à incident appliquée à l'IA
- Signaux de détection spécifiques aux LLM
- Classification de sévérité d'un incident IA
- Containment gradué sans kill switch systématique
- Préservation des preuves (prompts, sorties, versions de modèle)
- Rollback et gel de version
- Post-mortem sans blâme
- Runbooks par scénario
Questions fréquentes
Faut-il couper complètement un agent IA dès le premier signal d'alerte ?
Quels logs faut-il conserver pour pouvoir enquêter sur un incident impliquant un LLM ?
Comment classer la sévérité d'un incident IA quand on ne sait pas encore combien d'utilisateurs sont affectés ?
Qu'est-ce qui différencie une hallucination classique d'un véritable incident de sécurité ?
Comment mener un post-mortem sans que l'équipe se sente accusée ?
Un rollback de version résout-il systématiquement un incident de dérive comportementale ?
À quelle fréquence faut-il tester les runbooks d'incident IA en pratique ?
Progression sauvegardée dans votre navigateur.
Quiz de validation
Quiz Player
Quiz de validation
Plusieurs réponses possibles — validez ensuite.
Vrai ou faux.
Quiz indisponible (données invalides).