





Entraînement pratique
Piloter une session de fine-tuning de bout en bout : choix des hyperparamètres, stratégie de checkpoints, et détection du sur-apprentissage avant qu'il ne dégrade le modèle en production.
Table des matières
Pourquoi ce chapitre est le plus utile
Choisir une architecture d'adaptation et préparer un jeu de donnéesdonnéesIAEnsemble d'informations structurées ou non utilisées pour entraîner, évaluer ou alimenter un modèle. La qualité, la quantité et la représentativité des données sont les facteurs décisifs pour les performances en apprentissage automatique.Voir dans le glossaire ne garantit rien : la majorité des fine-tunings ratés le sont à cause de décisions prises pendant l'entraînement lui-même, pas avant. Un learning ratevitesse d'apprentissageIAAmpleur de la correction appliquée aux poids à chaque étape d'entraînement. Trop grande, l'entraînement oscille ; trop faible, il n'en finit pas.Voir dans le glossaire mal calibré peut faire diverger un modèle en quelques centaines de pas. Une absence de checkpointing peut vous forcer à relancer douze heures de calcul pour récupérer un état perdu. Un sur-apprentissage non détecté peut produire un modèle qui excelle sur vos métriques internes et échoue en production dès qu'il rencontre une formulation légèrement différente.
Ce chapitre ne couvre pas la théorie de la descente de gradient : il couvre les décisions qu'un praticien prend réellement en lançant et en surveillant un entraînement — avec les seuils, les symptômes et les corrections qui s'appliquent concrètement.
Un entraînement de fine-tuningFine-tuningIAAjustement des poids d'un modèle pré-entraîné sur un jeu de données spécifique pour adapter son comportement à un domaine ou une tâche cible.Voir dans le glossaire ne se juge pas à la perte finale sur les données d'entraînement, mais à l'écart entre perte d'entraînement et perte de validation. C'est cet écart, pas le chiffre absolu, qui indique si le modèle généralise.
Les hyperparamètres qui comptent vraiment
Décider des hyperparamètreshyperparamètreIARéglage choisi avant l'entraînement — vitesse d'apprentissage, taille du modèle, nombre d'itérations. Il se distingue des paramètres, ajustés automatiquement pendant l'entraînement.Voir dans le glossaire n'est pas une opération académique : chacun a un effet observable sur les courbes et un symptôme d'échec typique en cas de mauvais réglage.
Le learning rate
C'est l'hyperparamètre le plus sensible. Pour un fine-tuningaffinageIAPoursuite de l'entraînement d'un modèle existant sur des données propres à un usage. Il enseigne une manière de répondre, non des connaissances fiables — d'où la préférence pour le RAG en entreprise.Voir dans le glossaire complet (full fine-tuning) sur un modèle de langagegrand modèle de langageIAModèle entraîné à prédire le token suivant d'une séquence de texte. Toutes ses capacités apparentes — résumer, traduire, coder — découlent de cette unique tâche.Voir dans le glossaire pré-entraîné, les valeurs typiques se situent entre 1e-5 et 5e-5. Pour une adaptation par LoRALoRAIAMéthode d'adaptation légère d'un LLM : seules de petites matrices de rang faible sont entraînées, ce qui réduit fortement le coût GPU par rapport au fine-tuning complet.Voir dans le glossaire, on travaille souvent dix à cent fois plus haut (1e-4 à 3e-4), parce que seule une fraction des paramètres est mise à jour et que ces matrices additionnelles partent d'une initialisation quasi nulle.
- Trop élevé : la perte oscille violemment ou diverge (elle explose au lieu de descendre) ; le modèle peut « oublier » une partie de ses capacités générales dès les premiers pas.
- Trop faible : la perte descend, mais très lentement, sans jamais atteindre un plateau satisfaisant dans le budget d'époques prévu — on confond souvent ce symptôme avec un manque de données.
La pratique standard consiste à utiliser un scheduler plutôt qu'un taux fixe : une phase de warmup (montée progressive sur 3 à 10 % des pas) suivie d'une décroissance (linéaire ou cosinus) jusqu'à la fin de l'entraînement. Le warmup évite que les premiers pas, sur des gradients encore peu informatifs, ne déstabilisent les poids.
Le batch size effectif
Le batch size réel utilisé par le modèle n'est pas toujours celui indiqué dans la configuration. Sur des GPUGPUIAProcesseur graphique parallélisant massivement les calculs matriciels ; indispensable à l'entraînement et à l'inférence des modèles de deep learning.Voir dans le glossaire à mémoire limitée, on combine un petit batch physique avec de l'accumulation de gradient : les gradients de plusieurs mini-batches sont cumulés avant la mise à jour des poids, ce qui simule un batch plus grand sans dépasser la VRAM disponible.
batch_size_effectif = batch_size_physique × accumulation_steps × nombre_gpu
Un batch effectif trop petit (moins de 8) rend l'entraînement bruité : chaque mise à jour est influencée par un échantillon non représentatif, et la perte fluctue fortement d'un pas à l'autre. Un batch trop grand (au-delà de ce que le jeu de données justifie) lisse excessivement le signal et peut nécessiter un learning rate plus élevé pour compenser.
Le nombre d'époques
Une époque correspond à un passage complet sur le jeu de données d'entraînement. Contrairement à un entraînement from scratch, un fine-tuning part d'un modèle déjà compétent : 2 à 4 époques suffisent en général pour un jeu de données de taille modeste (quelques milliers à quelques dizaines de milliers d'exemples). Au-delà, le risque de sur-apprentissage augmente fortement, car le modèle commence à mémoriser des exemples plutôt qu'à généraliser un pattern.
Multiplier les époques « pour être sûr » est l'erreur la plus fréquente chez les praticiens qui débutent en fine-tuning. Sans surveillance de la perte de validation, chaque époque supplémentaire au-delà du point optimal dégrade la capacité de généralisation, même si la perte d'entraînement continue de baisser.
Tableau récapitulatif
| Hyperparamètre | Full fine-tuning | LoRA / QLoRA | Symptôme si mal réglé |
|---|---|---|---|
| Learning rate | 1e-5 à 5e-5 | 1e-4 à 3e-4 | Divergence ou stagnation |
| Batch size effectif | 16 à 64 | 8 à 32 | Bruit excessif ou lissage |
| Époques | 1 à 3 | 2 à 5 | Sous-apprentissagesous-apprentissageIADéfaut d'un modèle trop simple pour le problème posé : il se trompe autant sur les données d'entraînement que sur les nouvelles.Voir dans le glossaire ou sur-apprentissage |
| Warmup | 3 à 10 % des pas | idem | Instabilité au démarrage |
| Weight decay | 0.01 à 0.1 | souvent 0 | Sur-apprentissage si absent |
Full fine-tuning, LoRA, QLoRA : quel impact sur l'entraînement
Le choix de la méthode d'adaptation n'est pas qu'une question de coût GPU : il change la dynamique même de l'entraînement.
En full fine-tuning, tous les poids du modèle sont mis à jour. Le risque de sur-apprentissage et d'oubli catastrophique (le modèle perd des capacités générales acquises au pré-entraînement) est plus élevé, ce qui justifie des learning rates bas et peu d'époques.
En LoRA, on injecte des matrices de rang faible dans certaines couches (typiquement les projections d'attentionattentionIAMécanisme par lequel un modèle pondère l'importance de chaque token du contexte lorsqu'il en traite un autre, quelle que soit la distance qui les sépare.Voir dans le glossaire) et seules ces matrices sont entraînées — le modèle de base reste gelé. Le nombre de paramètres entraînables chute drastiquement (souvent moins de 1 % du total), ce qui réduit mécaniquement le risque d'oubli catastrophique et permet des learning rates plus agressifs.
QLoRA ajoute une quantification du modèle de base (généralement en 4 bits) avant d'appliquer LoRA par-dessus. L'impact sur l'entraînement lui-même est limité en théorie, mais en pratique la quantification introduit un bruit numérique supplémentaire : il faut surveiller que la perte ne stagne pas à un plancher artificiellement plus haut que celui obtenu en LoRA classique.
Un rang faible (r=8) suffit pour des adaptations de style ou de format. Une tâche qui demande d'injecter des connaissances nouvelles ou un raisonnement spécifique bénéficie d'un rang plus élevé (r=32 à r=64), au prix d'un entraînement légèrement plus lent et d'un risque de sur-apprentissage plus proche de celui du full fine-tuning.
Checkpoints : sauvegarder sans tout dupliquer
Un checkpoint est un instantané complet de l'état du modèle (et souvent de l'optimiseur) à un pas donné de l'entraînement. Sans stratégie de checkpointing, deux problèmes surviennent systématiquement : l'impossibilité de revenir en arrière après une divergence tardive, et l'obligation de tout rejouer après une coupure matérielle.
Fréquence et rétention
Sauvegarder à chaque pas est inutile et coûteux en stockage ; ne sauvegarder qu'à la fin est risqué. La pratique courante consiste à checkpointer à intervalle régulier — par exemple toutes les 200 à 500 étapes, ou à chaque fin d'époque sur un petit jeu de données — et à ne conserver que les N derniers checkpoints plus le meilleur observé jusqu'ici (souvent N=3).
Le critère de sélection du meilleur checkpoint
C'est un point souvent négligé : le meilleur checkpoint n'est presque jamais le dernier. Il faut définir explicitement une métrique de sélection — en général la perte de validation, parfois une métrique métier (exactitude sur un jeu de testjeu de testIAPartie des données réservée à l'évaluation finale, à n'utiliser qu'une seule fois. Ajuster le modèle d'après ses résultats sur ce jeu lui ôte toute valeur de mesure indépendante.Voir dans le glossaire annoté, score de préférence humaine) — et sauvegarder systématiquement le checkpoint qui minimise cette métrique, indépendamment du nombre de pas déjà effectués.
Early stopping
L'arrêt anticipéarrêt anticipéIAInterruption de l'entraînement au moment où l'erreur de validation cesse de diminuer, avant qu'elle ne remonte. C'est la parade la plus simple au surapprentissage.Voir dans le glossaire consiste à interrompre l'entraînement quand la métrique de validation cesse de s'améliorer pendant un nombre défini d'évaluations consécutives (la « patience », souvent 2 à 5 évaluations). Cela évite de payer le coût de calcul d'époques supplémentaires qui ne feraient que dégrader la généralisation.
si perte_validation(pas_actuel) > min(perte_validation[derniers_N_évaluations]):
    compteur_patience += 1
    si compteur_patience >= patience_max:
        arrêter_entraînement()
        charger_meilleur_checkpoint()
sinon:
    compteur_patience = 0
    sauvegarder_checkpoint(pas_actuel)
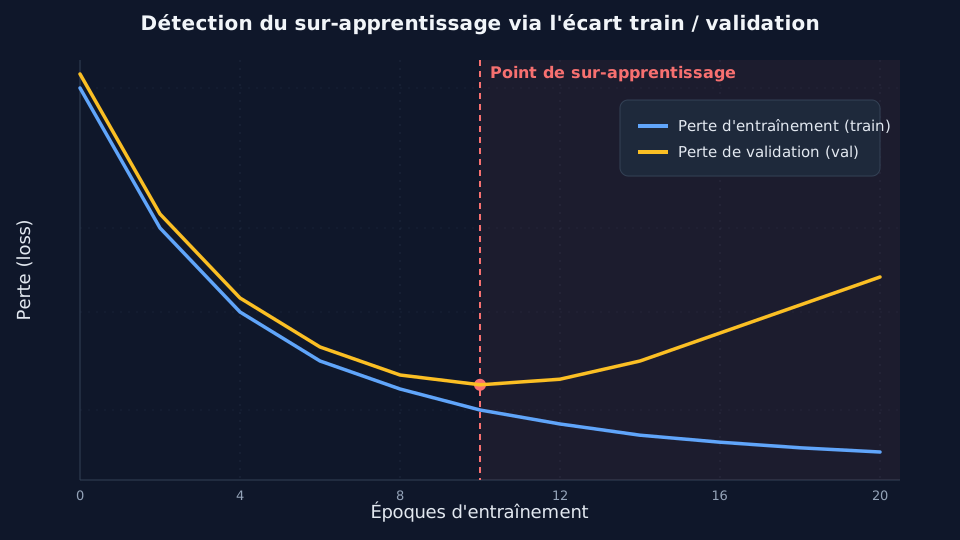
Sur un fine-tuning LoRA de 3 époques (1 500 pas), la perte de validation atteint son minimum au pas 950, puis remonte légèrement jusqu'à la fin. Sans early stopping, le modèle livré en production est celui du pas 1 500 — moins bon que celui du pas 950 sur toutes les métriques de généralisation, alors même que sa perte d'entraînement est la plus basse de tout l'entraînement.
Reconnaître le sur-apprentissage
Le sur-apprentissage (overfittingsurapprentissageIADéfaut d'un modèle qui mémorise ses exemples d'entraînement au lieu d'en dégager des régularités. Il excelle sur les données vues et échoue sur toute donnée nouvelle.Voir dans le glossaire) survient quand le modèle mémorise des particularités du jeu d'entraînement — formulations exactes, ordre des exemples, artefacts de collecte — plutôt que le pattern général qu'on cherche à lui transmettre. Il continue alors à progresser sur les données d'entraînement tout en régressant sur des données qu'il n'a jamais vues.
Le signal fiable : l'écart train/validation
Le diagnostic ne repose pas sur la valeur absolue de la perte, mais sur la divergence entre les deux courbes :
- Sain : perte d'entraînement et perte de validation baissent ensemble, avec un écart stable et faible.
- Sur-apprentissage naissant : la perte de validation ralentit puis stagne pendant que la perte d'entraînement continue de baisser.
- Sur-apprentissage avéré : la perte de validation remonte franchement pendant que la perte d'entraînement continue de baisser. L'écart croît de façon monotone.
Si les exemples de validation partagent des sources, des formulations ou des auteurs avec le jeu d'entraînement (data leakagefuite de donnéesIAErreur consistant à laisser entrer dans l'entraînement une information qui n'existera pas au moment réel de la prédiction. Le modèle affiche des scores excellents puis s'effondre en production.Voir dans le glossaire), la perte de validation peut rester basse artificiellement longtemps — le modèle a en réalité mémorisé un contenu proche plutôt qu'appris un pattern général. Toujours séparer les splits par source ou par entité avant de faire confiance à la courbe de validation.
Les leviers de correction
Quand le diagnostic est confirmé, plusieurs leviers s'appliquent, du moins coûteux au plus structurant :
- Réduire le nombre d'époques ou activer l'early stopping — correction immédiate, sans réentraînement complet si un checkpoint antérieur existe.
- Augmenter le weight decay — pénalise les poids de grande magnitude, ce qui limite la capacité du modèle à mémoriser des cas isolés.
- Ajouter du dropout dans les couches concernées, si l'architecture le permet.
- Réduire le rang LoRA — un rang plus faible réduit la capacité de mémorisation du module adaptateur.
- Augmenter ou diversifier les données — traite la cause plutôt que le symptôme : un jeu d'entraînement trop homogène ou trop petit rend le sur-apprentissage quasi inévitable, quel que soit le réglage des hyperparamètres.
- Réduire le learning rate — un taux plus bas ralentit la convergence, ce qui laisse moins d'opportunités de mémoriser avant que l'entraînement ne s'arrête.
Il faut cependant se garder d'un contre-exemple fréquent : sur un petit jeu de validation (moins de quelques centaines d'exemples), la perte de validation peut fluctuer d'une évaluation à l'autre sans tendance réelle, simplement parce que l'échantillon est trop restreint pour être statistiquement stable. Avant de conclure à un sur-apprentissage et de déclencher un des leviers ci-dessus, vérifiez la tendance sur au moins trois évaluations consécutives plutôt que sur un seul point de mesure isolé — un praticien qui réagit à chaque oscillation finit par sous-entraîner systématiquement ses modèles par excès de prudence, ce qui est tout aussi coûteux qu'un sur-apprentissage non détecté.
Journaliser pour pouvoir comparer
Un entraînement isolé, sans trace exploitable, ne permet pas d'apprendre d'une session à l'autre. Il est recommandé de consigner systématiquement, pour chaque run, la configuration complète des hyperparamètres, la courbe de perte (train et validation), le pas du meilleur checkpoint et la métrique métier associée. Cette discipline de journalisation, souvent négligée sous la pression du calendrier, est ce qui permet de répondre rapidement à la question la plus fréquente en revue de production : « pourquoi ce modèle se comporte-t-il différemment du précédent ? » Sans historique comparable, chaque régression oblige à réentraîner plusieurs variantes pour reconstituer a posteriori ce qui a changé.
Checklist de lancement d'un entraînement
Avant de lancer une session de fine-tuning, il est utile de vérifier systématiquement :
- Le split de validation est étanche (aucune fuite de source ou de formulation avec le jeu d'entraînement).
- Le learning rate et le scheduler sont adaptés à la méthode choisie (full fine-tuning vs LoRA/QLoRA).
- Le batch size effectif est documenté, y compris l'accumulation de gradient.
- La fréquence de checkpointing est définie, avec un critère explicite de sélection du meilleur checkpoint.
- Un mécanisme d'early stopping est activé, avec une patience raisonnable (2 à 5 évaluations).
- Une métrique de validation métier (pas seulement la perte) est suivie en parallèle, quand c'est possible.
- Le budget d'époques est borné, avec une hypothèse explicite sur le point de sur-apprentissage attendu.
En synthèse
Un entraînement de fine-tuning se pilote, il ne se lance pas en espérant que la configuration par défaut convienne. Le learning rate et le batch size effectif déterminent la stabilité de la convergence ; le checkpointing avec sélection sur la validation garantit qu'on ne perd jamais le meilleur état atteint ; la lecture attentive de l'écart train/validation permet d'arrêter avant que le modèle ne commence à mémoriser plutôt qu'à généraliser. Ces trois disciplines, appliquées ensemble, transforment le fine-tuning d'un pari en une procédure reproductible.
L'essentiel à retenir
Ce chapitre traite la conduite opérationnelle d'un entraînement de fine-tuning : réglage du learning rate, du batch size effectif et du nombre d'époques, choix entre full fine-tuning et adaptation par LoRA/QLoRA, et lecture des courbes de perte. Il détaille une stratégie de checkpointing (fréquence, critère de sélection, early stopping) permettant de revenir à la meilleure version du modèle sans rejouer l'entraînement. Il explique enfin comment reconnaître le sur-apprentissage tôt, le distinguer d'un simple bruit de mesure, et les leviers pour le corriger (régularisation, données, taille du modèle adapté). Le lecteur repart avec une checklist de lancement et une grille de diagnostic des courbes.
Questions fréquentes
Quel learning rate choisir pour un premier fine-tuning LoRA ?
Combien d'époques faut-il pour un fine-tuning ?
Comment savoir si mon modèle sur-apprend vraiment ou si c'est juste du bruit ?
Faut-il sauvegarder un checkpoint à chaque étape d'entraînement ?
Quelle différence pratique entre LoRA et QLoRA pour l'entraînement ?
Le weight decay est-il utile en LoRA ?
Comment choisir la patience pour l'early stopping ?
Progression sauvegardée dans votre navigateur.
Quiz de validation
Quiz Player
Quiz de validation
Plusieurs réponses possibles — validez ensuite.
Vrai ou faux.
Quiz indisponible (données invalides).