





Métriques produit IA
Comment construire un système de mesure pour un produit IA en s'appuyant sur trois familles de signaux : activation, qualité perçue et rétention.
Table des matières
Pourquoi ce chapitre est le plus utile
Un POC convaincant en démo ne dit presque rien de la façon dont un produit IAintelligence artificielleIAEnsemble des techniques permettant à un programme d'accomplir une tâche qui demanderait de l'intelligence humaine. Le terme couvre aussi bien les systèmes à règles écrites que ceux qui apprennent de données.Voir dans le glossaire se comportera en production, face à des utilisateurs réels qui ne suivent pas le script de la démonstration. La question qui détermine la suite du projet n'est pas « est-ce que le modèle fonctionne ? » mais « est-ce que les utilisateurs reviennent, et pourquoi ceux qui partent sont-ils partis ? ». Répondre à cette question exige un système de mesure conçu spécifiquement pour les produits génératifs — les tableaux de bord SaaS classiques, hérités du monde des applications déterministes, passent à côté des défaillances qui tuent l'adoption d'un produit IA.
Un produit IA se pilote avec trois familles de métriques, dans un ordre strict de dépendance : l'activationfonction d'activationIAOpération non linéaire appliquée en sortie d'un neurone. Sans elle, empiler des couches serait inutile : une succession d'opérations linéaires reste équivalente à une seule.Voir dans le glossaire conditionne la possibilité même d'observer la qualité perçue, et la qualité perçue conditionne la rétention. Optimiser la rétention sans avoir d'abord validé l'activation revient à traiter un symptôme en ignorant sa cause.
Ce chapitre décrit chacune de ces trois familles, les signaux concrets qui les composent, et les erreurs de mesure les plus courantes observées lors du passage du POC au produit en production.
Le piège des métriques génériques
Les équipes produit qui abordent l'IA générative pour la première fois réutilisent naturellement les métriques qu'elles maîtrisent déjà : taux de conversion, DAU/MAU, NPS, temps passé sur l'application. Ces indicateurs ne sont pas inutiles, mais ils sont insuffisants, et parfois trompeurs, pour un produit dont le cœur fonctionnel est probabiliste.
Trois raisons expliquent cette inadéquation.
D'abord, le temps passé n'est pas un signal univoque. Dans une application classique, plus de temps passé signale généralement plus d'engagement. Dans un produit IA, un temps de session élevé peut aussi bien signifier qu'un utilisateur reformule sa requête cinq fois parce que les premières réponses étaient inexploitables. Le même chiffre encode deux réalités opposées.
Ensuite, le taux de conversion classique mesure un passage binaire (inscrit → payant), alors que la valeur d'un produit IA se construit progressivement, réponse après réponse, avec des micro-évaluations que l'utilisateur fait en permanence sans les exprimer explicitement.
Enfin, le NPS et les enquêtes de satisfaction déclarative captent une impression globale, généralement biaisée par les interactions les plus récentes ou les plus mémorables, et non par la qualité moyenne réelle du service rendu sur l'ensemble des requêtes.
Une hausse du temps de session ou du nombre de messages échangés n'est jamais, à elle seule, une bonne nouvelle dans un produit conversationnel. Elle doit systématiquement être croisée avec un indicateur de qualité (taux de reformulation, taux d'abandon de conversation) avant d'être interprétée comme un signe d'engagement positif.
C'est pourquoi un produit IA a besoin de métriques propres, construites autour de trois moments critiques du parcours utilisateur.
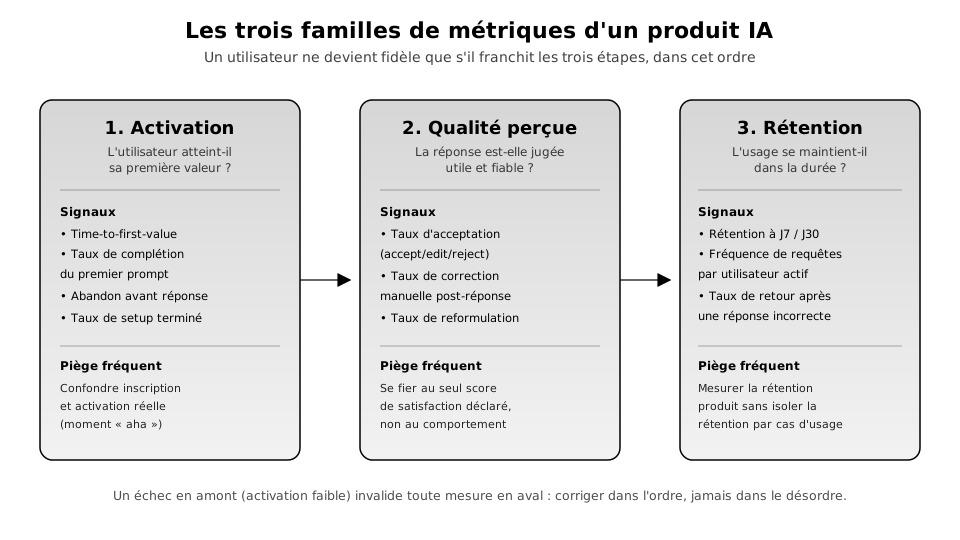
Activation : le premier moment de valeur
L'activation mesure si un utilisateur atteint, lors de sa première session, un moment où le produit lui a rendu un service concret et perceptible. Ce n'est pas la création de compte, ni le premier message envoyé : c'est le premier moment où l'utilisateur obtient quelque chose qu'il n'aurait pas obtenu sans le produit.
Les signaux les plus fiables pour mesurer l'activation :
- Time-to-first-value (TTFV) — durée entre le début de la session et le premier résultat jugé utile. Ce jugement n'a pas besoin d'être déclaratif : une action de copie, de téléchargement ou de partage du résultat est un signal comportemental suffisant.
- Taux de complétion du premier promptpromptIAConsigne ou contexte fourni à un modèle de langage pour orienter sa réponse. La qualité du prompt conditionne souvent la qualité du résultat.Voir dans le glossaire — proportion d'utilisateurs qui vont jusqu'à recevoir une réponse complète, sans quitter la page pendant la génération.
- Taux d'abandon avant réponse — utilisateurs qui ferment l'application ou changent d'onglet avant que le modèle n'ait terminé de répondre. Un taux élevé pointe presque toujours vers un problème de latence perçue plutôt qu'un problème de qualité.
- Taux de setup terminé — pour les produits nécessitant une configuration initiale (connexion à une source de donnéesdonnéesIAEnsemble d'informations structurées ou non utilisées pour entraîner, évaluer ou alimenter un modèle. La qualité, la quantité et la représentativité des données sont les facteurs décisifs pour les performances en apprentissage automatique.Voir dans le glossaire, choix d'un modèle, import de documents pour du RAGRAGIATechnique consistant à rechercher les documents pertinents et à les fournir au modèle dans son contexte. Elle permet des réponses à jour et citables, ce que l'affinage ne permet pas.Voir dans le glossaire), proportion d'utilisateurs qui terminent cette étape.
Une équipe ayant lancé un assistant de rédaction interne a observé un taux d'abandon de 38 % avant réception de la première réponse. L'hypothèse initiale était un problème de pertinence des réponses. L'instrumentation a révélé que le temps de génération médian dépassait 22 secondes sans aucun indicateur de progression affiché à l'écran. L'ajout d'un flux de tokenstokenIAFragment de texte manipulé par un modèle de langage, généralement plus court qu'un mot — trois à quatre caractères en français. La tarification et la limite de contexte se comptent en tokens.Voir dans le glossaire en streaming a fait chuter l'abandon à 6 % sans modifier le modèle sous-jacent.
Cet exemple illustre un principe général : une bonne partie des défaillances d'activation d'un produit IA ne provient pas du modèle, mais de l'expérience d'attente qui l'entoure. Avant d'investiguer la qualité des réponses, il faut éliminer les causes d'abandon liées à la latence, à l'absence de retour visuel, ou à un onboarding trop long.
Qualité perçue : mesurer sans se fier aux déclarations
Une fois l'activation validée, la question suivante est celle de la qualité perçue : l'utilisateur juge-t-il les réponses suffisamment fiables et utiles pour continuer à les solliciter ? Cette qualité ne se mesure pas en interrogeant directement l'utilisateur — les enquêtes de satisfaction souffrent d'un taux de réponse faible et d'un biaisbiaisIARégularité correctement apprise dans des données qui ne représentent pas la réalité visée, ou qui enregistrent des décisions passées avec leurs préjugés. Changer d'algorithme ne le corrige pas.Voir dans le glossaire de désirabilité qui gonfle artificiellement les scores. Il faut s'appuyer sur des signaux comportementaux, produits automatiquement par l'usage normal du produit.
Le signal le plus robuste est le taux d'acceptation, décliné en trois issues possibles pour chaque réponse générée :
- accept — l'utilisateur utilise la réponse telle quelle (copie, envoi, validation sans modification) ;
- edit — l'utilisateur modifie la réponse avant de l'utiliser (signal de qualité partielle, à surveiller de près) ;
- reject — l'utilisateur ignore la réponse, la régénère, ou reformule complètement sa requête.
Ce triptyque donne une lecture bien plus fine qu'un simple pouce levé/baissé, parce qu'il capture la zone grise — la majorité des usages réels d'un produit IA en entreprise — où la réponse est utile mais nécessite un ajustement humain.
D'autres signaux complètent ce tableau :
- Taux de reformulation — proportion de requêtes suivies d'une nouvelle requête très proche dans les 60 secondes, signe que la première réponse n'a pas satisfait le besoin.
- Taux de correction manuelle post-réponse, pour les produits qui laissent une trace de l'usage final (un document exporté, un ticket créé) : à quelle fréquence le contenu généré est-il modifié avant d'être utilisé réellement ?
- Taux d'escalade humaine, dans les produits avec un canal de support ou de validation, quand la réponse générée est jugée insuffisante et transmise à un humain.
Le taux accept/edit/reject peut être capturé sans bouton de vote explicite, en observant les actions naturelles de l'utilisateur : une réponse copiée sans modification équivaut à un accept implicite, une réponse suivie d'une édition dans le presse-papiers avant collage équivaut à un edit implicite. Cette instrumentation passive réduit la charge cognitive imposée à l'utilisateur et évite le biais de non-réponse des systèmes de vote actifs, dont le taux de sollicitation dépasse rarement 5 % des interactions.
Les produits conversationnels purs, sans document exporté ni action déclenchée dans un système tiers, doivent s'appuyer davantage sur le taux de reformulation et la longueur des conversations. Une conversation qui s'arrête après un seul échange peut signaler soit une résolution rapide et satisfaisante, soit un abandon — la distinction se fait en croisant ce signal avec le retour de l'utilisateur à J+1.
La qualité perçue doit systématiquement être segmentée par cas d'usage, et non agrégée globalement. Un produit qui traite à la fois des questions factuelles simples et des tâches de synthèse complexes affichera un taux d'acceptation global qui masque des écarts de performance considérables entre ces deux catégories. Un taux d'acceptation moyen de 70 % peut recouvrir 95 % sur les questions simples et 40 % sur les tâches complexes — deux réalités produit qui appellent des actions différentes.
Rétention : la métrique qui juge tout le reste
La rétention est la métrique la plus tardive à se manifester, mais c'est celle qui valide (ou invalide) l'ensemble des hypothèses produit. Un taux d'activation excellent et une qualité perçue satisfaisante ne garantissent pas la rétention si le produit ne s'inscrit pas dans une habitude ou un flux de travail récurrent.
Les signaux à suivre :
- Rétention à J7 et J30 — proportion d'utilisateurs actifs à l'activation qui reviennent utiliser le produit sept puis trente jours après leur première session.
- Fréquence de requêtes par utilisateur actif, sur une fenêtre glissante de 7 jours, pour distinguer un usage installé d'un usage exploratoire ponctuel.
- Taux de retour après une réponse incorrecte — parmi les utilisateurs ayant explicitement rejeté une réponse, quelle proportion revient utiliser le produit dans les jours suivants ? Ce signal mesure la tolérance à l'erreur du produit, un indicateur souvent plus révélateur que le taux d'erreur brut.
- Rétention par cas d'usage — un produit multi-usages peut afficher une rétention globale correcte alors qu'un seul cas d'usage porte l'essentiel du réengagement, les autres n'étant essayés qu'une fois.
Calculer une rétention produit unique avant de l'avoir décomposée par cas d'usage conduit systématiquement à des décisions erronées. Une équipe peut investir des mois à améliorer un cas d'usage qui ne représente que 10 % de la base active, en se fiant à un chiffre agrégé qui ne reflète en réalité que le comportement du cas d'usage dominant.
Étude de cas : un problème de rétention qui n'en était pas un
Une équipe produit avait mis en place un tableau de bord centré sur la rétention à J30, jugée décevante à 12 % après trois mois de lancement. Les hypothèses initiales portaient sur la qualité des réponses : le modèle était-il assez précis, fallait-il l'affiner sur des données spécifiques au métier ?
En décomposant les données par étape du parcours, l'équipe a découvert que le taux d'activation réel — mesuré par le TTFV — n'était que de 34 %. Deux tiers des nouveaux utilisateurs n'atteignaient jamais un premier résultat exploitable, principalement parce que l'étape de configuration initiale (connexion d'une source de données) comportait une friction technique non documentée. Ces utilisateurs n'avaient donc jamais eu l'occasion de juger la qualité des réponses, et leur non-retour à J30 n'avait rien à voir avec le modèle.
Après correction de l'étape de configuration, le taux d'activation est passé à 71 %, et la rétention à J30 — mesurée seulement sur les utilisateurs activés — s'est révélée être de 44 %, un chiffre nettement plus proche des standards du secteur. Le problème n'était jamais un problème de qualité de modèle ; c'était un problème d'activation qui contaminait toutes les métriques en aval.
Cette étude de cas illustre une règle générale de diagnostic : toujours vérifier l'activation avant d'investiguer la rétention. Une rétention faible avec une activation faible pointe vers l'onboarding. Une rétention faible avec une activation forte et une qualité perçue faible pointe vers le modèle ou le prompt. Une rétention faible avec une activation forte et une qualité perçue forte pointe vers un problème d'intégration dans le flux de travail de l'utilisateur, indépendant de la performance du produit lui-même.
Construire un tableau de bord cohérent
Le tableau suivant résume les trois familles de métriques, leurs signaux principaux, et la fréquence de suivi recommandée.
| Famille | Signal principal | Fréquence | Question posée |
|---|---|---|---|
| Activation | Time-to-first-value | Quotidienne | L'utilisateur atteint-il une première valeur ? |
| Activation | Taux d'abandon avant réponse | Quotidienne | La latence perçue fait-elle fuir les utilisateurs ? |
| Qualité perçue | Taux accept/edit/reject | Hebdomadaire | La réponse est-elle utilisable telle quelle ? |
| Qualité perçue | Taux de reformulation | Hebdomadaire | La première réponse a-t-elle répondu au besoin ? |
| Rétention | Rétention J7 / J30 par cas d'usage | Mensuelle | L'usage devient-il une habitude ? |
| Rétention | Taux de retour après rejet | Mensuelle | Le produit tolère-t-il ses propres erreurs ? |
Ce tableau de bord doit être lu dans l'ordre : un signal d'activation dégradé rend les signaux de qualité perçue et de rétention difficiles à interpréter, puisque la population observée à ces étapes ultérieures est biaisée par les utilisateurs qui ont survécu à l'activation.
Checklist avant de lancer un dashboard produit IA
- Chaque événement d'activation (TTFV, complétion, abandon) est-il instrumenté au niveau de la session, pas seulement au niveau du compte ?
- Le taux accept/edit/reject est-il capturé de façon passive, sans dépendre d'un vote explicite à faible taux de réponse ?
- Les métriques de qualité perçue sont-elles segmentées par cas d'usage, et pas seulement agrégées ?
- La rétention est-elle calculée séparément pour les utilisateurs activés et pour l'ensemble des inscrits ?
- Existe-t-il un signal de latence perçue distinct du temps de génération technique mesuré côté serveur ?
- Le tableau de bord distingue-t-il explicitement les trois familles de métriques, plutôt que de les mélanger dans une vue unique ?
- Une revue de ces métriques est-elle planifiée avant, et non après, le passage à l'échelle du produit ?
Ce qu'il faut retenir
Un produit IA se pilote avec un système de mesure qui lui est propre, structuré autour de trois questions séquentielles : l'utilisateur atteint-il une première valeur, juge-t-il les réponses fiables, et revient-il durablement ? Ignorer l'ordre de dépendance entre ces trois familles — en investiguant la rétention avant d'avoir validé l'activation, par exemple — conduit à des diagnostics erronés et à des investissements mal ciblés. Les métriques génériques héritées du SaaS classique restent utiles en complément, mais ne suffisent jamais à elles seules à comprendre pourquoi un produit génératif est adopté, toléré, ou abandonné.
L'essentiel à retenir
Ce chapitre présente les trois familles de métriques indispensables pour piloter un produit IA après le POC : l'activation (l'utilisateur atteint-il une première valeur ?), la qualité perçue (la réponse est-elle jugée fiable et utile ?) et la rétention (l'usage se maintient-il dans la durée ?). Il détaille pourquoi les métriques SaaS classiques échouent à capturer les défaillances spécifiques d'un produit génératif, et propose des signaux de substitution mesurables sans enquête déclarative. Une étude de cas illustre comment une équipe a diagnostiqué un problème de rétention en réalité causé par une activation défaillante. Le chapitre se termine par une checklist opérationnelle pour construire un tableau de bord cohérent avant un lancement en production.
Questions fréquentes
Quelle est la différence entre activation et simple inscription ?
Faut-il utiliser un système de vote pouce levé / pouce baissé pour mesurer la qualité perçue ?
Comment savoir si un problème de rétention vient du modèle ou de l'onboarding ?
Les métriques SaaS classiques comme le NPS sont-elles inutiles pour un produit IA ?
À quelle fréquence faut-il revoir ces métriques une fois le produit lancé ?
Peut-on mesurer la qualité perçue sans avoir de document ou d'action finale tracable dans le produit ?
Progression sauvegardée dans votre navigateur.
Quiz de validation
Quiz Player
Quiz de validation
Plusieurs réponses possibles — validez ensuite.
Vrai ou faux.
Quiz indisponible (données invalides).