





UX de confiance
Concevoir l'interface qui entoure un modèle de langage — citations, expression de l'incertitude et contrôle utilisateur — pour qu'un produit IA reste exploitable même quand le modèle se trompe.
Table des matières
Pourquoi ce chapitre est le plus utile
Un produit IAintelligence artificielleIAEnsemble des techniques permettant à un programme d'accomplir une tâche qui demanderait de l'intelligence humaine. Le terme couvre aussi bien les systèmes à règles écrites que ceux qui apprennent de données.Voir dans le glossaire ne se distingue pas de ses concurrents par la qualité brute du modèle qu'il embarque — la plupart des équipes ont accès aux mêmes familles de modèles, avec des écarts de performance qui se resserrent version après version. Ce qui distingue un produit qu'on continue d'utiliser d'un produit qu'on abandonne après deux semaines, c'est la façon dont l'interface gère les moments où le modèle se trompe, hésite, ou sort de son périmètre de compétence.
L'UX de confiance n'est pas une couche de vernis éthique ajoutée après coup. C'est une décision de conception qui détermine si un utilisateur peut détecter une erreur avant qu'elle ne produise un effet, et s'il peut revenir en arrière quand c'est le cas. Sans cette couche, chaque hallucinationhallucinationIAProduction par un modèle d'un énoncé faux formulé avec la même assurance qu'un fait établi. Le phénomène est structurel : le modèle optimise la vraisemblance, pas la vérité.Voir dans le glossaire non détectée coûte de la confiance utilisateur, et la confiance se reconstruit beaucoup plus lentement qu'elle ne se perd.
Ce chapitre part d'un principe simple : le modèle continuera à halluciner, mal évaluer sa propre certitude, et parfois agir de façon incorrecte sur des actions automatisées. Aucune amélioration de modèle ne rend cette réalité négligeable au point de se passer de garde-fous côté interface. La question de conception n'est donc pas « comment empêcher l'erreur » mais « comment structurer l'interaction pour que l'erreur reste visible, contestable et réversible ».
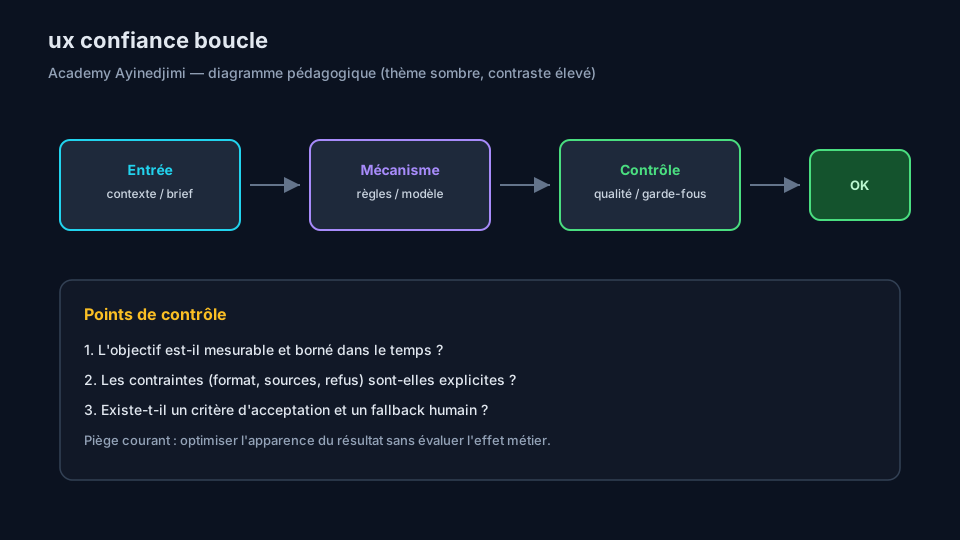
Le triangle citations / incertitude / contrôle
Trois leviers reviennent dans la quasi-totalité des produits IA qui ont réussi à installer une relation de confiance durable avec leurs utilisateurs :
- Citer les sources — permettre à l'utilisateur de vérifier une affirmation sans devoir refaire la recherche lui-même.
- Exprimer l'incertitude — signaler, au niveau le plus fin possible, ce que le système sait avec assurance et ce qu'il avance avec réserve.
- Donner le contrôle — s'assurer qu'aucune action à conséquence réelle ne s'exécute sans un point de validation adapté au niveau de risque.
Ces trois leviers ne sont pas interchangeables. Un produit qui cite ses sources mais n'offre aucun contrôle sur les actions automatisées reste dangereux. Un produit qui affiche un contrôle strict sur tout, y compris les opérations sans risque, devient inutilisable par excès de friction. La conception consiste à doser ces trois leviers selon le contextefenêtre de contexteIAQuantité de texte qu'un modèle peut prendre en compte simultanément : question, documents fournis et historique. Au-delà, les éléments les plus anciens sortent du champ.Voir dans le glossaire d'usage, pas à en maximiser un seul.
Citer ses sources sans mentir sur leur fiabilité
La citation résout un problème précis : elle transforme une affirmation invérifiable en affirmation vérifiable en un clic. Elle ne rend pas l'affirmation vraie — elle donne à l'utilisateur les moyens de juger lui-même.
Trois niveaux de rigueur, du plus faible au plus solide :
- Citation décorative — un lien générique vers « la documentation » ou « le web », sans lien direct entre l'affirmation et l'extrait source. Ce niveau donne une fausse impression de traçabilité : l'utilisateur clique, ne retrouve pas l'information précise, et perd confiance plus vite que s'il n'y avait eu aucune citation.
- Citation localisée — chaque affirmation renvoie vers le passage exact du document source (ancre de paragraphe, surlignage, numéro de page). C'est le niveau minimal acceptable pour un produit qui s'appuie sur du RAGRAGIATechnique consistant à rechercher les documents pertinents et à les fournir au modèle dans son contexte. Elle permet des réponses à jour et citables, ce que l'affinage ne permet pas.Voir dans le glossaire (retrieval-augmented generation) en contexte professionnel.
- Citation contrainte à la génération — l'architecture empêche techniquement le modèle de produire une affirmation sans passage source associé (génération conditionnée sur les extraits récupérés, avec rejet ou reformulation si aucun passage ne supporte l'énoncé). Ce niveau réduit fortement les hallucinations non détectées, sans les éliminer.
Un cabinet déploie un assistant qui répond à des questions de procédure en citant le code applicable. En version 1, les citations pointent vers l'article général (« Code de commerce »). En version 2, chaque citation pointe vers l'alinéa précis avec la date de dernière modification du texte. Le taux de vérification manuelle par les juristes chute de 80 % à 20 % entre les deux versions — non pas parce que le modèle s'est amélioré, mais parce que le coût de vérification a été divisé par quatre.
Un piège fréquent : citer une source réelle pour une affirmation qu'elle ne soutient pas réellement. C'est pire qu'une absence de citation, car cela donne une fausse impression de robustesse. Un test de non-régression utile consiste à vérifier, sur un échantillon, que chaque passage cité contient effectivement l'information annoncée — pas seulement qu'il existe.
Exprimer l'incertitude : au-delà du disclaimer générique
La plupart des produits IA affichent un avertissement générique unique (« Les réponses peuvent contenir des erreurs ») en pied de page ou en première utilisation. Ce disclaimer a un effet réel la première fois qu'il est lu, puis devient invisible par habituation. Au bout de quelques sessions, il ne modifie plus le comportement de l'utilisateur.
Un avertissement générique affiché une seule fois transfère la responsabilité juridique vers l'utilisateur sans réellement l'aider à repérer les affirmations à risque. Si l'objectif est d'éviter les erreurs d'usage — pas seulement de se couvrir contractuellement — l'incertitude doit être exprimée au niveau de l'affirmation, pas au niveau du produit.
Des alternatives plus efficaces, du plus simple au plus coûteux à implémenter :
| Approche | Ce qu'elle apporte | Coût d'implémentation |
|---|---|---|
| Disclaimer global unique | Couverture minimale, effet nul après la première lecture | Très faible |
| Distinction visuelle « fait sourcé » vs « synthèse du modèle » | Permet à l'utilisateur de repérer les zones à vérifier en priorité | Faible à moyen |
| Score de confiance par section ou par affirmation | Priorise l'attentionattentionIAMécanisme par lequel un modèle pondère l'importance de chaque token du contexte lorsqu'il en traite un autre, quelle que soit la distance qui les sépare.Voir dans le glossaire de vérification sur les passages les plus fragiles | Moyen, nécessite calibration |
| Formulation verbale calibrée (« probablement », « à confirmer », « je ne trouve pas de source fiable pour cette partie ») | Transmet l'incertitude dans le langage naturel, sans élément d'interface supplémentaire | Moyen, dépend du promptpromptIAConsigne ou contexte fourni à un modèle de langage pour orienter sa réponse. La qualité du prompt conditionne souvent la qualité du résultat.Voir dans le glossaire et du modèle |
Un score de confiance affiché sans calibration préalable est pire qu'utile : s'il annonce 90 % de confiance sur des réponses fausses une fois sur trois, les utilisateurs apprennent vite à l'ignorer complètement, y compris quand il est fiable. Avant de l'afficher en production, testez la corrélation entre le score et le taux d'erreur réel sur un échantillon annoté manuellement. Un score mal calibré doit rester en interne tant qu'il n'a pas été validé.
La formulation verbale calibrée mérite une attention particulière parce qu'elle ne nécessite aucun composant d'interface nouveau. Elle repose sur l'instruction donnée au modèle de distinguer explicitement ce qui est sourcé de ce qui relève d'une inférenceinférenceIAUtilisation d'un modèle déjà entraîné sur une donnée nouvelle. Peu coûteuse à l'unité mais répétée à chaque requête, elle constitue le coût récurrent d'exploitation.Voir dans le glossaire ou d'une extrapolation. Cette distinction fonctionne mieux quand elle est renforcée par la structure du prompt système que par une simple consigne isolée — un modèle correctement cadré signale plus fiablement ses propres limites qu'un modèle laissé libre de choisir son registre.
Le contrôle utilisateur comme filet de sécurité
Citer les sources et exprimer l'incertitude aident l'utilisateur à juger une réponse. Cela ne suffit pas dès que le produit exécute des actions à la place de l'utilisateur — envoi d'un message, modification d'un enregistrement, déclenchement d'un paiement, publication de contenu. Dans ces cas, le contrôle devient le dernier rempart contre une erreur non détectée.
Le principe central : la friction imposée à l'utilisateur doit être proportionnelle au risque et à l'irréversibilité de l'action, pas uniforme.
- Actions à risque nul ou réversibles instantanément (reformuler un brouillon, filtrer une liste) — aucune confirmation nécessaire, l'utilisateur peut annuler en un geste.
- Actions à risque modéré et réversibles avec effort (envoyer un brouillon d'email interne, modifier une fiche produit) — aperçu avant validation, undo disponible pendant une fenêtre de temps définie.
- Actions à risque élevéhaut risqueConformitéCatégorie de l'AI Act regroupant les usages soumis à conditions strictes : recrutement, crédit, éducation, infrastructures critiques. Elle impose documentation, examen des biais et contrôle humain effectif.Voir dans le glossaire ou difficilement réversibles (paiement, suppression définitive, envoi externe à un client, publication publique) — confirmation explicite avec récapitulatif de l'action précise, jamais de validation groupée silencieuse.
Pour toute action qui modifie un état existant, afficher un diff — ce qui change, précisément, par rapport à l'état actuel — est presque toujours supérieur à une description en langage naturel de l'action prévue. Un utilisateur repère une erreur beaucoup plus vite dans un différentiel visuel que dans un paragraphe qui résume l'intention.
Un contre-exemple fréquent : un agentagentIASystème qui enchaîne des appels d'outils de façon autonome pour atteindre un objectif : il planifie, agit, observe, recommence. Sa fiabilité décroît exponentiellement avec le nombre d'étapes.Voir dans le glossaire qui exécute une chaîne de plusieurs actions (rechercher, rédiger, envoyer) avec un unique point de confirmation en début de chaîne. L'utilisateur valide l'intention générale sans voir le contenu final réellement produit à l'étape d'envoi. Ce pattern économise un clic, mais déplace le risque exactement là où la vérification humaine est censée intervenir. La confirmation doit porter sur l'action irréversible elle-même, pas sur l'intention qui l'a précédée de plusieurs étapes.
Patterns d'interface concrets
Quelques patterns récurrents, avec leur cas d'usage principal :
- Surlignage source-affirmation — survoler ou cliquer une phrase générée met en évidence le passage source correspondant. Utile pour la lecture rapide de documents longs générés à partir de sources multiples.
- Badge de statut de vérification — indicateur visuel distinguant « sourcé et vérifié », « sourcé mais non vérifié », « généré sans source identifiée ». Utile dans les outilstool callingIACapacité d'un agent ou d'un LLM à invoquer des outils externes (API, calcul, recherche) pendant le raisonnement.Voir dans le glossaire de rédaction assistée où plusieurs types de contenu se mélangent dans un même document.
- Aperçu avant envoi — état final exact d'une action visible avant validation, notamment pour tout ce qui part vers un tiers externe (email, message, publication).
- Historique réversible — journal des actions effectuées par l'agent avec possibilité de rollback ciblé, pas seulement un undo global qui annule tout depuis le dernier point de contrôle.
- Mode « brouillon obligatoire » — pour les actions les plus sensibles, le système ne peut produire qu'un brouillon, jamais l'exécution directe, quelle que soit la formulation de la demande initiale.
Ces patterns coûtent du temps de développement et ajoutent de la complexité d'interface. Le choix de les implémenter ou non devrait suivre la matrice risque × fréquence : les actions fréquentes et à faible risque justifient un investissement en fluidité (moins de friction), les actions rares et à fort risque justifient un investissement en garde-fous (plus de friction), et le pire choix de conception consiste à traiter les deux catégories de façon identique.
Anti-patterns fréquents
- Confirmation systématique sur tout — à force de demander une validation pour chaque micro-action, l'utilisateur développe un réflexe de clic automatique sans lecture. La confirmation perd alors sa fonction protectrice exactement sur les actions où elle importait le plus.
- Confiance affichée non calibrée — un pourcentage de confiance qui ne reflète aucune mesure réelle de fiabilité induit une fausse sécurité, ce qui est souvent pire que l'absence totale d'indicateur.
- Citations qui ne mènent nulle part — lien mort, ancre absente, ou source qui ne contient pas réellement l'information citée. Chaque occurrence détectée par un utilisateur érode la confiance sur l'ensemble du produit, pas seulement sur la réponse concernée.
- Undo qui n'annule pas réellement l'effet — un bouton « annuler » qui masque l'action dans l'interface sans annuler ses effets côté serveur (email déjà parti, webhook déjà déclenché) crée une illusion de réversibilité dangereuse.
- Disclaimer comme seule mesure de sécurité — traiter l'avertissement textuel comme suffisant pour couvrir tous les niveaux de risque, y compris les actions automatisées à fort impact.
Checklist avant mise en production
- Chaque affirmation sourcée renvoie-t-elle vers un passage précis, pas vers un document entier ?
- Le score ou la formulation de confiance a-t-il été calibré sur un échantillon annoté, et pas seulement conçu intuitivement ?
- Les actions irréversibles disposent-elles toutes d'un point de confirmation explicite portant sur le contenu final exact ?
- Un utilisateur peut-il distinguer, en un coup d'œil, ce qui est sourcé de ce qui relève d'une synthèse du modèle ?
- L'undo annule-t-il réellement l'effet côté serveur, ou seulement son affichage ?
- La friction d'interface est-elle proportionnelle au risque réel de chaque action, ou uniforme par confort de développement ?
- Existe-t-il un canal de signalement d'erreur qui réinjecte le retour utilisateur dans l'amélioration du système ?
Cette liste n'est pas exhaustive et doit être adaptée au domaine d'application — un produit médical ou financier impose des seuils de rigueur plus élevés qu'un outil de brainstorming créatif. Mais dans tous les cas, l'absence de réponse à l'une de ces questions signale un point de risque identifié, pas résolu.
Ce qu'il faut retenir
L'UX de confiance n'élimine pas les erreurs du modèle — elle change ce qu'il se passe quand une erreur survient. Un produit bien conçu transforme une hallucination non détectée, potentiellement coûteuse, en une hallucination détectée à temps, avec un coût de correction minime. C'est cette transformation, plus que la performance brute du modèle sous-jacent, qui détermine si un produit IA reste utilisé après la phase de découverte initiale.
L'essentiel à retenir
Ce chapitre traite l'UX de confiance comme un problème de conception d'interface, pas comme une question éthique abstraite. Il détaille trois leviers concrets : citer les sources de façon vérifiable, exprimer l'incertitude au niveau de l'affirmation plutôt qu'en disclaimer global, et donner à l'utilisateur les moyens de valider, corriger ou annuler avant tout effet réel. Des patterns d'interface concrets (diffs, prévisualisations, confirmations à friction variable) et des anti-patterns fréquents sont détaillés avec leurs conséquences en production. Le chapitre se termine par une checklist de mise en production directement actionnable.
Questions fréquentes
Faut-il toujours afficher un score de confiance numérique dans un produit IA ?
Comment vérifier que les citations affichées par mon produit sont fiables ?
Le contrôle utilisateur ne ralentit-il pas trop l'expérience produit ?
Quelle différence entre exprimer l'incertitude et simplement dire que le modèle peut se tromper ?
Comment gérer les actions automatisées en chaîne sans multiplier les confirmations ?
Un produit IA interne, sans client externe, a-t-il vraiment besoin de cette rigueur d'UX de confiance ?
Existe-t-il des métriques pour mesurer si l'UX de confiance fonctionne réellement ?
Progression sauvegardée dans votre navigateur.
Quiz de validation
Quiz Player
Quiz de validation
Plusieurs réponses possibles — validez ensuite.
Vrai ou faux.
Quiz indisponible (données invalides).