





Golden sets et datasets d'évaluation
Construire un golden set qui mesure vraiment la qualité d'un système LLM : couverture des cas critiques, fiabilité des labels et gestion du drift dans le temps.
Table des matières
Pourquoi un golden set change tout
Un système fondé sur un LLMLLMIAGrand modèle de langage (Large Language Model) entraîné sur d'énormes corpus pour prédire et générer du texte.Voir dans le glossaire produit des réponses différentes selon le promptpromptIAConsigne ou contexte fourni à un modèle de langage pour orienter sa réponse. La qualité du prompt conditionne souvent la qualité du résultat.Voir dans le glossaire, la température, la version du modèle ou même le hasard d'un tirage. Sans référence stable, toute affirmation sur sa qualité — « ça marche bien », « le taux d'erreur a baissé » — reste une impression, pas une mesure. Le golden set transforme cette impression en chiffre reproductible : un ensemble de cas d'entrée, chacun associé à un jugement de référence (réponse correcte, plage acceptable, critère de validation), sur lequel on rejoue le système à chaque changement.
Ce chapitre traite trois questions qui déterminent si un golden set est réellement utile ou seulement rassurant : couvre-t-il les bons cas, ses labels sont-ils fiables, reste-t-il représentatif dans le temps.
Qu'est-ce qu'un golden set, concrètement
Un golden set n'est pas un simple jeu de tests unitaires. C'est un échantillon curé et labellisé, conçu pour représenter la distribution réelle des cas rencontrés en production — y compris les cas rares mais coûteux en cas d'échec. Chaque entrée comporte au minimum un input reproductible (prompt, contextefenêtre de contexteIAQuantité de texte qu'un modèle peut prendre en compte simultanément : question, documents fournis et historique. Au-delà, les éléments les plus anciens sortent du champ.Voir dans le glossaire, paramètres), un label de référence (réponse attendue, critère de validation, grille de notation) et des métadonnées de traçabilité (catégorie, source, date, version).
Les cas proviennent idéalement de plusieurs sources combinées : extraits de logs de production réels et anonymisés, scénarios rédigés à la main pour couvrir des situations pas encore observées, et cas issus d'incidents passés — tickets de support, post-mortems, signalements utilisateurs. Un golden set construit à partir d'une seule source hérite mécaniquement des angles morts de cette source.
Un golden set gelé (figé dans le temps, versionné) sert de fondation à la mesure de régression. Un golden set qui évolue sans contrôle de version ne permet plus de comparer deux versions du système entre elles — on perd la capacité même de dire si on progresse ou régresse.
On distingue généralement trois usages, qui n'appellent pas la même construction :
- Golden set de régression — détecter qu'un changement (prompt, modèle, RAGRAGIATechnique consistant à rechercher les documents pertinents et à les fournir au modèle dans son contexte. Elle permet des réponses à jour et citables, ce que l'affinage ne permet pas.Voir dans le glossaire, fine-tuningFine-tuningIAAjustement des poids d'un modèle pré-entraîné sur un jeu de données spécifique pour adapter son comportement à un domaine ou une tâche cible.Voir dans le glossaire) n'a pas dégradé un comportement déjà validé.
- Golden set de capacité — mesurer si le système atteint un niveau de performance donné sur une tâche cible (précisionprécisionIAProportion des alertes émises par un modèle qui sont justifiées. Elle s'oppose au rappel : améliorer l'une dégrade l'autre.Voir dans le glossaire, exhaustivité, respect de contraintes).
- Golden set de sécurité — vérifier la résistance à des entrées adversariales, des demandes hors périmètre, ou des tentatives de contournement des garde-fous.
Le cycle de vie d'un golden set
Un golden set n'est pas un document qu'on remplit une fois et qu'on oublie. Il traverse un cycle en six étapes : collecte, labellisation selon une grille explicite, validation croisée par un second annotateur, gel d'une version identifiée, monitoring du driftdériveIADégradation progressive des performances d'un modèle après son déploiement, causée par l'évolution des comportements ou du contexte. Elle impose surveillance et réentraînement.Voir dans le glossaire en production, puis révision périodique qui relance le cycle. Sauter une étape — en particulier la validation croisée ou le gel de version — transforme le plus souvent un golden set prometteur en instrument de mesure peu fiable au bout de quelques mois.
Construire la couverture : au-delà de l'échantillon aléatoire
Un échantillon aléatoire de logs de production semble une base naturelle pour construire un golden set. C'est une erreur fréquente : il reproduit fidèlement ce qui arrive souvent, et noie ce qui compte — les cas rares mais critiques (une requête ambiguë mal interprétée, une injection de promptInjection de promptCybersécuritéAttaque visant à détourner un LLM en insérant des instructions malveillantes dans le contexte (entrée utilisateur, document RAG, etc.).Voir dans le glossaire, une question hors périmètre) sont statistiquement absents d'un tirage aléatoire de taille raisonnable.
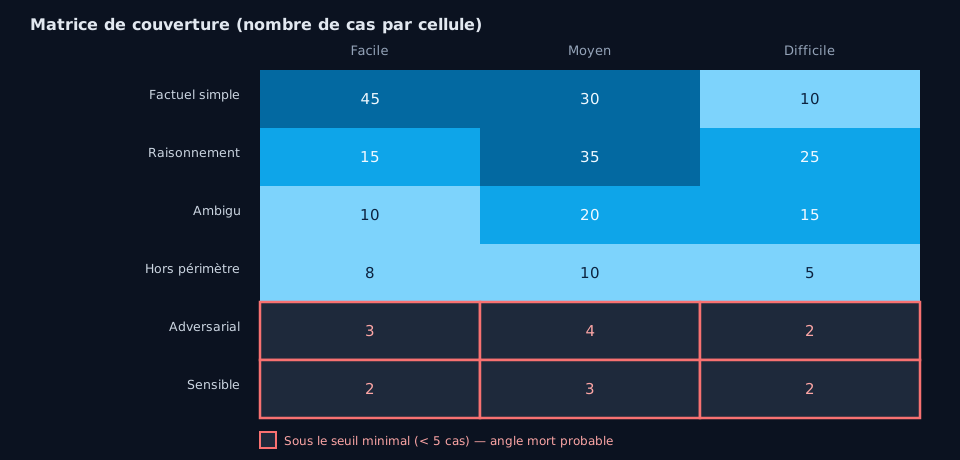
La couverture se construit à partir d'une taxonomie explicite, croisant au minimum deux axes : la catégorie fonctionnelle du cas (factuel, raisonnement multi-étapes, ambigu, hors périmètre, adversarialexemple adverseCybersécuritéEntrée modifiée de façon imperceptible pour un humain, mais suffisante pour faire basculer la décision d'un modèle. Cette fragilité découle de l'absence de sens commun.Voir dans le glossaire, sensible) et son niveau de difficulté attendu. Le tableau suivant illustre une taxonomie type pour un assistant de support client :
| Catégorie | Exemple de cas | Risque si raté |
|---|---|---|
| Factuel simple | « Quel est le prix du forfait Pro ? » | Confusion client, faible gravité |
| Raisonnement multi-étapes | Calcul d'un remboursement au prorata | Erreur financière |
| Ambigu | « Ça ne marche toujours pas » (sans contexte) | Réponse hors sujet |
| Hors périmètre | Question médicale posée à un bot e-commerce | Responsabilité engagée |
| Adversarial | Tentative de contournement des instructions système | Fuite de prompt, contenu inapproprié |
| Sensible | Demande touchant à des donnéesdonnéesIAEnsemble d'informations structurées ou non utilisées pour entraîner, évaluer ou alimenter un modèle. La qualité, la quantité et la représentativité des données sont les facteurs décisifs pour les performances en apprentissage automatique.Voir dans le glossaire personnelles | Non-conformité RGPDRGPDConformitéRèglement européen sur la protection des données personnelles. Il s'applique dès qu'un système d'IA traite de telles données, et se cumule avec l'AI Act.Voir dans le glossaire |
Les cas adversariaux méritent une attentionattentionIAMécanisme par lequel un modèle pondère l'importance de chaque token du contexte lorsqu'il en traite un autre, quelle que soit la distance qui les sépare.Voir dans le glossaire particulière : ils ne surgissent pas naturellement dans les logs tant que personne n'a encore tenté l'attaque. Leur absence dans un échantillon aléatoire ne signifie donc pas qu'ils sont rares — seulement qu'ils n'ont pas encore été observés. Une session dédiée de red teamingRed teamingCybersécuritéExercice offensif structuré visant à identifier les failles d'un système IA (prompt injection, fuite de données, biais) avant mise en production.Voir dans le glossaire, où l'équipe cherche activement à faire échouer le système, est le moyen le plus fiable de peupler cette catégorie avant qu'un incident ne le fasse à votre place.
Construisez la taxonomie avant de collecter les cas, pas après. Partez des incidents déjà survenus, des retours du support, et d'une session de red teaming interne où l'équipe imagine délibérément les entrées les plus problématiques.
Labelliser : le goulot d'étranglement invisible
La collecte des cas est rarement le facteur limitant ; c'est leur labellisation qui l'est. Un label de mauvaise qualité produit une mesure fausse à l'apparence scientifique.
Deux exigences structurent une labellisation fiable :
- Une grille de référence explicite. Pour les tâches ouvertes (résumé, reformulation, conseil), un simple « bon/mauvais » ne suffit pas : il faut une grille décomposant les critères (exactitude factuelle, complétude, ton, respect du format) notés indépendamment.
- Un accord inter-annotateurs mesuré. Faire labelliser un sous-échantillon par au moins deux annotateurs indépendants et calculer un score d'accord (kappa de Cohen ou pourcentage d'accord brut selon le contexte). Un accord faible ne signale pas seulement des annotateurs peu rigoureux : il révèle souvent une grille mal définie, où le critère lui-même est ambigu.
Avant tout labellisage à grande échelle, une phase de calibration — faire annoter un même petit lot par l'ensemble des annotateurs puis discuter les désaccords — évite de découvrir un problème de définition après avoir labellisé des milliers de cas.
Sur un golden set de réponses de support client, deux annotateurs notent différemment 30 % des cas jugés « réponse correcte ». En creusant, la grille ne précisait pas si une réponse incomplète mais non fausse devait être notée correcte. Le problème n'était pas les annotateurs, mais l'absence de définition opérationnelle du critère « correct ».
Pour les cas à fort enjeu (sécurité, conformité, décisions financières), le recours à un expert métier plutôt qu'à un annotateur généraliste change la qualité du label : un non-spécialiste ne détecte pas toujours qu'une réponse juridique est subtilement fausse.
Le drift : un golden set vieillit mal s'il n'est pas entretenu
Un golden set figé à un instant T se dégrade progressivement en pertinence, pour deux raisons distinctes qu'il faut savoir séparer.
Le drift de distribution survient quand les cas réels rencontrés en production évoluent — nouveaux types de demandes, nouveau produit, nouvelle réglementation — sans que le golden set soit mis à jour. Le score reste stable sur le papier, mais il mesure une réalité qui n'existe plus.
Le drift de référence survient quand le label lui-même devient obsolète, indépendamment des cas d'entrée : un prix a changé, une politique de remboursement a évolué, un fait autrefois vrai ne l'est plus. Un golden set non révisé continue de pénaliser des réponses désormais correctes, ou pire, de récompenser des réponses désormais fausses.
Détecter le drift de distribution ne demande pas d'outillage complexe : un échantillonnage mensuel de requêtes réelles, comparé à la taxonomie du golden set, suffit souvent à repérer l'apparition de catégories non couvertes.
Un score de golden set qui reste étonnamment stable sur plusieurs mois, alors que le produit et les usages évoluent visiblement, n'est pas nécessairement une bonne nouvelle. C'est souvent le signe que le golden set a cessé de refléter la réalité de la production plutôt que la preuve d'une qualité constante.
La parade n'est pas de réviser en continu, ce qui détruit la comparabilité dans le temps, mais de combiner un socle gelé et versionné avec un flux d'échantillonnage périodique des nouveaux cas de production, revus et intégrés lors de révisions programmées.
Taille et stratification : combien de cas suffisent
Il n'existe pas de taille universelle. Ce qui compte est la puissance statistique nécessaire pour détecter une régression du niveau qu'on cherche à repérer. Détecter une chute de 20 points de score demande beaucoup moins de cas que détecter une dégradation de 2 points sur une sous-catégorie rare.
En pratique, une stratification par catégorie fonctionne mieux qu'un total global : viser un minimum de 30 à 50 cas par catégorie de la taxonomie permet de calculer un score par catégorie suffisamment stable pour être actionnable, plutôt qu'un score agrégé qui masque les faiblesses locales derrière une bonne moyenne générale.
Concrètement, si une catégorie ne représente que 5 % du golden set global, quelques cas suffisent à faire bouger son score de plusieurs points, ce qui rend toute conclusion fragile en dessous d'un seuil minimal. Mieux vaut restreindre la taxonomie à ce que l'on peut réellement peupler correctement, plutôt que multiplier des sous-catégories anecdotiques.
Un golden set de 200 cas bien stratifiés et bien labellisés vaut mieux qu'un golden set de 2000 cas collectés au hasard. La taille ne compense jamais un défaut de couverture ou de fiabilité des labels.
Golden set, suite de régression, évaluation continue : ne pas confondre
Ces trois dispositifs se complètent mais répondent à des besoins différents ; les confondre produit des golden sets surchargés qui ne remplissent aucun rôle correctement.
Le golden set est un instrument de mesure ponctuelle et comparable, utilisé avant chaque mise en production. La suite de régression en est un sous-ensemble restreint aux cas déjà identifiés comme fragiles, rejouée automatiquement à chaque changement, avec un seuil de blocage. L'évaluation continue échantillonne le trafic réel en production pour détecter des dérives que le golden set, figé par nature, ne peut pas voir apparaître.
Gouvernance : versioning, gel et révision
Un golden set sans gouvernance dérive silencieusement : des cas sont ajoutés sans revue, des labels corrigés sans traçabilité, et personne ne sait si un score de la semaine dernière est comparable à celui d'aujourd'hui. Trois pratiques limitent ce risque :
- Versionner le golden set comme du code — chaque révision porte un identifiant, un changelog explicite des cas ajoutés, retirés ou relabellisés, et les scores historiques sont toujours rattachés à la version utilisée.
- Geler la version de référence pour toute campagne de comparaison — comparer deux modèles ou deux prompts exige de les évaluer sur exactement le même golden set, à la même version.
- Planifier des révisions périodiques — un rythme trimestriel est une base raisonnable pour la majorité des systèmes en production, à ajuster selon la vitesse d'évolution du produit.
Checklist avant de considérer un golden set opérationnel
- La taxonomie de couverture est documentée et validée par les équipes métier, pas seulement techniques.
- Chaque catégorie critique compte un nombre minimal de cas suffisant pour un score stable.
- Les labels suivent une grille explicite, avec un contrôle d'accord inter-annotateurs sur un échantillon.
- Les cas à fort enjeu (sécurité, conformité) ont été revus par un expert métier.
- Le golden set est versionné, avec un changelog et une politique de gel pour les comparaisons.
- Une échéance de révision est planifiée pour limiter le drift de distribution et de référence.
- Les scores publiés mentionnent systématiquement la version du golden set utilisée.
Pièges fréquents
Le piège le plus commun consiste à laisser le golden set converger vers les cas que le système traite déjà bien, en ajoutant spontanément les nouveaux cas rencontrés sans revoir la composition globale : le score s'améliore, mais la couverture des cas difficiles se dilue.
Un second piège consiste à confondre volume et fiabilité : multiplier les cas non labellisés avec soin donne une fausse impression de rigueur statistique alors que le bruit dans les labels domine le signal recherché.
Le chapitre suivant s'appuie sur ces fondations : une fois le golden set construit, couvert et fiable, il devient possible de définir des métriques d'évaluation qui aient un sens.
L'essentiel à retenir
Ce chapitre explique pourquoi une mesure de qualité fiable pour un système LLM repose sur un golden set bien construit plutôt que sur une impression subjective. Il détaille comment bâtir une taxonomie de couverture qui n'oublie pas les cas rares mais critiques, comment labelliser avec un accord inter-annotateurs mesurable, et pourquoi un golden set non entretenu se dégrade silencieusement sous l'effet du drift de distribution et du drift de référence. Il propose une checklist opérationnelle et clarifie la différence entre golden set, suite de régression et évaluation continue.
Questions fréquentes
Combien de cas faut-il dans un golden set pour qu'il soit fiable ?
Peut-on utiliser un LLM pour labelliser automatiquement un golden set ?
À quelle fréquence faut-il réviser un golden set ?
Quelle est la différence entre un golden set et une évaluation continue en production ?
Comment savoir si mes annotateurs labellisent de façon fiable ?
Faut-il inclure des cas adversariaux dans tous les golden sets ?
Le golden set doit-il être identique pour tous les modèles ou prompts testés ?
Progression sauvegardée dans votre navigateur.
Quiz de validation
Quiz Player
Quiz de validation
Plusieurs réponses possibles — validez ensuite.
Vrai ou faux.
Quiz indisponible (données invalides).