





Tests de régression LLM
Mettre en place une stratégie de test de régression pour les systèmes LLM : golden set, seuils de qualité, intégration continue et déploiement canari pour détecter les dégradations avant qu'elles n'atteignent les utilisateurs.
Table des matières
Pourquoi ce chapitre est le plus utile
Un système LLMLLMIAGrand modèle de langage (Large Language Model) entraîné sur d'énormes corpus pour prédire et générer du texte.Voir dans le glossaire en production n'est jamais figé. Le promptpromptIAConsigne ou contexte fourni à un modèle de langage pour orienter sa réponse. La qualité du prompt conditionne souvent la qualité du résultat.Voir dans le glossaire système change, le fournisseur pousse une nouvelle version de modèle sans préavis clair, la base documentaire alimentant un RAGRAGIATechnique consistant à rechercher les documents pertinents et à les fournir au modèle dans son contexte. Elle permet des réponses à jour et citables, ce que l'affinage ne permet pas.Voir dans le glossaire est réindexée, un paramètre de température est ajusté pour réduire les coûts. Chacun de ces changements, pris isolément, semble anodin. Chacun peut pourtant faire chuter silencieusement la qualité des réponses sur des cas qui fonctionnaient très bien la veille.
Ce phénomène porte un nom dans le génie logiciel classique : la régression. Ce chapitre transpose cette discipline aux systèmes fondés sur des LLMgrand modèle de langageIAModèle entraîné à prédire le token suivant d'une séquence de texte. Toutes ses capacités apparentes — résumer, traduire, coder — découlent de cette unique tâche.Voir dans le glossaire, avec ses outilstool callingIACapacité d'un agent ou d'un LLM à invoquer des outils externes (API, calcul, recherche) pendant le raisonnement.Voir dans le glossaire propres — jeu de référence, seuils numériques, porte d'intégration continue, déploiement canari — parce que les techniques de test logicielles habituelles (assertions strictes, comparaison exacte de sortie) ne suffisent pas face à un système non déterministe.
Pourquoi les tests logiciels classiques ne suffisent pas
Un test unitaire classique compare une sortie à une valeur attendue, au caractère près. Un LLM ne produit presque jamais deux fois la même formulation, même à température nulle sur certains fournisseurs, et encore moins d'une version de modèle à l'autre. Vouloir figer une sortie exacte revient à condamner le test à échouer en permanence pour des raisons sans rapport avec la qualité réelle.
Le test de régression LLM ne compare donc pas des chaînes de caractères, il compare des propriétés : la réponse contient-elle l'information attendue, respecte-t-elle un format, évite-t-elle une affirmation interdite, reste-t-elle dans une fourchette de longueur ou de coût acceptable. Cette bascule d'une comparaison syntaxique vers une évaluation sémantique et statistique est le changement de posture central de ce chapitre.
Un test de régression LLM ne demande jamais « est-ce identique à hier ? » mais « est-ce toujours acceptable, au sens des critères que j'ai définis ? ». Sans critères explicites et mesurés, il n'y a pas de test, seulement une impression.
Construire un jeu de référence (golden set)
Le socle de toute stratégie de régression est un ensemble de cas représentatifs et stables, appelé golden set ou jeu de référence. Il doit couvrir :
- Les cas nominaux — les requêtes les plus fréquentes, celles qui représentent l'essentiel du trafic réel.
- Les cas limites — entrées ambiguës, incomplètes, très longues, multilingues, ou formulées de façon inhabituelle.
- Les cas de non-régression ciblée — des bugs déjà corrigés dans le passé, pour vérifier qu'ils ne réapparaissent pas.
- Les cas à risque métier — ceux où une erreur a un coût élevé : conseil juridique, montant financier, contre-indication médicale, engagement contractuel.
- Les cas adversariaux — tentatives de contournement des garde-fous, prompts injection, demandes hors périmètre.
Chaque cas du jeu de référence doit être associé à un critère de validation explicite, pas seulement à une réponse idéale. Un critère peut être une liste d'éléments devant apparaître dans la réponse, une contrainte de format (JSON valide, longueur maximale), une interdiction (ne jamais donner de numéro de téléphone inventé), ou une note attribuée par un juge automatisé.
Entrée : « Mon abonnement a été prélevé deux fois ce mois-ci. » Critères : la réponse doit (1) reconnaître le problème sans le nier, (2) proposer une action concrète (remboursement, ticket), (3) ne pas promettre de délai chiffré non vérifié, (4) rester sous 120 mots. Ce cas devient un test automatisable même si la formulation exacte varie à chaque exécution.
La taille du golden set dépend du périmètre applicatif, mais un chiffre de repère utile est de démarrer avec 50 à 150 cas soigneusement choisis plutôt que des milliers de cas peu discriminants. Un golden set trop large et redondant ralentit la boucle de feedback sans améliorer la détection de régression.
Mesurer : des métriques adaptées au texte généré
Trois familles de métriques se combinent généralement dans un pipeline de régression LLM.
Métriques déterministes. Elles s'appliquent quand la sortie a une structure vérifiable par code : validité JSON, présence de mots-clés obligatoires, respect d'un schéma, longueur, absence de motifs interdits (regex). Rapides, gratuites, reproductibles à 100 %, elles doivent couvrir le maximum de cas possible avant de recourir à des méthodes plus coûteuses.
Similarité sémantique. Quand une réponse de référence existe, on peut mesurer la proximité sémantique entre la sortie du modèle et cette référence via des embeddingsembeddingIAReprésentation numérique dense d'un texte, d'une image ou d'un objet dans un espace vectoriel, utilisée pour la similarité et la recherche sémantique.Voir dans le glossaire, plutôt qu'une correspondance exacte de texte. Cette approche tolère la reformulation mais reste aveugle à certaines nuances factuelles : deux phrases proches en embedding peuvent différer sur un chiffre ou une négation.
LLM-as-judgeLLM-as-judgeIAÉvaluation automatisée où un LLM note ou compare des sorties selon des critères définis, souvent en complément de métriques classiques.Voir dans le glossaire. Un modèle tiers (parfois le même modèle, parfois un modèle différent pour limiter les biaisbiaisIARégularité correctement apprise dans des données qui ne représentent pas la réalité visée, ou qui enregistrent des décisions passées avec leurs préjugés. Changer d'algorithme ne le corrige pas.Voir dans le glossaire d'auto-évaluation) note la réponse selon une grille de critères fournie dans son propre prompt : exactitude, ton, complétude, absence de contenu problématique. Cette méthode capture des nuances qu'aucune règle déterministe ne peut exprimer, mais elle introduit elle-même une source de bruit et un coût récurrent.
| Méthode | Coût | Reproductibilité | Détecte |
|---|---|---|---|
| Règles déterministes | Très faible | Totale | Format, mots-clés, structure |
| Similarité sémantique | Faible | Haute | DérivedériveIADégradation progressive des performances d'un modèle après son déploiement, causée par l'évolution des comportements ou du contexte. Elle impose surveillance et réentraînement.Voir dans le glossaire de sens grossière |
| LLM-as-judge | Moyen à élevé | Moyenne | Nuances de ton, exactitude, complétude |
| Revue humaine ciblée | Élevé | Haute | Cas ambigus, arbitrage final |
Un LLM-as-judge hérite des biais du modèle qui l'exécute : préférence pour les réponses longues, sensibilité à l'ordre de présentation, tendance à sur-noter un style qui ressemble au sien. Calibrez-le régulièrement contre un échantillon annoté par des humains, et ne l'utilisez jamais comme unique filtre sur les cas à fort enjeu.
Fixer des seuils : le cœur de la décision automatisée
Un score n'a de valeur opérationnelle que rapporté à un seuil qui déclenche une décision : passer, alerter, bloquer. Trois types de seuils structurent un pipeline mature.
Seuil de score minimal par cas. Chaque cas du golden set reçoit une note (0 à 1, ou une classification passe/échoue). Un seuil définit la note minimale acceptable individuellement, par exemple aucun cas à fort enjeu ne doit tomber sous 0,8.
Seuil agrégé sur l'ensemble. Le taux global de réussite sur le golden set ne doit pas descendre sous un plancher, par exemple 92 %. Ce seuil tolère quelques échecs isolés tout en bloquant une dégradation généralisée.
Seuil de dérive relative. Plutôt qu'une valeur absolue, on compare la nouvelle version à la version en production : une chute de plus de 3 points de pourcentage sur le taux de réussite déclenche un blocage, même si le score absolu reste correct. Ce seuil est particulièrement utile pour détecter des dégradations progressives que des seuils absolus, réglés une fois pour toutes, laisseraient passer.
Ne traitez pas un cas « salutation d'accueil » avec la même exigence qu'un cas « calcul de remboursement ». Segmentez le golden set par niveau de criticité et appliquez un seuil plus strict — voire un blocage automatique sur le moindre échec — aux catégories à fort impact métier ou réglementaire.
Fixer un seuil est un compromis, pas une science exacte. Un seuil trop strict génère des faux blocages qui ralentissent les équipes et incitent, à terme, à contourner la porte CI. Un seuil trop lâche laisse passer des régressions réelles. La bonne pratique consiste à démarrer avec un seuil légèrement en dessous du score actuel observé, puis à le resserrer progressivement une fois que le pipeline a prouvé sa fiabilité et que les fausses alertes ont été purgées.
Intégrer la régression dans un pipeline CI/CD
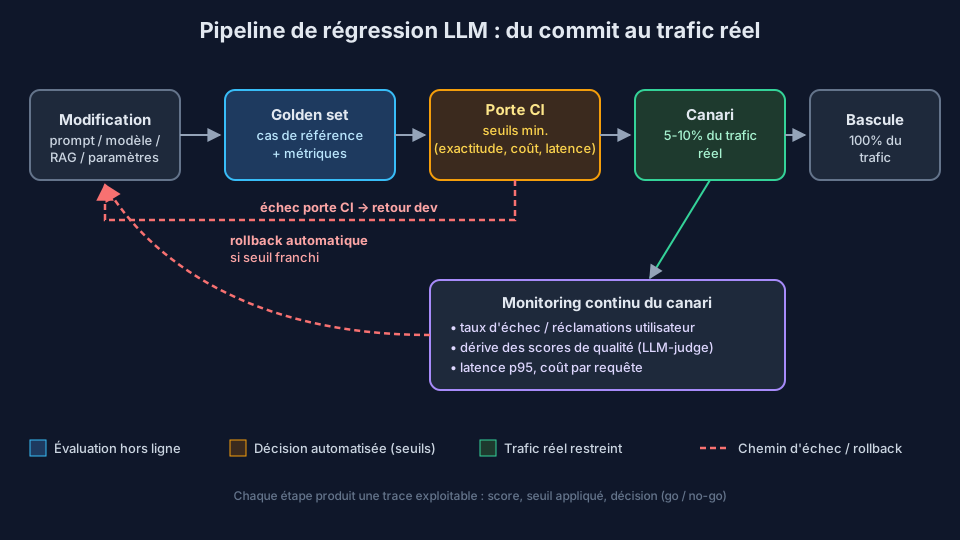
Le principe reprend l'intégration continue logicielle classique, avec une étape d'évaluation LLM insérée avant toute fusion ou déploiement :
- Déclencheur — toute modification du prompt système, de la configuration du modèle, du pipeline de récupération (RAG) ou de la version de modèle déclenche automatiquement l'exécution du golden set.
- Exécution — chaque cas du golden set est soumis à la nouvelle configuration, en parallèle quand c'est possible pour limiter le temps d'exécution.
- Notation — application des trois familles de métriques pertinentes selon le cas.
- Comparaison — les scores obtenus sont comparés aux seuils définis et à la version de référence en production.
- Décision — passage automatique si tous les seuils sont respectés ; blocage avec rapport détaillé sinon, listant précisément les cas ayant régressé et leur delta de score.
L'enjeu principal de cette intégration est la vitesse. Un pipeline qui prend quarante minutes à s'exécuter dissuade les itérations fréquentes. Paralléliser les appels au modèle évalué, mettre en cache les résultats des cas inchangés, et réserver le LLM-as-judge (le plus coûteux) aux cas où les règles déterministes ne suffisent pas sont trois leviers efficaces pour maintenir un pipeline exploitable au quotidien.
Un pipeline de régression LLM ne remplace pas la revue humaine, il la concentre. L'objectif est de filtrer automatiquement l'essentiel des cas non ambigus pour que l'attentionattentionIAMécanisme par lequel un modèle pondère l'importance de chaque token du contexte lorsqu'il en traite un autre, quelle que soit la distance qui les sépare.Voir dans le glossaire humaine, ressource rare, se porte sur les cas réellement disputés remontés par le pipeline.
Le déploiement canari : tester en conditions réelles sans tout risquer
Même un golden set soigné ne couvre jamais l'intégralité de la diversité du trafic réel. Le déploiement canari complète la porte CI en exposant la nouvelle version à une fraction limitée du trafic en production — typiquement 5 à 10 % — avant une bascule complète.
Le principe repose sur trois éléments :
- Un routage contrôlé, qui dirige une portion mesurée et représentative des requêtes réelles vers la nouvelle version, le reste continuant vers la version stable.
- Des indicateurs de santé suivis en continu sur le segment canari : taux de réponses signalées par les utilisateurs, taux d'escalade vers un humain, latence, coût par requête, et échantillonnage régulier noté par LLM-as-judge.
- Un critère de retour arrière automatique, déclenché sans intervention humaine si un indicateur franchit un seuil d'alerte pendant la fenêtre d'observation.
La durée d'une phase canari dépend du volume de trafic : il faut un nombre de requêtes suffisant pour détecter statistiquement un écart significatif, pas seulement du bruit d'échantillonnage. Sur un trafic faible, quelques centaines de requêtes peuvent nécessiter plusieurs jours d'observation avant qu'une décision fiable puisse être prise.
Un canari sans instrumentation adéquate (pas de suivi des réclamations, pas d'échantillonnage qualité) donne une fausse impression de sécurité. L'absence de signal négatif remonté n'équivaut pas à l'absence de régression si personne ne regarde les bons indicateurs.
Suivre la dérive dans le temps
Au-delà du contrôle ponctuel à chaque changement, un système LLM en production doit faire l'objet d'un suivi continu de la dérive (drift). Deux sources de dérive sont à distinguer :
Dérive du modèle — le fournisseur met à jour silencieusement un modèle derrière un même identifiant de version, ou déprécie une version sans migration automatique claire. Le comportement change alors que rien n'a été modifié côté application.
Dérive des donnéesdonnéesIAEnsemble d'informations structurées ou non utilisées pour entraîner, évaluer ou alimenter un modèle. La qualité, la quantité et la représentativité des données sont les facteurs décisifs pour les performances en apprentissage automatique.Voir dans le glossaire d'entrée — la nature des requêtes des utilisateurs évolue (nouveaux cas d'usage, nouveau vocabulaire, nouvelle langue), et le golden set, construit à un instant donné, ne reflète plus la réalité du trafic.
La parade consiste à ré-exécuter périodiquement le golden set sur la version en production, même en l'absence de changement volontaire côté équipe, et à échantillonner régulièrement le trafic réel pour repérer les catégories de requêtes émergentes qui devraient enrichir le golden set. Un golden set jamais mis à jour perd sa valeur diagnostique au fil des mois.
Pièges fréquents
- Golden set figé à la création — construit une fois lors du lancement, jamais enrichi des incidents réels survenus depuis, il finit par ne plus rien détecter d'utile.
- Seuils choisis arbitrairement — sans calibration contre un historique de scores réels, un seuil est soit inefficace, soit source de blocages incessants et donc ignoré.
- Confusion entre coût de calcul et qualité — un modèle moins cher peut sembler équivalent sur des métriques agrégées tout en régressant fortement sur une sous-catégorie de cas à fort enjeu, noyée dans la moyenne.
- LLM-as-judge non calibré — utilisé sans vérification périodique contre une annotationannotationIAProcessus d'étiquetage manuel des données d'entraînement par des experts humains. La qualité de l'annotation conditionne directement les performances du modèle d'apprentissage supervisé.Voir dans le glossaire humaine, il dérive lui-même et peut valider des régressions qu'un humain aurait immédiatement repérées.
- Absence de retour arrière automatisé — un canari qui détecte une anomalie mais nécessite une intervention manuelle pour revenir en arrière perd l'essentiel de son intérêt en cas d'incident nocturne ou de week-end.
Checklist opérationnelle
- Le golden set couvre les cas nominaux, limites, à risque métier et adversariaux.
- Chaque cas dispose d'un critère de validation explicite, pas d'une seule réponse idéale.
- Les métriques déterministes sont appliquées en priorité, avant tout recours au LLM-as-judge.
- Des seuils absolus, agrégés et de dérive relative sont définis et documentés.
- Le pipeline CI se déclenche automatiquement sur toute modification du prompt, du modèle ou du RAG.
- Un déploiement canari avec retour arrière automatique protège toute mise en production.
- Le golden set est ré-exécuté périodiquement en production pour détecter la dérive du modèle.
- Le LLM-as-judge est recalibré régulièrement contre une annotationétiquetageIATravail consistant à associer à chaque exemple la réponse attendue. C'est presque toujours le poste le plus coûteux d'un projet d'apprentissage supervisé.Voir dans le glossaire humaine.
Un système de tests de régression bien construit ne garantit jamais une qualité parfaite : il garantit une visibilité sur les dégradations, et la capacité d'y répondre avant qu'un utilisateur ne les découvre à votre place.
L'essentiel à retenir
Ce chapitre explique comment détecter les régressions de qualité dans un système LLM en production, malgré le non-déterminisme du texte généré. Il présente la construction d'un golden set de cas de référence, les trois familles de métriques (règles déterministes, similarité sémantique, LLM-as-judge) et la définition de seuils de blocage adaptés à la criticité métier. Il détaille l'intégration de cette évaluation dans un pipeline CI/CD ainsi que la mise en place d'un déploiement canari avec retour arrière automatique. Il se conclut par les pièges les plus fréquents et une checklist opérationnelle réutilisable.
Questions fréquentes
Combien de cas faut-il dans un golden set pour un premier pipeline de régression ?
Faut-il utiliser le même modèle pour générer la réponse et pour la juger (LLM-as-judge) ?
Quelle différence entre un test de régression LLM et un déploiement canari ?
Comment fixer un seuil de blocage sans le rendre trop strict ni trop permissif ?
Un changement de fournisseur de modèle nécessite-t-il de refaire tout le golden set ?
Que faire si le pipeline de régression devient trop lent à exécuter ?
Le déploiement canari s'applique-t-il aussi à un simple changement de prompt système ?
Progression sauvegardée dans votre navigateur.
Quiz de validation
Quiz Player
Quiz de validation
Plusieurs réponses possibles — validez ensuite.
Vrai ou faux.
Quiz indisponible (données invalides).