





Mesurer la productivité sans se tromper
Comprendre pourquoi les métriques classiques (lignes de code, commits, vélocité) deviennent trompeuses avec l'IA générative, et construire un tableau de bord qui capture réellement la valeur produite.
Table des matières
Pourquoi la productivité devient plus difficile à mesurer
Avant l'arrivée des assistants IAintelligence artificielleIAEnsemble des techniques permettant à un programme d'accomplir une tâche qui demanderait de l'intelligence humaine. Le terme couvre aussi bien les systèmes à règles écrites que ceux qui apprennent de données.Voir dans le glossaire, mesurer la productivité d'une équipe de développement était déjà un exercice miné d'approximations. Avec des outilstool callingIACapacité d'un agent ou d'un LLM à invoquer des outils externes (API, calcul, recherche) pendant le raisonnement.Voir dans le glossaire capables de générer des centaines de lignes de code en quelques secondes, les biaisbiaisIARégularité correctement apprise dans des données qui ne représentent pas la réalité visée, ou qui enregistrent des décisions passées avec leurs préjugés. Changer d'algorithme ne le corrige pas.Voir dans le glossaire préexistants s'aggravent au lieu de se résorber. Un développeur qui accepte massivement les suggestions d'un assistant peut produire un volume de code considérable sans que la valeur livrée n'augmente dans les mêmes proportions — et parfois en la faisant diminuer, si ce code doit être relufonction d'activationIAOpération non linéaire appliquée en sortie d'un neurone. Sans elle, empiler des couches serait inutile : une succession d'opérations linéaires reste équivalente à une seule.Voir dans le glossaire, corrigé ou réécrit plus tard.
Le problème n'est pas nouveau dans son principe : on sait depuis longtemps que le volume n'est pas la valeur. Ce qui change avec l'IA générative, c'est l'ampleur de l'écart possible entre les deux. Un outil qui abaisse le coût marginal d'écriture du code rend les métriques de volume encore moins corrélées à l'impact réel. Ce chapitre ne propose pas une métrique miracle — il n'en existe pas — mais une méthode pour éviter les pièges les plus courants et construire un système de mesure qui résiste à l'examen critique.
Toute métrique rendue visible et évaluée devient, tôt ou tard, un objectif poursuivi pour lui-même. Avant de choisir un indicateur, demandez-vous quel comportement une équipe rationnelle adopterait pour le faire monter artificiellement. Si la réponse est un comportement indésirable, l'indicateur est mal choisi ou doit être combiné à un contrepoids.
Les métriques qui mentent
Certains indicateurs restent utilisés malgré des décennies de mise en garde, simplement parce qu'ils sont faciles à collecter automatiquement.
Lignes de code produites. Un assistant IA génère facilement du code plus verbeux qu'un développeur expérimenté n'en écrirait à la main — davantage de commentaires, de gestion d'erreurs générique, de structures répétées plutôt que factorisées. Compter les lignes revient à récompenser la verbosité, pas la qualité. Deux implémentations peuvent résoudre le même problème avec un facteur dix entre leurs tailles.
Nombre de commits. Un commit ne représente aucune unité de travail stable. L'usage d'un assistant IA tend à multiplier les petits commits générés lors d'itérations rapides de promptpromptIAConsigne ou contexte fourni à un modèle de langage pour orienter sa réponse. La qualité du prompt conditionne souvent la qualité du résultat.Voir dans le glossaire-test-ajustement, ce qui gonfle artificiellement ce compteur sans rapport avec l'avancement réel.
Pull requests fusionnées. Ce chiffre paraît plus proche de la livraison, mais il ignore la taille et la complexité de chaque PR. Une équipe évaluée sur ce critère apprend vite à découper son travail en PR plus petites et plus nombreuses — utile en soi, mais distorsion dès que le découpageChunkingIADécoupage d'un document en segments de taille fixe ou sémantique avant indexation vectorielle, pour optimiser la récupération RAG.Voir dans le glossaire sert la métrique plutôt que la lisibilité.
Vélocité en story points. Les points d'effort sont une estimation relative interne à une équipe, jamais comparable d'une équipe à l'autre. Une équipe dont la vélocité est comparée à un objectif externe finit presque toujours par inflater ses estimations plutôt que d'accélérer réellement.
Une équipe qui adopte un assistant de code peut voir sa vélocité mesurée augmenter de 20 à 40 % en quelques sprints, sans que le time-to-market ni la satisfaction client ne bougent. Dans plusieurs retours d'expérience documentés, l'écart s'explique par du code généré plus rapidement mais nécessitant davantage de cycles de correction post-fusion — un coût qui n'apparaît dans aucune des métriques de sprint habituelles.
Le cadre SPACE
Proposé par des chercheurs de Microsoft, GitHub et l'université de Victoria, le cadre SPACE part d'un principe simple : la productivité d'un développeur ne peut pas se réduire à une seule dimension, parce qu'elle recouvre au moins cinq facettes distinctes, souvent en tension les unes avec les autres.
- Satisfaction & bien-être — épuisement professionnel, satisfaction vis-à-vis des outils et du code produit, sentiment d'utilité du travail. Un assistant IA mal intégré peut dégrader cette dimension en imposant une relecture constante de suggestions non fiables, même si le débit apparent progresse.
- Performance — le résultat obtenu du point de vue du client ou du système : fiabilité, atteinte des objectifs métier, qualité perçue. C'est la dimension la plus proche de la valeur réelle, et la plus difficile à instrumenter automatiquement.
- Activity — le volume d'actions traçables : commits, PR, déploiements, tickets fermés. Utile en complément, dangereux en indicateur unique, pour les raisons vues plus haut.
- Communication & collaboration — qualité de la documentation, fluidité des revues de code, transfert de connaissance entre membres de l'équipe. L'usage massif d'un assistant IA peut réduire les échanges entre pairs si chacun préfère interroger l'outil plutôt qu'un collègue — un effet secondaire rarement anticipé.
- Efficiency & flow — capacité à avancer sans interruption ni friction inutile : temps d'attente entre les étapes, nombre de changements de contextefenêtre de contexteIAQuantité de texte qu'un modèle peut prendre en compte simultanément : question, documents fournis et historique. Au-delà, les éléments les plus anciens sortent du champ.Voir dans le glossaire, longueur des files d'attente de revue.
Aucune de ces cinq dimensions n'est mesurable par un seul chiffre fiable. Le cadre SPACE ne propose pas une formule mais une discipline : ne jamais présenter une métrique d'activité sans une métrique de performance ou de satisfaction en regard.
Les métriques DORA à l'ère de l'IA
Les quatre métriques DORA (DevOps Research and Assessment) restent parmi les indicateurs les plus robustes de la littérature, parce qu'elles portent sur le système de livraison plutôt que sur l'activité individuelle.
| Métrique | Ce qu'elle capture | Effet observé avec l'IA générative |
|---|---|---|
| Fréquence de déploiement | Rythme de mise en production | Peut augmenter si le code généré est correctement testé ; stagne sinon, la revue devenant le goulot d'étranglement |
| Délai de mise en œuvre (lead time) | Temps entre le commit et la production | Souvent réduit sur la phase d'écriture, inchangé voire allongé si la phase de revue et de test ne suit pas |
| Taux d'échec des changements | Proportion de déploiements provoquant un incident | Indicateur le plus sensible à une adoption non maîtrisée de l'IA — il augmente quand le code généré est fusionné sans revue suffisante |
| Délai moyen de rétablissement (MTTR) | Rapidité à corriger un incident | Peu affecté par l'IA en écriture, mais un assistant peut accélérer le diagnostic si l'équipe l'utilise aussi en investigation |
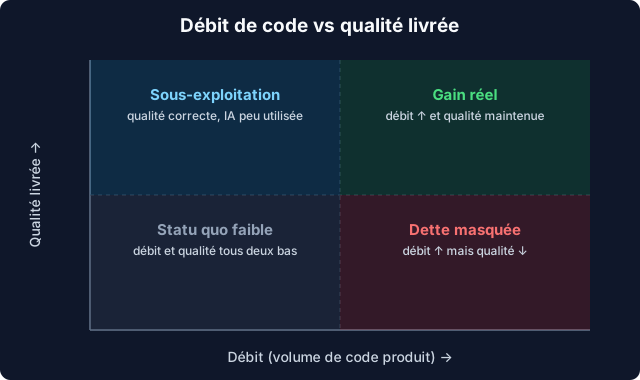
Le taux d'échec des changements mérite une attentionattentionIAMécanisme par lequel un modèle pondère l'importance de chaque token du contexte lorsqu'il en traite un autre, quelle que soit la distance qui les sépare.Voir dans le glossaire particulière. C'est souvent la première métrique à se dégrader silencieusement lorsqu'une équipe accélère l'écriture de code sans renforcer en proportion les tests automatisés et la profondeur des revues. Une fréquence de déploiement en hausse combinée à un taux d'échec stable ou en baisse est un signal fiable d'amélioration réelle. La même hausse combinée à un taux d'échec qui grimpe traduit une dette accumulée, pas un gain.
Une équipe de neuf développeurs adopte un assistant IA pour l'écriture de tests unitaires et de code de service. Sur un trimestre, la fréquence de déploiement passe de deux à cinq par semaine. Isolée, cette progression semble excellente. Mais le taux d'échec des changements passe de 8 % à 19 % sur la même période, et le MTTR double. La lecture correcte n'est pas « la productivité a augmenté », mais « le système livre plus vite un code moins fiable » — un diagnostic qui appelle un renforcementapprentissage par renforcementIAMéthode où un agent agit dans un environnement et reçoit une récompense ou une pénalité. Par essais répétés, il découvre la stratégie qui maximise la récompense cumulée.Voir dans le glossaire de la revue, pas une célébration.
Mesurer la qualité en plus du débit
Au-delà de DORA, plusieurs indicateurs de qualité aident à contrebalancer les métriques de volume :
- Taux d'échappement des défauts (defect escape rate) — proportion de bugs détectés en production plutôt qu'avant la mise en ligne. L'un des signaux les plus directs de l'effet réel d'un assistant IA sur la qualité livrée.
- Profondeur de revue de code — nombre de commentaires substantiels par revue, temps médian passé en revue. Une revue expédiée en deux minutes sur une PR générée par IA volumineuse est un signal d'alerte, pas un gain de temps.
- Delta de couverture de tests — évolution de la couverture avant/après l'introduction de l'assistant. Le code généré automatiquement s'accompagne rarement de tests équivalents si cela n'est pas explicitement demandé et vérifié.
- Ratio de retouche (rework ratio) — proportion du code modifié ou supprimé dans les quatre semaines suivant son introduction. Un ratio en hausse indique du code généré plus vite mais moins stable.
- Dette technique perçue — mesurée par sondage d'équipe plutôt que par outil automatique, cette dimension capture ce que les métriques de volume ne voient jamais : lisibilité, cohérence architecturale, facilité d'évolution.
Chacun de ces indicateurs pris isolément peut être trompé ou mal interprété. Leur intérêt vient de leur combinaison : un débit en hausse avec un taux d'échappement stable et une couverture de tests maintenue est un signal cohérent de gain réel. Le même débit en hausse avec un taux d'échappement qui grimpe ne l'est pas.
La loi de Goodhart et le gaming des métriques
Formulée par l'économiste Charles Goodhart, la loi énonce qu'« une mesure qui devient un objectif cesse d'être une bonne mesure ». Ce principe s'applique avec une force particulière aux métriques de développement assisté par IA, parce que ces outils rendent le gaming plus facile et moins visible qu'auparavant.
Quelques dérives documentées en entreprise :
- Des développeurs demandent à un assistant de reformuler ou d'étoffer du code déjà fonctionnel, uniquement pour faire progresser un compteur de lignes ou de commits suivi par leur management.
- Une équipe évaluée sur le nombre de PR fusionnées scinde systématiquement ses changements en fragments plus petits que ce que la lisibilité justifierait, ralentissant la compréhension globale du système pour les futurs lecteurs.
- Un manager qui communique un objectif de « productivité augmentée de X % grâce à l'IA » incite implicitement son équipe à privilégier les tâches rapides à quantifier au détriment des tâches complexes mais à plus forte valeur, qui ne produisent pas de signal visible à court terme.
La parade n'est pas d'abandonner toute mesure — l'absence de mesure ouvre la voie à des décisions arbitraires — mais de ne jamais rendre une métrique unique visible comme objectif individuel. Les métriques d'activité doivent rester des signaux d'équipe et de système, discutés collectivement, jamais des cibles de performance individuelle.
Construire un tableau de bord sain — checklist
Quelques principes opérationnels pour éviter les écueils décrits plus haut :
- Ne jamais afficher une métrique d'activité seule. Toujours l'accompagner d'un indicateur de qualité ou de résultat sur le même tableau.
- Mesurer au niveau équipe, pas individuel. Un classement par volume de code produit avec IA invite au gaming et dégrade la dimension « Satisfaction » du cadre SPACE.
- Trianguler quantitatif et qualitatif. Un sondage trimestriel court sur la friction perçue complète les métriques automatiques, qui ne voient jamais l'épuisement.
- Associer l'équipe à la définition des métriques suivies. Une métrique imposée sans discussion est perçue comme un outil de surveillance et génère des comportements défensifs.
- Revoir les indicateurs périodiquement. Un indicateur pertinent il y a un an peut devenir obsolète ou détourné ; prévoir une revue au moins semestrielle du tableau de bord.
- Documenter les décisions prises à partir des métriques. Un indicateur qui n'a jamais influencé une décision concrète en un trimestre peut être retiré.
- Isoler l'effet de l'IA des autres variables. Un changement de vélocité coïncide souvent avec d'autres facteurs (montée en compétence, périmètre, saisonnalité) ; ignorer ces variables mène à de fausses attributions.
Étude de cas condensée
Une équipe produit de taille moyenne (douze développeurs) introduit un assistant de code sur l'ensemble de son périmètre backend, avec pour objectif annoncé de « réduire le temps de mise en œuvre des fonctionnalités ». Sur les trois premiers mois, sans changement de méthode de mesure, la direction constate une hausse de 35 % du nombre de commits et conclut à un succès.
Un examen plus poussé, mené par l'équipe elle-même à l'aide du cadre SPACE, révèle un tableau plus nuancé : le lead time DORA a effectivement baissé de 18 %, mais le taux d'échec des changements est passé de 6 % à 14 %, et le sondage de satisfaction trimestriel montre une hausse de la frustration liée aux corrections de suggestions incorrectes sur les parties anciennes du code. La dimension Communication se dégrade aussi : les développeurs juniors sollicitent moins leurs pairs seniors depuis qu'ils interrogent d'abord l'assistant, ce qui ralentit leur montée en compétence sur l'architecture du système.
La décision prise n'est pas d'abandonner l'outil, mais de conditionner la fusion de tout code généré par IA sur les modules critiques à une revue senior, et de réintroduire des sessions de pair-programming hebdomadaires. Six mois plus tard, le taux d'échec revient à 7 %, et le lead time reste amélioré de 12 % — un gain plus modeste que le chiffre brut de commits ne le laissait espérer, mais réel et durable.
Ce qu'il faut retenir
- Les métriques de volume (lignes de code, commits, PR fusionnées) deviennent moins fiables avec l'IA générative, pas plus : l'écart entre volume produit et valeur livrée s'élargit.
- Le cadre SPACE et les métriques DORA offrent des points de croisement plus robustes qu'un indicateur unique, à condition de toujours les lire ensemble.
- Le taux d'échec des changements est souvent le premier signal à se dégrader lors d'une adoption non maîtrisée d'un assistant IA — surveillez-le en priorité.
- La loi de Goodhart s'applique avec une force accrue dès qu'un outil rend le gaming des indicateurs plus facile : ne jamais transformerTransformerIAArchitecture introduite en 2017, fondée sur le mécanisme d'attention, qui traite une séquence entière en parallèle. Elle sert de base à tous les grands modèles de langage actuels.Voir dans le glossaire une métrique d'activité en objectif individuel.
- Un tableau de bord sain combine quantitatif et qualitatif, se construit avec l'équipe, et se révise régulièrement plutôt que de rester figé.
L'essentiel à retenir
L'arrivée des assistants IA dans le développement logiciel a rendu les métriques de productivité traditionnelles encore moins fiables qu'elles ne l'étaient déjà. Ce chapitre explique pourquoi le volume de code produit n'est pas un indicateur de valeur, comment le cadre SPACE et les métriques DORA permettent de croiser des signaux complémentaires, et ce que la loi de Goodhart implique dès qu'une équipe sait qu'elle est mesurée. Il propose une méthode concrète pour construire un tableau de bord équilibré, avec des exemples de dérives observées en entreprise et une checklist opérationnelle.
- Métriques de vanité (lignes de code, nombre de commits)
- Cadre SPACE (Satisfaction, Performance, Activity, Communication, Efficiency)
- Métriques DORA (fréquence de déploiement, lead time, taux d'échec, MTTR)
- Loi de Goodhart et gaming des indicateurs
- Taux d'échappement des défauts (defect escape rate)
- Triangulation quantitatif / qualitatif
- Dette technique induite par l'IA générative
Questions fréquentes
Faut-il arrêter de mesurer les lignes de code produites par les développeurs ?
Le cadre SPACE remplace-t-il les métriques DORA ?
Comment savoir si mon équipe subit un gaming des métriques sans le remarquer ?
Peut-on comparer la productivité de deux équipes différentes avec ces métriques ?
L'IA générative améliore-t-elle réellement la productivité mesurée par DORA ?
Quelle fréquence de revue du tableau de bord de productivité est raisonnable ?
Le taux d'échappement des défauts est-il facile à mettre en place ?
Progression sauvegardée dans votre navigateur.
Quiz de validation
Quiz Player
Quiz de validation
Plusieurs réponses possibles — validez ensuite.
Vrai ou faux.
Quiz indisponible (données invalides).