





Bases vectorielles
Comment un index vectoriel retrouve les voisins les plus proches à grande échelle sans comparaison exhaustive, et ce qu'implique ce compromis en production : structure HNSW, filtrage par métadonnées, opérations courantes.
Table des matières
Pourquoi un index, et pas une simple comparaison brute
Une base vectoriellebase vectorielleIABase spécialisée qui indexe des embeddings pour retrouver rapidement les passages les plus proches d'une requête (cœur du RAG).Voir dans le glossaire stocke des embeddingsembeddingIAReprésentation numérique dense d'un texte, d'une image ou d'un objet dans un espace vectoriel, utilisée pour la similarité et la recherche sémantique.Voir dans le glossaire — des vecteurs de quelques centaines à quelques milliers de dimensions — et répond à une question précise : étant donné un vecteur requête, quels sont les k vecteurs indexés les plus proches selon une métrique donnée (cosinus, produit scalaire, distance euclidienne) ? C'est le problème du plus proche voisin.
La méthode la plus simple, dite recherche exhaustive ou flat, calcule la distance entre la requête et chacun des vecteurs indexés, puis trie pour garder les k meilleurs. Le résultat est exact, sans aucune approximation — mais son coût croît linéairement avec le volume. Sur un million de vecteurs à 768 dimensions, chaque requête déclenche un million de calculs de distance. Sur cent millions, le temps de réponse devient incompatible avec un usage interactif.
Les bases vectorielles de production résolvent ce problème en acceptant une petite perte de précisionprécisionIAProportion des alertes émises par un modèle qui sont justifiées. Elle s'oppose au rappel : améliorer l'une dégrade l'autre.Voir dans le glossaire contre un gain de vitesse considérable : c'est la recherche ANN (Approximate Nearest Neighbors). Au lieu de garantir de trouver exactement les k meilleurs résultats, l'index les trouve avec une très forte probabilité, en explorant seulement une fraction du volume total.
Dès qu'un index utilise une structure approximative, il existe une probabilité non nulle qu'un résultat pertinent n'apparaisse pas dans le top-k renvoyé. Cette probabilité se règle et se mesure, mais elle n'est structurellement jamais nulle — sauf à revenir à une recherche exhaustive. Toute promesse d'un moteur annonçant un rappelrappelIAProportion des cas positifs réels effectivement détectés par un modèle. Sur un jeu déséquilibré, c'est un indicateur bien plus parlant que l'exactitude globale.Voir dans le glossaire « parfait » par défaut mérite d'être vérifiée sur vos propres donnéesdonnéesIAEnsemble d'informations structurées ou non utilisées pour entraîner, évaluer ou alimenter un modèle. La qualité, la quantité et la représentativité des données sont les facteurs décisifs pour les performances en apprentissage automatique.Voir dans le glossaire.
Plusieurs familles d'index coexistent, avec des compromis différents :
- Flat / brute force — recherche exacte, pertinente pour de petits volumes (quelques dizaines de milliers de vecteurs) ou comme référence pour mesurer le rappel d'un index approximatif.
- IVF (Inverted File Index) — le corpus est partitionné en clusters (k-means) à l'indexation ; la requête n'est comparée qu'aux clusters les plus proches. Le paramètre
nprobearbitre entre rappel et vitesse. - HNSW (Hierarchical Navigable Small World) — un graphe multi-couches où chaque point est connecté à ses voisins approximatifs. C'est l'algorithme dominant dans la majorité des bases vectorielles modernes.
- Quantification (PQ, scalaire, binaire) — les vecteurs sont compressés pour réduire la mémoire et accélérer les calculs de distance, au prix d'une perte de précision numérique. Souvent combinée à IVF ou HNSW plutôt qu'utilisée seule.
HNSW : navigation dans un graphe multi-couches
HNSW construit une structure en plusieurs couches empilées. La couche la plus basse (couche 0) contient tous les points indexés, densément connectés à leurs voisins réels. Chaque couche au-dessus contient un sous-ensemble décroissant de points avec des connexions plus longues, qui permettent de « sauter » rapidement à travers l'espace vectoriel.
La recherche démarre au sommet, sur un point d'entrée de la couche la plus haute. À chaque couche, l'algorithme se déplace de voisin en voisin de façon gloutonne — toujours vers le nœud le plus proche du vecteur requête — jusqu'à ne plus pouvoir se rapprocher. Il descend alors d'une couche et répète l'exploration, jusqu'à la couche 0, où une recherche locale plus fine identifie les k meilleurs candidats.
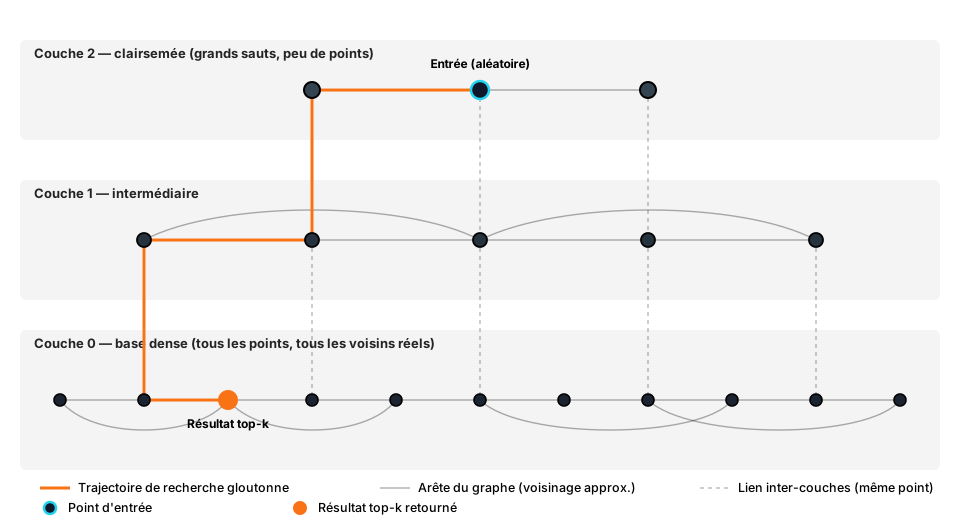
Ce mécanisme explique pourquoi HNSW est rapide et robuste : les couches hautes couvrent de grandes distances en peu de sauts, la couche 0 garantit une exploration locale fine. Le coût de recherche croît de façon logarithmique avec le volume de vecteurs, pas linéairement — ce qui rend l'algorithme praticable sur des centaines de millions de points.
Trois paramètres gouvernent son comportement :
- M — nombre maximal de connexions par nœud. Un M élevé (32-64) améliore le rappel au prix de la mémoire et du temps de construction ; un M faible (8-16) économise la mémoire mais dégrade le rappel, surtout en forte dimensionnalité.
- ef_construction — taille de la liste de candidats explorée à chaque insertion pendant la construction. Une valeur élevée produit un graphe de meilleure qualité mais ralentit l'indexation initiale. Ce paramètre ne se règle qu'une fois.
- ef_search — l'équivalent au moment de la requête. C'est le levier principal pour arbitrer vitesse et rappel sans reconstruire l'index.
M et ef_construction se fixent à la construction et sont coûteux à changer (ré-indexation complète). ef_search, lui, se règle par requête ou par cas d'usage : une recherche exploratoire tolère un ef_search bas, une requête critique en droit ou en support client justifie un ef_search plus élevé, quitte à sacrifier quelques dizaines de millisecondes.
Autre défaut structurel à connaître avant mise en production : les suppressions ne sont pas natives. La plupart des implémentations marquent un point comme supprimé (tombstone) sans retirer réellement ses arêtes, pour ne pas casser la connectivité du graphe. Le point continue donc d'être traversé pendant la recherche, ce qui dégrade la latence au fil du temps si les suppressions s'accumulent sans compaction périodique.
Filtrer par métadonnées : pré-filtrage et post-filtrage
En production, une recherche vectorielle s'accompagne presque toujours d'une contrainte métier : ne chercher que dans les documents d'un client donné, exclure les archives, respecter les droits d'accès de l'utilisateur. Ces contraintes s'expriment via des filtres sur les métadonnées attachées à chaque vecteur.
Deux stratégies combinent filtrage et recherche vectorielle, avec des implications de performance très différentes.
Le post-filtrage exécute d'abord la recherche ANN sur l'ensemble de l'index, récupère un top-k de candidats, puis élimine ceux qui ne respectent pas le filtre. Simple à implémenter, mais dangereux dès que le filtre est sélectif : si seuls 2 % des vecteurs respectent le filtre, un top-20 brut peut ne contenir aucun résultat valide, alors que des dizaines de résultats pertinents existent plus loin dans le classement, jamais atteints.
Le pré-filtrage restreint l'espace de recherche aux vecteurs conformes avant même la traversée du graphe. Plus fiable, mais plus coûteux à implémenter : sur HNSW, filtrer pendant la traversée peut casser l'hypothèse de connectivité et dégrader le rappel si le filtre est très restrictif.
Si une requête filtre sur un attribut rare (client avec peu de documents, langue minoritaire du corpus) et que le moteur applique un post-filtrage naïf, il est possible d'obtenir zéro résultat alors que des documents pertinents existent dans l'index. Avant de conclure qu'un document n'est « pas trouvé par la recherche sémantique », vérifiez comment le moteur combine filtre et recherche vectorielle.
Les moteurs de production modernes (Qdrant, Weaviate, Milvus) implémentent des variantes de filtrage pendant la traversée qui évitent l'essentiel de ce problème. La qualité de cette implémentation varie fortement d'un moteur à l'autre et mérite d'être testée sur des filtres réalistes, pas uniquement sur des requêtes sans filtre.
Recherche hybride : combiner dense et lexical
La recherche vectorielle seule échoue sur certaines requêtes que la recherche lexicale classique (BM25, TF-IDF) résout naturellement : un identifiant produit exact, un code d'erreur, un acronyme rare, un nom propre peu représenté dans le corpus d'entraînement de l'embedding. À l'inverse, la recherche lexicale échoue sur les reformulations et synonymes qu'un embedding capture naturellement.
La recherche hybride combine les deux : un score dense et un score lexical sont calculés en parallèle, puis fusionnés — le plus souvent via une méthode de type reciprocal rank fusion (RRF), qui combine les rangs plutôt que les scores bruts, évitant le problème de deux échelles non comparables.
Un utilisateur cherche « erreur ORA-12154 ». Un embedding généraliste peut rapprocher cette requête de contenus vaguement liés à Oracle, sans faire remonter le ticket exact si le vocabulaire environnant diffère trop. Une recherche lexicale sur cet identifiant le retrouve immédiatement, par correspondance exacte plutôt que sémantique. La recherche hybride combine les deux forces au lieu de choisir entre elles.
La plupart des bases vectorielles de production proposent aujourd'hui un mode hybride natif ou une intégration facile avec un moteur lexical. Ignorer cette option au profit d'un dense pur est un choix qui doit être justifié par le profil réel des requêtes, pas pris par défaut.
Les opérations d'un index vectoriel en production
Un index vectoriel n'est pas une structure figée construite une fois pour toutes. En production, il subit un cycle de vie continu à anticiper dès la conception.
- Insertions et mises à jour. Un document modifié impose de recalculer son embedding et de remplacer le vecteur correspondant. Sur HNSW, une insertion est rapide, mais un volume élevé d'insertions concurrentes peut dégrader temporairement la qualité du graphe si l'implémentation ne les traite pas avec un ef_construction suffisant.
- Suppressions. Le plus souvent un marquage logique (tombstone), pas un retrait physique immédiat. Sans compaction périodique, un corpus à forte rotation de contenu accumule des nœuds fantômes qui ralentissent la recherche sans contribuer à la qualité des résultats.
- Ré-indexation. Changer de modèle d'embedding, ajuster la métrique de distance, ou modifier M et ef_construction impose de reconstruire l'index intégralement. Sur un corpus volumineux, cette opération peut prendre plusieurs heures et doit être planifiée avec une bascule atomique (index parallèle construit hors ligne, puis bascule du trafic) pour éviter une interruption de service.
- Sharding. Au-delà d'un certain volume — typiquement plusieurs dizaines de millions de vecteurs par nœud — l'index doit être partitionné sur plusieurs machines. Chaque requête interroge alors tous les shards concernés et fusionne les résultats, ce qui ajoute de la latence réseau et complique le filtrage global cohérent.
- Sauvegarde et reprise après incident. Un index HNSW en mémoire représente souvent un investissement de calcul important. Une stratégie de snapshot régulier, distincte de la simple sauvegarde des vecteurs bruts, évite de reconstruire l'intégralité de la structure après un incident.
La seule façon fiable de connaître le rappel réel d'un index approximatif est de le comparer à une recherche exhaustive sur un échantillon représentatif de requêtes. Cette mesure doit être répétée après tout changement de paramètre, de modèle d'embedding, ou de volume significatif de données — un index performant à un million de vecteurs peut se dégrader silencieusement à cent millions si ef_search n'est pas réajusté.
Choisir un moteur : repères comparatifs
| Moteur | Index principal | Filtrage natif | Points forts | Point d'attentionattentionIAMécanisme par lequel un modèle pondère l'importance de chaque token du contexte lorsqu'il en traite un autre, quelle que soit la distance qui les sépare.Voir dans le glossaire |
|---|---|---|---|---|
| Qdrant | HNSW | Pré-filtrage pendant la traversée | Performant, API claire, quantification intégrée | Écosystème plus jeune que les alternatives historiques |
| Weaviate | HNSW | Pré-filtrage, hybride natif | Modules d'enrichissement, hybride mature | Consommation mémoire à surveiller sur gros volumes |
| Milvus | HNSW, IVF, autres | Pré-filtrage configurable | Très scalable, adapté aux très gros volumes | Complexité opérationnelle plus élevée à auto-héberger |
| pgvector (PostgreSQL) | HNSW, IVFFlat | Filtrage SQL natif | Cohabite avec les données relationnelles existantes | Moins performant que les moteurs dédiés à très grande échelle |
| Offres managées (Pinecone et équivalents) | HNSW ou variante propriétaire | Pré-filtrage natif | Opérations déléguées, mise à l'échelle transparente | Coût récurrent, dépendance à un fournisseur externe |
Ce tableau ne désigne pas de gagnant universel. Un corpus déjà hébergé dans PostgreSQL et de taille modérée justifie rarement l'ajout d'un moteur vectoriel dédié ; à l'inverse, un volume de centaines de millions de vecteurs avec des exigences de filtrage complexes dépasse vite ce que pgvector gère confortablement.
Checklist avant mise en production
- Le rappel de l'index a été mesuré sur un échantillon représentatif, comparé à une recherche exhaustive, pas simplement supposé correct.
- ef_search est ajustable par cas d'usage, sans nécessiter de reconstruire l'index.
- La stratégie de filtrage (pré ou post) a été testée avec des filtres réalistes, y compris très restrictifs.
- Une politique de compaction ou de ré-indexation périodique existe pour les corpus à forte rotation de contenu.
- La procédure de ré-indexation complète est documentée et testée avant d'en avoir besoin en urgence.
- Le sharding a été anticipé avant d'atteindre la limite pratique d'un nœud unique, pas découvert à la saturation.
- La recherche hybride a été évaluée si le corpus contient des identifiants ou termes exacts fréquemment recherchés.
Pièges fréquents à éviter
- Confondre un index approximatif avec un index exact. Un rappel de 95 % signifie que 5 % des résultats pertinents peuvent structurellement manquer — un chiffre à connaître avant de promettre une exhaustivité au métier.
- Ignorer l'accumulation de tombstones après suppressions massives. La latence se dégrade progressivement sans alerte explicite, jusqu'à ce qu'une compaction devienne nécessaire en urgence.
- Appliquer un post-filtrage naïf sur des attributs sélectifs. Un filtre qui ne conserve que 1 à 5 % du corpus peut renvoyer un résultat vide si le moteur ne prend pas en compte le filtre pendant la traversée du graphe.
- Sous-dimensionner ef_construction pour gagner du temps à l'indexation initiale. La qualité du graphe qui en résulte est difficile à rattraper sans reconstruction complète.
- Négliger la recherche hybride sur des corpus riches en identifiants exacts. Un dense pur échoue régulièrement sur des codes d'erreur ou références produit que la recherche lexicale retrouve sans effort.
- Ne jamais revalider le rappel après un changement de volume ou de modèle d'embedding. Un paramétrage adapté à un million de vecteurs peut se dégrader silencieusement à cent millions.
L'essentiel à retenir
Ce chapitre explique pourquoi une base vectorielle ne compare jamais un vecteur requête à tous les vecteurs indexés au-delà d'un certain volume, et comment les index approximatifs comme HNSW, IVF ou la quantification produisent un compromis entre vitesse, mémoire et rappel. Il détaille le fonctionnement de HNSW — graphe multi-couches, paramètres M, ef_construction et ef_search — car c'est l'algorithme dominant dans la plupart des bases vectorielles de production. Il aborde ensuite le filtrage par métadonnées, la distinction entre pré-filtrage et post-filtrage, et les pièges classiques du filtrage combiné à la recherche approximative. La dernière partie couvre les opérations courantes en production : mise à jour, suppression, ré-indexation, sharding et supervision du rappel dans le temps. Un tableau comparatif des principaux moteurs (Qdrant, Weaviate, Milvus, pgvector, Pinecone) clôt le chapitre pour orienter un choix d'architecture.
Questions fréquentes
HNSW est-il toujours le meilleur choix d'index pour une base vectorielle ?
Que se passe-t-il si j'augmente ef_search au maximum pour chaque requête ?
Pourquoi ma recherche filtrée renvoie-t-elle parfois zéro résultat alors que je sais que des documents correspondants existent ?
Faut-il reconstruire l'index vectoriel à chaque mise à jour de document ?
Quelle différence concrète entre pgvector et un moteur vectoriel dédié comme Qdrant ou Milvus ?
Le rappel d'un index vectoriel peut-il se dégrader dans le temps sans changement de configuration ?
Comment savoir si j'ai besoin de recherche hybride plutôt que de recherche dense pure ?
À partir de quel volume de vecteurs faut-il envisager le sharding ?
Progression sauvegardée dans votre navigateur.
Quiz de validation
Quiz Player
Quiz de validation
Plusieurs réponses possibles — validez ensuite.
Vrai ou faux.
Quiz indisponible (données invalides).