





Sécurité et confidentialité des données
Comment protéger un système RAG contre les fuites de données entre utilisateurs, gérer les informations personnelles à chaque étape du pipeline et bâtir une journalisation exploitable sans devenir elle-même un risque.
Table des matières
Pourquoi ce chapitre est le plus utile
Un pipeline RAGRAGIATechnique consistant à rechercher les documents pertinents et à les fournir au modèle dans son contexte. Elle permet des réponses à jour et citables, ce que l'affinage ne permet pas.Voir dans le glossaire en production n'est pas seulement un problème de pertinence : c'est un système qui lit des documents internes, les découpe, les vectorise, les stocke, puis les réinjecte dans un promptpromptIAConsigne ou contexte fourni à un modèle de langage pour orienter sa réponse. La qualité du prompt conditionne souvent la qualité du résultat.Voir dans le glossaire envoyé à un modèle — parfois hébergé chez un tiers. Chacune de ces étapes est un point où une donnée qui n'aurait jamais dû sortir d'un service peut se retrouver dans la réponse d'un autre utilisateur, dans un log, ou dans un cache partagé.
La spécificité du RAG par rapport à une application classique est double. D'abord, la recherche sémantique ne raisonne pas en permissions : un moteur vectoriel renvoie les passages les plus proches d'une requête, indépendamment du fait que l'utilisateur ait le droit de les lire. Ensuite, le contenu récupéré est injecté tel quel dans un contextefenêtre de contexteIAQuantité de texte qu'un modèle peut prendre en compte simultanément : question, documents fournis et historique. Au-delà, les éléments les plus anciens sortent du champ.Voir dans le glossaire de génération, ce qui veut dire qu'une fuite de contrôle d'accès en amont devient une fuite de contenu en clair dans la réponse du modèle. Un bug d'ACL sur un moteur de recherche classique renvoie un document dans une liste de résultats ; le même bug sur un RAG peut faire réciter mot pour mot le contenu d'un document confidentiel.
Dans un RAG, le contrôle d'accès n'est jamais optionnel ni ajoutable après coup. S'il n'est pas conçu dès le schéma d'indexation, il faudra réindexer l'intégralité du corpus pour le corriger — ce qui, sur un corpus de plusieurs millions de chunks, se chiffre en jours de traitement et en interruption de service.
Modèle de menace propre au RAG
Avant de choisir des mécanismes, il faut lister ce contre quoi on se protège. Un système RAG en environnement multi-utilisateur ou multi-organisation expose plusieurs surfaces d'attaque distinctes :
- Fuite inter-utilisateurs — un utilisateur A obtient, via une réponse générée, des informations issues d'un document auquel seul l'utilisateur B a accès.
- Fuite inter-tenants — dans une architecture SaaS multi-clients, un client obtient des donnéesdonnéesIAEnsemble d'informations structurées ou non utilisées pour entraîner, évaluer ou alimenter un modèle. La qualité, la quantité et la représentativité des données sont les facteurs décisifs pour les performances en apprentissage automatique.Voir dans le glossaire appartenant à un autre client à cause d'un index mal isolé.
- Exfiltration par injection de promptInjection de promptCybersécuritéAttaque visant à détourner un LLM en insérant des instructions malveillantes dans le contexte (entrée utilisateur, document RAG, etc.).Voir dans le glossaire — un contenu malveillant inséré dans un document indexé instruit le modèle à révéler des informations issues d'autres passages du contexte, ou à ignorer les consignes de filtrage.
- Fuite sémantique par les embeddingsembeddingIAReprésentation numérique dense d'un texte, d'une image ou d'un objet dans un espace vectoriel, utilisée pour la similarité et la recherche sémantique.Voir dans le glossaire — même sans accès au texte brut, un attaquant capable d'interroger l'espace vectoriel peut parfois reconstruire des informations sensibles par proximité sémantique.
- Fuite via les journaux — des logs contenant les requêtes et passages en clair deviennent un second système à sécuriser au même niveau que la base documentaire.
- Fuite via le cache — un cache partagé entre utilisateurs peut renvoyer une réponse calculée pour un utilisateur autorisé à un utilisateur qui ne l'est pas.
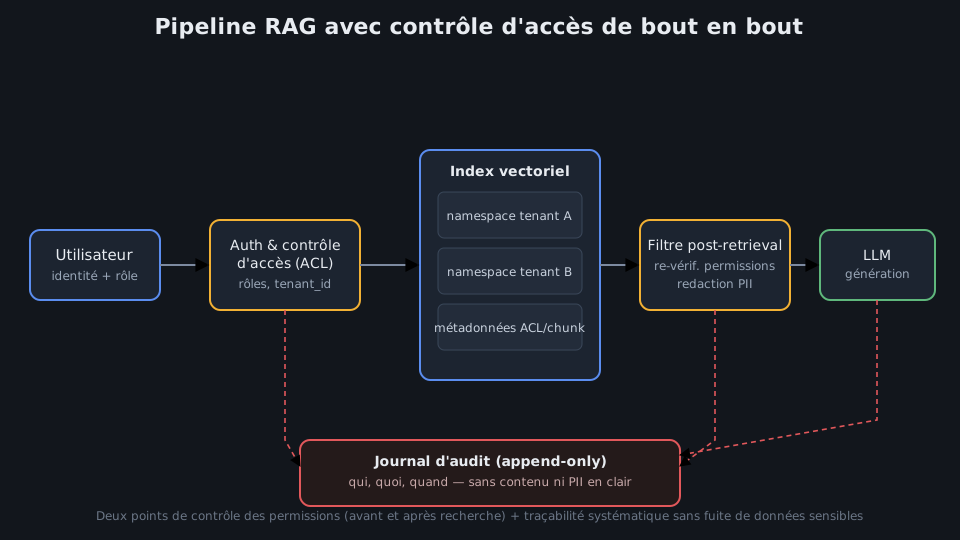
Contrôle d'accès au niveau des chunks
La règle de base est simple à énoncer et souvent difficile à appliquer correctement : chaque chunk indexé doit porter les métadonnées de permission du document dont il est issu, et ces métadonnées doivent être vérifiées à chaque requête, pas seulement au moment de l'ingestion.
En pratique, cela signifie associer à chaque vecteur stocké un ensemble de champs comme owner_id, tenant_id, groupes_autorises, niveau_confidentialité. La recherche vectorielle n'est alors pas un simple top-k sur la similarité cosinus : c'est une requête filtrée, où le moteur ne considère que les vecteurs dont les métadonnées correspondent aux droits de l'utilisateur courant.
Deux approches coexistent selon les moteurs vectoriels :
- Filtrage natif (pre-filtering) — le moteur applique le filtre de métadonnées avant ou pendant la recherche approximative (ANN), garantissant que seuls les candidats autorisés sont considérés. C'est la méthode la plus sûre, supportée nativement par la plupart des bases vectorielles récentes.
- Filtrage a posteriori (post-filtering) — la recherche renvoie le top-k sans filtre, puis l'application retire les résultats non autorisés. Cette méthode est risquée : si tous les résultats les plus proches appartiennent à un document non autorisé, le filtrage a posteriori peut renvoyer une liste vide ou tronquée, et surtout elle repose sur la discipline de l'équipe applicative pour ne jamais oublier ce filtre dans un des chemins de code.
Un filtrage appliqué uniquement côté application, après la recherche vectorielle, est fragile par construction : il suffit d'un endpoint de debug, d'un script d'admin ou d'une nouvelle route qui oublie d'appeler la fonction de filtrage pour exposer des données. Le filtrage doit être imposé au niveau de la requête vers le moteur de recherche lui-même, jamais laissé à la discipline du code applicatif.
La granularité du contrôle d'accès doit être pensée dès la conception du schéma de chunking. Un document peut contenir des sections avec des niveaux de confidentialité différents — un contrat avec une clause financière annexée, par exemple. Si le chunking traverse cette frontière, un chunk peut mélanger du contenu public et du contenu restreint, rendant impossible un filtrage propre au niveau du chunk. La bonne pratique consiste à aligner les frontières de chunking sur les frontières de permission au moment du découpageChunkingIADécoupage d'un document en segments de taille fixe ou sémantique avant indexation vectorielle, pour optimiser la récupération RAG.Voir dans le glossaire, quitte à accepter des chunks plus petits sur les sections sensibles.
Isolation multi-tenant
Dans une architecture SaaS où plusieurs organisations clientes partagent la même infrastructure, l'isolation multi-tenant est un cran au-dessus du simple ACL par utilisateur : il s'agit d'empêcher structurellement qu'une requête d'un tenant puisse atteindre les données d'un autre, même en cas de bug applicatif.
Trois niveaux d'isolation sont possibles, du moins au plus coûteux :
| Niveau | Mécanisme | Isolation obtenue | Coût opérationnel |
|---|---|---|---|
| Filtrage par métadonnée | Un seul index, champ tenant_id filtré à chaque requête |
Logique, dépend du code applicatif | Faible |
| Namespace / collection dédiée | Un espace de noms ou une collection par tenant dans le même moteur | Physique côté stockage, logique côté accès réseau | Moyen |
| Instance ou index physiquement séparé | Base vectoriellebase vectorielleIABase spécialisée qui indexe des embeddings pour retrouver rapidement les passages les plus proches d'une requête (cœur du RAG).Voir dans le glossaire dédiée par tenant, parfois chiffrée avec une clé propre | Physique complète | Élevé |
Le filtrage par métadonnée seul suffit pour un usage interne avec peu d'utilisateurs et un code maîtrisé. Dès qu'il y a des enjeux contractuels ou réglementaires — un client qui exige explicitement que ses données ne transitent jamais dans le même espace mémoire qu'un concurrent — les namespaces dédiés deviennent le minimum acceptable, et l'instance séparée devient nécessaire pour les tenants les plus sensibles (secteur bancaire, santé, défense).
Une équipe migre son moteur de recherche vectorielle et réécrit la couche de requête. Le nouveau code fonctionne parfaitement en test, avec un seul tenant de données de démonstration. En production, le paramètre de filtre
tenant_idn'est pas propagé dans un des deux chemins d'appel (recherche interactive vs. recherche par lot), et les utilisateurs du tenant B commencent à recevoir occasionnellement des passages issus des documents du tenant A. Le bug reste invisible pendant plusieurs semaines car il ne se déclenche que sur certaines requêtes. Une isolation par namespace physique aurait rendu ce bug impossible : le code aurait simplement interrogé le mauvais namespace et renvoyé un résultat vide plutôt qu'un résultat appartenant à un autre tenant.
Gestion des données personnelles (PII)
Les informations personnelles identifiables — noms, adresses, numéros de téléphone, identifiants internes, données de santé — posent un problème spécifique au RAG : une fois indexées sous forme d'embedding, elles ne disparaissent pas simplement parce qu'on supprime le document source de la base documentaire principale. L'embedding et le texte du chunk restent dans l'index vectoriel jusqu'à suppression explicite.
La gestion des PII dans un pipeline RAG se joue à trois moments :
Avant l'indexation. Un détecteur de PII (regex pour les formats structurés comme les emails et numéros de téléphone, modèle de reconnaissance d'entités nommées pour les noms propres et adresses) passe sur chaque document avant chunking. Selon la politique retenue, les PII détectées sont soit retirées, soit remplacées par un jeton générique ([PERSONNE], [EMAIL]), soit conservées si leur présence est nécessaire à l'utilité du système et couverte par une base légale claire.
Au moment du retrieval. Même si les PII n'ont pas été retirées à l'indexation, un filtre supplémentaire peut s'appliquer sur les chunks retournés avant qu'ils n'entrent dans le prompt, en fonction du rôle de l'utilisateur qui interroge le système. Un chargé de recrutement peut avoir le droit de voir des CV complets ; un utilisateur d'un chatbot RH généraliste ne devrait voir aucune donnée personnelle d'un tiers.
Dans la réponse générée. Un dernier filtre peut inspecter la sortie du modèle avant de l'afficher, en particulier pour intercepter les cas où le modèle reformule ou combine des informations de façon à révéler une PII qui n'apparaissait pas telle quelle dans un chunk isolé.
Le contrôle le plus fiable reste de ne jamais indexer une donnée dont le système n'a pas besoin. Un pipeline d'ingestion qui applique une politique de minimisation — ne conserver que les champs utiles à la mission du RAG — réduit la surface de risque bien plus efficacement qu'un empilement de filtres correctifs en aval. Se poser la question « ce champ est-il nécessaire à la réponse que ce système doit produire ? » avant l'indexation évite une bonne partie des problèmes traités plus loin dans ce chapitre.
Cette logique de minimisation rejoint les obligations réglementaires classiques (RGPDRGPDConformitéRèglement européen sur la protection des données personnelles. Il s'applique dès qu'un système d'IA traite de telles données, et se cumule avec l'AI Act.Voir dans le glossaire en Europe notamment) : la base légale du traitement doit couvrir l'usage réellement fait de la donnée, y compris son passage dans un contexte de génération envoyé potentiellement à une API tierce. Le droit à l'effacement pose un défi concret pour le RAG : supprimer un enregistrement dans la base source ne suffit pas, il faut également purger le ou les chunks correspondants dans l'index vectoriel, ce qui suppose une traçabilité entre document source et vecteurs indexés dès la conception du pipeline.
Chiffrement et gestion des clés
Le chiffrementchiffrementCybersécuritéTransformation d'une donnée lisible en une forme inintelligible à l'aide d'une clé. Le destinataire disposant de la clé peut retrouver le message original. C'est le socle de la confidentialité sur Internet.Voir dans le glossaire protège contre un scénario différent de celui de l'ACL : l'accès non autorisé au stockage lui-même, plutôt qu'un mauvais filtrage applicatif. Deux couches sont à couvrir :
- Chiffrement en transit — TLSTLSRéseauxProtocole cryptographique assurant confidentialité et intégrité des communications applicatives (notamment HTTPS).Voir dans le glossaire entre chaque composant du pipeline (application, moteur de recherche vectorielle, service d'embedding, API du LLMLLMIAGrand modèle de langage (Large Language Model) entraîné sur d'énormes corpus pour prédire et générer du texte.Voir dans le glossaire), sans exception, y compris pour les appels internes dans le même cluster.
- Chiffrement au repos — les vecteurs, les métadonnées et les textes de chunks stockés doivent être chiffrés sur disque. La plupart des bases vectorielles managées le proposent nativement ; pour un déploiement auto-hébergé, cela dépend de la configuration du volume de stockage sous-jacent.
La gestion des clés mérite une attentionattentionIAMécanisme par lequel un modèle pondère l'importance de chaque token du contexte lorsqu'il en traite un autre, quelle que soit la distance qui les sépare.Voir dans le glossaire particulière dans un contexte multi-tenant sensible : une clé de chiffrement dédiée par tenant permet de révoquer l'accès à l'ensemble des données d'un client en révoquant une seule clé, sans avoir à identifier et supprimer individuellement chaque enregistrement concerné.
Le chiffrement au repos protège les données sur disque contre un accès non autorisé au stockage brut, mais il n'empêche pas la recherche vectorielle de fonctionner normalement : le moteur déchiffre les données en mémoire au moment de la requête, sous réserve que le processus qui exécute la recherche dispose lui-même des permissions et clés nécessaires. Le chiffrement ne remplace donc jamais le contrôle d'accès applicatif décrit plus haut — les deux mécanismes répondent à des menaces différentes et se combinent.
Journalisation et audit sans fuite
Un système RAG en production a besoin de journaux : pour déboguer une réponse incorrecte, pour mesurer la qualité du retrieval, pour répondre à un audit de sécurité. Mais journaliser naïvement la requête complète de l'utilisateur, les passages récupérés et la réponse générée revient à dupliquer l'intégralité des données sensibles dans un second système — souvent moins bien protégé que la base documentaire principale, et conservé plus longtemps que nécessaire.
Une politique de journalisation raisonnable distingue plusieurs niveaux d'information :
- Métadonnées d'exécution — horodatage, identifiant utilisateur, identifiant de requête, latence, nombre de chunks récupérés, score de confiance. Ces informations ne contiennent pas de contenu métier et peuvent être conservées longtemps sans risque particulier.
- Identifiants de documents — plutôt que le texte des chunks récupérés, journaliser leurs identifiants permet de reconstituer le contexte d'une réponse a posteriori (pour un débogage) sans dupliquer le contenu sensible dans le système de logs.
- Contenu en clair — requêtes complètes, texte des passages, réponse générée. Ce niveau ne devrait être activé que temporairement, sur un périmètre restreint, pour investiguer un incident précis, avec une durée de rétention courte et un accès limité aux personnes habilitées.
Cette approche par paliers permet de répondre à la plupart des besoins de debugging et de conformité (qui a demandé quoi, quand, sur quels documents) sans transformerTransformerIAArchitecture introduite en 2017, fondée sur le mécanisme d'attention, qui traite une séquence entière en parallèle. Elle sert de base à tous les grands modèles de langage actuels.Voir dans le glossaire le système de logs en copie parallèle non protégée du corpus documentaire. Un cache de réponses ou d'embeddings mérite le même traitement qu'un journal : il conserve, par nature, une trace de requêtes et de résultats associés, et doit donc être soumis aux mêmes règles de partitionnement par ACL et par tenant que l'index principal — sans quoi il devient le point de fuite le plus simple à exploiter, puisqu'il court-circuite les contrôles mis en place sur le chemin de recherche normal.
Re-vérification post-retrieval : la double barrière
Même avec un filtrage rigoureux au niveau de la recherche, il est recommandé d'ajouter une seconde vérification juste avant l'assemblage du prompt final. Cette double barrière protège contre deux classes d'erreurs différentes : un bug dans le filtre de recherche (le premier contrôle), et un changement de permissions survenu entre l'indexation d'un document et le moment de la requête (par exemple, un utilisateur retiré d'un groupe après que ses anciens documents ont été indexés avec l'ancienne appartenance).
Cette seconde vérification est généralement moins coûteuse que la première, car elle porte sur un petit nombre de chunks déjà récupérés (typiquement 5 à 20) plutôt que sur l'ensemble de l'index. Elle peut réutiliser directement les métadonnées stockées avec chaque chunk, sans nouvel appel au moteur de recherche.
Checklist de déploiement sécurisé
Avant de mettre en production un pipeline RAG manipulant des données sensibles, il est utile de vérifier systématiquement les points suivants :
- Chaque chunk indexé porte des métadonnées de permission cohérentes avec le document source.
- Le filtrage par permission est appliqué au niveau de la requête vers le moteur vectoriel, pas seulement en post-traitement applicatif.
- Les tenants sont isolés au niveau adapté à la sensibilité contractuelle (métadonnée, namespace ou instance dédiée).
- Un processus de détection de PII s'exécute avant l'indexation, avec une politique explicite de traitement (suppression, jeton, conservation justifiée).
- Le chiffrement en transit et au repos est activé sur l'ensemble des composants, avec une gestion de clés adaptée au multi-tenant si applicable.
- La journalisation suit une politique par paliers, sans duplication systématique du contenu sensible en clair.
- Tout cache partagé (réponses, embeddings) applique les mêmes règles de partitionnement que l'index principal.
- Une seconde vérification des permissions s'exécute après le retrieval, juste avant l'assemblage du prompt.
- Un processus de suppression permet de purger un document et l'ensemble de ses chunks dérivés sur simple demande.
Aucun de ces points n'est optionnel dès lors que le corpus contient des données confidentielles ou personnelles. Ils forment ensemble une défense en profondeur : chaque couche compense les failles possibles des autres, plutôt que de reposer sur un unique mécanisme supposé infaillible.
L'essentiel à retenir
Un système RAG multiplie les points où une donnée sensible peut fuiter : indexation, recherche, contexte transmis au modèle, logs. Ce chapitre détaille comment mettre en place des listes de contrôle d'accès au niveau des chunks, isoler correctement plusieurs tenants dans un même index vectoriel, détecter et traiter les informations personnelles avant et après indexation, et concevoir une politique de journalisation qui reste utile en production sans exposer de données confidentielles. Il couvre aussi les pièges spécifiques au RAG : fuite sémantique par les embeddings, cache partagé entre utilisateurs, et re-vérification des permissions après le retrieval.
Questions fréquentes
Faut-il chiffrer un index vectoriel même s'il ne contient que des embeddings et pas le texte brut ?
Un filtrage par métadonnée tenant_id suffit-il pour un déploiement interne à une seule entreprise ?
Comment supprimer réellement un document d'un système RAG, y compris ses traces indirectes ?
Un détecteur de PII automatique est-il fiable à 100 % ?
Le chiffrement au repos protège-t-il contre une fuite entre utilisateurs du même système ?
Pourquoi le chunking peut-il lui-même créer un risque de sécurité ?
Comment tester qu'un pipeline RAG n'expose pas de données entre utilisateurs avant sa mise en production ?
Progression sauvegardée dans votre navigateur.
Quiz de validation
Quiz Player
Quiz de validation
Plusieurs réponses possibles — validez ensuite.
Vrai ou faux.
Quiz indisponible (données invalides).