





Bonnes pratiques et sécurité
Comment cadrer l'accès de Claude Code à vos fichiers et secrets, instaurer une revue systématique de ses actions, et poser une politique d'équipe cohérente.
Table des matières
Pourquoi ce chapitre change de registre
Dans les chapitres précédents, vous avez appris à formuler des demandes, à utiliser le mode plan, à laisser Claude CodeClaude CodeIAInterface en ligne de commande agentique qui lit, édite et exécute des actions dans un dépôt de code sous contrôle de permissions, par opposition à un simple chat web.Voir dans le glossaire lire et modifier votre projet. Cette mécanique fonctionne parce que l'agentagentIASystème qui enchaîne des appels d'outils de façon autonome pour atteindre un objectif : il planifie, agit, observe, recommence. Sa fiabilité décroît exponentiellement avec le nombre d'étapes.Voir dans le glossaire dispose d'outilstool callingIACapacité d'un agent ou d'un LLM à invoquer des outils externes (API, calcul, recherche) pendant le raisonnement.Voir dans le glossaire réels : il lit des fichiers, en écrit, exécute des commandes, parfois interroge des services externes via MCPMCPIAModel Context Protocol : protocole permettant de brancher des outils et sources externes (docs, tickets, bases) à un agent LLM via des serveurs dédiés.Voir dans le glossaire. C'est précisément ce qui distingue un agent CLIAgent CLIIAProgramme en terminal qui enchaîne raisonnement et outils (lecture, édition, commandes) pour accomplir une tâche dans un environnement local.Voir dans le glossaire d'un chat web classique — et c'est ce qui déplace la question de sécurité.
Dans un chat web, le risque principal est que le texte produit soit faux ou mal formulé. Avec Claude Code, le risque se déplace vers l'action : un fichier supprimé par erreur, un secret recopié dans un commit, une commande exécutée sur le mauvais répertoire. Le contenu généré n'est plus la seule surface de risque — l'exécution en est une seconde, distincte, qui mérite ses propres réflexes.
Un agent qui peut agir sur votre système de fichiers et exécuter des commandes doit être traité avec la même rigueur qu'un nouveau collaborateur technique : on ne lui donne pas un accès total le premier jour, et on relit son travail avant de le considérer acquis.
Le périmètre d'action : ce que l'agent peut toucher
Claude Code opère par défaut dans le répertoire de travail depuis lequel il est lancé, et dans ses sous-dossiers. Cette portée n'est pas un détail technique : c'est la première ligne de défense. Lancer l'outil depuis la racine d'un disque, ou depuis un dossier contenant plusieurs projets sans rapport, élargit inutilement ce que l'agent peut lire ou modifier.
Quelques principes simples réduisent la surface de risque :
- Lancer Claude Code depuis la racine du projet concerné, pas depuis un dossier parent qui contiendrait d'autres projets, des documents personnels ou des sauvegardes.
- Séparer les environnements : un dossier de travail dédié pour les expérimentations, distinct du dépôt de production.
- Vérifier régulièrement le contextefenêtre de contexteIAQuantité de texte qu'un modèle peut prendre en compte simultanément : question, documents fournis et historique. Au-delà, les éléments les plus anciens sortent du champ.Voir dans le glossaire : un
pwdou une lecture de l'arborescence en début de session permet de confirmer que le périmètre est bien celui attendu.
Le fichier CLAUDE.md, déjà présenté dans un chapitre précédent comme mémoire de projet, joue ici un second rôle : il peut consigner des consignes de sécurité propres au projet — dossiers à ne jamais toucher, conventions de commit, rappelrappelIAProportion des cas positifs réels effectivement détectés par un modèle. Sur un jeu déséquilibré, c'est un indicateur bien plus parlant que l'exactitude globale.Voir dans le glossaire sur les secrets. Ce n'est pas un mécanisme de sécurité technique, mais un cadrage que l'agent lit et respecte dans son comportement.
Secrets et fichiers .env
Les secrets — clés d'API, jetons d'authentification, mots de passe de base de donnéesdonnéesIAEnsemble d'informations structurées ou non utilisées pour entraîner, évaluer ou alimenter un modèle. La qualité, la quantité et la représentativité des données sont les facteurs décisifs pour les performances en apprentissage automatique.Voir dans le glossaire — sont la catégorie de donnée la plus sensible à laquelle un agent de développement est exposé, simplement parce qu'ils vivent dans les mêmes fichiers que le code.
Un fichier
.envlu par erreur peut voir son contenu recopié dans une réponse, un commit, ou un fichier de log. Ce n'est pas une défaillance de l'agent : c'est une conséquence directe du fait qu'il traite ce fichier comme n'importe quel autre texte, sauf si on l'en empêche.
Les réflexes qui limitent ce risque :
- Exclure systématiquement les fichiers de secrets du périmètre travaillé. Un
.gitignorecorrectement renseigné (.env,.env.local,*.pem,secrets/) protège aussi bien contre un commit accidentel que contre une lecture non nécessaire. - Ne jamais coller un secret en clair dans une instruction. Si une clé doit être utilisée pour un test, elle doit venir d'une variable d'environnement déjà chargée par le système, pas d'un texte tapé dans la conversation.
- Révoquer un secret qui a fuité, même partiellement. Si un tokentokenIAFragment de texte manipulé par un modèle de langage, généralement plus court qu'un mot — trois à quatre caractères en français. La tarification et la limite de contexte se comptent en tokens.Voir dans le glossaire apparaît dans une sortie de commande, un log, ou un message, considérez-le compromis et régénérez-le. C'est plus rapide et plus sûr que d'essayer d'évaluer si la fuite a eu des conséquences.
- Ne pas stocker de secrets dans
CLAUDE.md. Ce fichier est fait pour du contexte de projet, pas pour des identifiants — il est souvent versionné et partagé avec l'équipe.
Une demande du type « connecte-toi à l'API de facturation avec la clé dans
.envet vérifie le dernier webhook » pousse naturellement l'agent à lire ce fichier. Préférez formuler la tâche de façon à ce que la clé reste chargée en variable d'environnement système, invisible du contenu qu'il manipule directement — par exemple en s'appuyant sur un script existant qui la lit lui-même au runtime, plutôt que de demander à l'agent de l'extraire.
Ne jamais committer aveuglément
Un agent peut proposer, voire exécuter, des commandes Git. C'est un gain de temps réel — jusqu'au moment où un commit part avec un fichier qui n'aurait pas dû y être : un secret oublié, un fichier de configuration local, un jeu de données de test contenant des informations réelles.
Un commit poussé sur un dépôt partagé n'est pas simplement réversible en local : même après un revert, le secret reste visible dans l'historique Git tant qu'il n'a pas été purgé activement, et il a pu être répliqué par quiconque a cloné ou fetché le dépôt entre-temps.
Avant tout commit proposé par l'agent :
- Relire la liste des fichiers ajoutés (
git status,git diff --staged) plutôt que de valider un message générique du type « ajoute les changements ». - Vérifier qu'aucun fichier de secret, de configuration locale ou de données sensibles ne figure dans le diff.
- Refuser un commit trop large. Si l'agent propose d'ajouter l'ensemble du répertoire de travail en une seule commande, demandez un ajout fichier par fichier quand le contexte est sensible.
- Garder le contrôle du push. La création d'un commit local et son envoi vers un dépôt distant sont deux actions différentes ; la seconde a un impact visible par d'autres personnes et mérite une validation explicite, séparée de la première.
La revue systématique : un réflexe, pas une option
Le mode plan, présenté dans un chapitre précédent, sert à valider une intention avant l'exécution. La revue des diffs sert à valider le résultat après. Les deux sont complémentaires, aucun ne remplace l'autre.
Prenez l'habitude de lire un diff comme vous liriez celui d'un collègue en pull request : pas seulement « est-ce que ça compile », mais « est-ce que je comprends pourquoi chaque ligne a changé ». Une modification que vous ne savez pas justifier est un signal à creuser, pas à ignorer.
Cette revue devient particulièrement importante quand :
- La tâche touche à l'authentification, aux permissions ou au paiement — les zones où une erreur silencieuse a le plus de conséquences.
- L'agent a modifié plus de fichiers que prévu, signe possible d'un effet de bord non anticipé.
- Une commande a été exécutée avec des droits élevés (accès réseau, écriture hors du projet, suppression de fichiers).
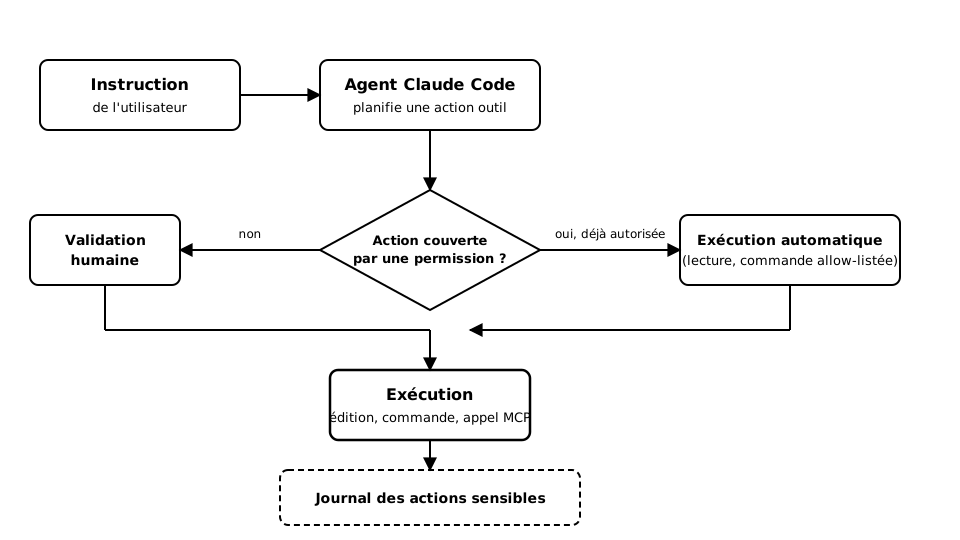
Le système de permissions de Claude Code distingue les actions à faible risque, généralement autorisées sans confirmation après un premier accord (lecture de fichiers, par exemple), des actions plus sensibles qui déclenchent une demande explicite avant exécution — modification de fichiers, commandes shell, accès réseau. Cette distinction n'est pas figée : elle se configure selon le niveau de confiance que vous accordez à un projet donné. Sur un dépôt de production ou un environnement partagé, il est raisonnable de garder les demandes de confirmation actives même pour des actions que vous autoriseriez sans hésiter sur un projet personnel.
Données personnelles et données clients
Un projet réel manipule rarement des données purement techniques. Bases de test avec de vrais emails, exports clients, tickets de support contenant des informations personnelles : ce type de contenu peut se retrouver dans le périmètre d'une session sans que ce soit l'intention de départ.
Le risque n'est pas que l'agent « retienne » ces données au-delà de la session — il n'a pas de mémoire persistante entre les sessions au sens d'un apprentissage. Le risque concret est que ces données transitent dans des fichiers de sortie, des logs, ou des commits, où elles deviennent plus difficiles à contenir.
Quelques principes pour ce cas de figure :
- Anonymiser ou tronquer les jeux de données de test avant de les exposer à une session de travail, plutôt que d'utiliser un export de production tel quel.
- Éviter de demander à l'agent de manipuler des données clients réelles pour des tâches de débogage — un jeu de données synthétique reproduit généralement le même problème technique sans exposer d'information réelle.
- Se référer à la politique de protection des données de l'organisation — RGPDRGPDConformitéRèglement européen sur la protection des données personnelles. Il s'applique dès qu'un système d'IA traite de telles données, et se cumule avec l'AI Act.Voir dans le glossaire ou équivalent local — de la même façon que pour tout autre traitement outillé. Un agent qui exécute des commandes ne change rien aux obligations légales sur le traitement des données personnelles ; il en est un canal supplémentaire, pas une exception.
Journaliser les actions sensibles
Sur un projet individuel, la mémoire de ce qui a été fait suffit souvent. Sur un projet d'équipe ou en environnement de production, elle ne suffit plus : il faut pouvoir répondre a posteriori à la question « qu'est-ce qui a été exécuté, quand, et par quelle session ».
La journalisation des actions sensibles répond à trois besoins distincts :
| Besoin | Ce que ça permet |
|---|---|
| Traçabilité | Retrouver l'origine d'un changement inattendu dans le code ou l'infrastructure |
| Conformité | Démontrer, en cas d'audit, que les accès à des données sensibles ont été encadrés |
| Amélioration continue | Identifier les schémas de demandes qui produisent le plus souvent des corrections a posteriori |
En pratique, cela se traduit par des habitudes simples : conserver l'historique des sessions plutôt que de le purger systématiquement, documenter dans le message de commit qu'une tâche a été réalisée avec assistance d'un agent quand la convention d'équipe le demande, et consigner les incidents — même mineurs — pour affiner les consignes du projet au fil du temps.
Un incident traité correctement — secret révoqué, commit corrigé, cause identifiée — vaut mieux qu'un incident dissimulé : la transparence sur ce qui s'est mal passé est ce qui permet d'ajuster CLAUDE.md et les permissions pour la suite.
Politique d'équipe : cadrer l'usage collectif
Dès qu'un agent CLI est utilisé par plusieurs personnes sur un même dépôt, les habitudes individuelles ne suffisent plus — il faut une politique explicite, même minimale. Elle gagne à couvrir :
- Le niveau de permission par défaut sur les dépôts partagés, et qui a le droit de l'assouplir.
- Les dossiers ou fichiers exclus de toute session agent (secrets, données de production, infrastructure critique).
- La convention de revue : un commit ou une pull request générés avec assistance d'un agent suit-il le même circuit de revue que tout autre changement, ou un circuit renforcé ?
- La procédure en cas d'incident : qui prévenir, comment révoquer un secret exposé, où consigner ce qui s'est passé.
- Les cas d'usage exclus : certaines organisations choisissent d'interdire l'usage d'un agent sur certains répertoires sensibles (paie, données de santé, secrets d'infrastructure) indépendamment des permissions techniques disponibles.
Une politique d'équipe efficace n'a pas besoin d'être longue. Elle doit surtout être connue et appliquée de façon homogène — un document de sécurité que personne ne lit ne protège rien.
Checklist avant de lancer une session
Avant de démarrer un travail avec Claude Code sur un projet sensible, quelques vérifications rapides évitent la majorité des incidents :
- Le répertoire de lancement correspond-il exactement au projet visé, sans dossier parent superflu ?
- Le
.gitignoreexclut-il bien les fichiers de secrets et de configuration locale ? - Les données manipulées sont-elles réelles ou synthétiques, et cela correspond-il à ce que la tâche exige ?
- Le niveau de permission actif est-il cohérent avec la sensibilité du projet ?
- Existe-t-il une politique d'équipe applicable à ce dépôt, et est-elle respectée ?
Cette checklist n'a rien d'exceptionnel : c'est la même rigueur que pour n'importe quel outil qui a un accès en écriture à votre système. Ce qui change avec un agent, c'est le volume d'actions qu'il peut enchaîner rapidement — ce qui rend la vérification en amont plus rentable que la correction en aval.
L'essentiel à retenir
Claude Code agit avec des outils qui lisent, modifient et exécutent — ce qui déplace la question de sécurité du contenu généré vers les actions effectuées. Ce chapitre détaille comment protéger les secrets et fichiers .env, limiter le périmètre d'accès, éviter les commits aveugles, mettre en place une revue systématique des diffs, et traiter les données personnelles ou clients avec prudence. Il couvre aussi la journalisation des actions sensibles et les éléments d'une politique d'équipe pour un usage collectif cohérent.
Questions fréquentes
Si je supprime un secret d'un fichier après un commit, est-ce suffisant ?
Est-ce que Claude Code retient les données sensibles qu'il a vues d'une session à l'autre ?
Faut-il désactiver toutes les demandes de confirmation pour aller plus vite ?
Le fichier CLAUDE.md peut-il servir à stocker des identifiants pour éviter de les retaper ?
Comment traiter un jeu de données de test qui contient de vraies informations clients ?
Qui est responsable si un agent exécute une action qui cause un incident ?
Une politique d'équipe doit-elle être très détaillée pour être utile ?
Progression sauvegardée dans votre navigateur.
Quiz de validation
Quiz Player
Quiz de validation
Plusieurs réponses possibles — validez ensuite.
Vrai ou faux.
Quiz indisponible (données invalides).