





Premiers workflows utiles
Cinq recettes opérationnelles pour un usage quotidien de Claude Code — expliquer un bug, proposer un patch, écrire des tests, mener un refactor borné, réviser un diff — avec des critères d'acceptation posés avant toute exécution.
Table des matières
Pourquoi des workflows plutôt que des prompts isolés
Une fois l'installation validée et le premier lancement effectué, la vraie question devient opérationnelle : que fait-on, concrètement, avec Claude CodeClaude CodeIAInterface en ligne de commande agentique qui lit, édite et exécute des actions dans un dépôt de code sous contrôle de permissions, par opposition à un simple chat web.Voir dans le glossaire au quotidien ? Ce chapitre présente cinq recettes éprouvées — expliquer un bug, proposer un patch, écrire ou étendre des tests, mener un refactor borné, réviser un diff Git — et surtout la discipline qui les rend fiables : un critère d'acceptation explicite, posé avant que l'agentagentIASystème qui enchaîne des appels d'outils de façon autonome pour atteindre un objectif : il planifie, agit, observe, recommence. Sa fiabilité décroît exponentiellement avec le nombre d'étapes.Voir dans le glossaire ne touche au code.
Un promptpromptIAConsigne ou contexte fourni à un modèle de langage pour orienter sa réponse. La qualité du prompt conditionne souvent la qualité du résultat.Voir dans le glossaire isolé du type « corrige ce bug » produit un résultat imprévisible, parce qu'il ne définit ni le périmètre de l'intervention ni le signal de réussite. Un workflow, à l'inverse, découpe la tâche en étapes vérifiables : comprendre, proposer, réviser, exécuter, valider. Chaque étape produit un artefact inspectable — une explication, un plan, un diff, un rapport de tests — avant d'autoriser la suivante.
Claude Code est un agent outillé : il lit des fichiers, exécute des commandes et modifie le dépôt sous les permissions que vous accordez. Ce n'est pas un chat web qui se contente de suggérer du texte à copier ailleurs — chaque action proposée a un effet réel sur votre environnement de travail. La discipline de revue décrite dans ce chapitre n'est donc jamais optionnelle, même sur des tâches qui semblent triviales.
Le principe commun : proposer, réviser, valider
Les cinq workflows qui suivent partagent la même structure en boucle plutôt qu'une exécution linéaire. L'agent comprend le contextefenêtre de contexteIAQuantité de texte qu'un modèle peut prendre en compte simultanément : question, documents fournis et historique. Au-delà, les éléments les plus anciens sortent du champ.Voir dans le glossaire, propose une action (explication, plan ou patch), l'humain révise ce qui est proposé, l'exécution outillée n'intervient qu'après validation, et une vérification factuelle — tests, relecture, critère mesurable — clôt le cycle. Un rejet à l'étape de revue ne relance pas tout depuis le début : il ramène l'agent à l'étape de proposition avec une consigne plus précise.
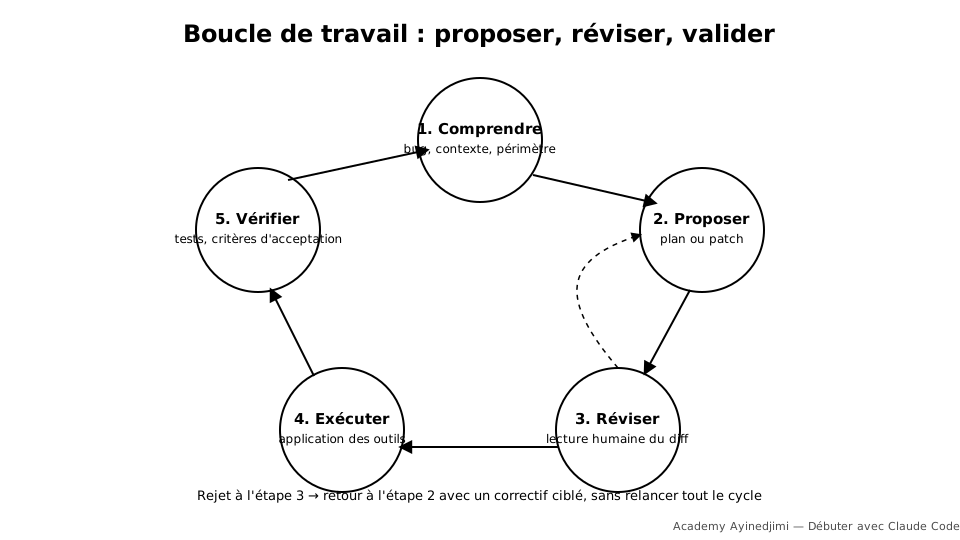
Cette structure a un coût apparent — elle ralentit la première itération, puisqu'il faut formuler un critère avant d'agir. Elle en économise beaucoup plus par la suite : un patch appliqué sans critère explicite se révèle souvent, une fois relufonction d'activationIAOpération non linéaire appliquée en sortie d'un neurone. Sans elle, empiler des couches serait inutile : une succession d'opérations linéaires reste équivalente à une seule.Voir dans le glossaire, hors sujet ou trop large, ce qui coûte plus cher à corriger que le temps gagné en sautant l'étape de cadrage.
Sur une tâche non triviale, demandez d'abord un plan sans exécution — une description des fichiers concernés, des modifications envisagées et des risques identifiés — avant d'autoriser l'écriture effective. Cette approche « plan puis exécution » coûte quelques secondes et évite la majorité des dérives de périmètre.
Workflow 1 — Expliquer un bug avant de le corriger
Le réflexe le plus contre-productif face à un bug est de demander directement un correctif. Sans diagnostic préalable, l'agent risque de traiter un symptôme visible plutôt que la cause réelle — un test qui échoue de façon intermittente, par exemple, peut être « corrigé » en assouplissant une assertion, ce qui masque le problème plutôt que de le résoudre.
La séquence recommandée :
- Fournir un contexte reproductible — message d'erreur complet, étapes pour déclencher le bug, comportement attendu versus comportement observé.
- Demander une explication sans modification de code — l'agent explore les fichiers concernés, retrace le chemin d'exécution, et formule une hypothèse sur la cause, sans encore proposer de patch.
- Valider ou contester l'hypothèse — si l'explication ne correspond pas à votre compréhension du système, corrigez-la avant de continuer ; une hypothèse fausse en amont produit un correctif inadapté en aval, même syntaxiquement propre.
- Demander le correctif seulement après validation de la cause.
Un rapport de bug typique à soumettre : « La fonction
calculer_remiseretourne un montant négatif quand la quantité dépasse 100 unités. Reproductible avecquantite=150, prix=20. Comportement attendu : la remise ne doit jamais dépasser le prix total. Explique la cause avant de proposer un correctif. » La dernière phrase est ce qui distingue ce prompt d'une demande de correctif à l'aveugle.
Workflow 2 — Proposer un patch
Une fois la cause identifiée, la demande de patch doit rester bornée : un fichier ou un module précis, un comportement cible clairement énoncé, et l'exigence explicite que le comportement existant hors du périmètre du bug reste inchangé.
Avant d'autoriser l'écriture du fichier, l'agent présente généralement le changement sous forme de diff. C'est le moment de revue le plus important du workflow : lisez le diff ligne par ligne, dans le contexte du fichier entier, pas seulement les lignes ajoutées en surbrillance. Un correctif peut être syntaxiquement correct et pourtant introduire une régression invisible dans un diff isolé — par exemple un changement d'ordre d'évaluation qui casse un effet de bord ailleurs dans la fonction.
Après application, exécutez la suite de tests existante avant de considérer la tâche terminée. Un patch qui « a l'air correct » sans passage par les tests n'a pas de statut différent d'un patch non vérifié.
La formulation de la demande influence directement la qualité du patch obtenu. Une consigne comme « corrige le calcul de remise » laisse trop de latitude sur la manière de corriger ; une consigne comme « corrige le calcul de remise pour qu'il ne dépasse jamais le prix total, sans modifier la signature de la fonction ni les appels existants » fixe à la fois le résultat attendu et les contraintes de compatibilité. Cette précisionprécisionIAProportion des alertes émises par un modèle qui sont justifiées. Elle s'oppose au rappel : améliorer l'une dégrade l'autre.Voir dans le glossaire supplémentaire coûte quelques secondes de rédaction et évite souvent un aller-retour de correction.
Workflow 3 — Écrire et étendre des tests
Un test n'est pas une formalité de fin de tâche : c'est une spécification exécutable du comportement attendu. Ce statut change la façon de le demander.
Pour un bug déjà diagnostiqué, la meilleure séquence est d'écrire d'abord un test qui reproduit l'échec, de vérifier qu'il échoue réellement pour la bonne raison, puis seulement ensuite de demander le correctif qui le fait passer. Cet ordre garantit que le test capture bien le problème signalé, et pas un comportement adjacent sans rapport.
Pour étendre une suite existante — ajouter la couverture d'un cas limite, d'une valeur nulle, d'une erreur réseau — demandez explicitement les cas à couvrir plutôt que de laisser l'agent deviner ce qui compte. Une liste de cas limites fournie par vous (valeurs vides, valeurs négatives, dépassement de capacité, entrées concurrentes) produit une couverture bien plus pertinente qu'une consigne générique comme « ajoute des tests ».
Un test généré automatiquement peut être écrit pour passer plutôt que pour vérifier quoi que ce soit d'utile — une assertion trop permissive, ou calquée sur le résultat produit par le code plutôt que sur le comportement attendu. Faites toujours échouer volontairement le code une fois pour confirmer que le test détecte réellement une régression, avant de le considérer fiable.
Workflow 4 — Refactor à périmètre borné
Un refactor diffère d'un correctif par son objectif : le comportement observable ne doit pas changer, seule la structure interne évolue. C'est précisément ce qui rend ce workflow risqué si le périmètre n'est pas explicitement fixé — un agent qui « améliore » du code au passage peut toucher des zones hors sujet, sans intention malveillante, simplement parce que rien ne l'en empêchait.
Définissez systématiquement, avant de lancer un refactor :
- Le périmètre exact — un fichier, une fonction, un module nommé, pas « le code autour ».
- L'invariant à préserver — le comportement externe reste identique ; toute suite de tests existante doit passer avant et après, sans modification des tests eux-mêmes pour les faire correspondre au nouveau code.
- Ce qui est explicitement hors périmètre — renommage de variables non concernées, changement de style non demandé, mise à jour de dépendances.
Lancez la suite de tests avant le refactor pour établir une base de référence, puis à nouveau après : un écart entre les deux résultats, même sur un test sans lien apparent avec la zone modifiée, doit être investigué avant de valider.
Workflow 5 — Revue de diff Git
Demander à l'agent de résumer un diff — le vôtre ou le sien — est utile pour gagner du temps de lecture, mais ce résumé ne remplace jamais la lecture humaine du diff complet. Un résumé, par construction, omet des détails ; c'est précisément dans les détails omis que se cachent la plupart des régressions.
Un usage productif de ce workflow : demander à l'agent d'identifier les zones à risque d'un diff avant que vous ne le lisiez vous-même — changements de signature de fonction, suppression de gestion d'erreur, modification de requêtes de base de donnéesdonnéesIAEnsemble d'informations structurées ou non utilisées pour entraîner, évaluer ou alimenter un modèle. La qualité, la quantité et la représentativité des données sont les facteurs décisifs pour les performances en apprentissage automatique.Voir dans le glossaire, fichiers de configuration touchés. Cette pré-analyse oriente votre lecture, elle ne la dispense pas.
Ce workflow fonctionne aussi bien sur un diff produit par l'agent que sur un diff soumis par un collègue humain : utiliser l'agent comme second lecteur avant une revue de code classique permet de repérer rapidement les incohérences évidentes (import inutilisé, faute de nommage, test oublié) et de réserver l'attentionattentionIAMécanisme par lequel un modèle pondère l'importance de chaque token du contexte lorsqu'il en traite un autre, quelle que soit la distance qui les sépare.Voir dans le glossaire humaine aux questions de fond — la justesse métier du changement, l'impact sur d'autres parties du système, les compromis d'architecture. L'agent élargit la couverture de la relecture, il n'en réduit pas la responsabilité finale.
Sur un diff qui touche des fichiers de configuration, des scripts de déploiement ou des migrations de base de données, la relecture humaine ligne à ligne reste non négociable, quel que soit le niveau de confiance acquis avec l'outil sur des tâches plus routinières. Le coût d'une erreur dans ces zones est structurellement plus élevé que le coût d'une relecture attentive.
Critères d'acceptation humaine
Chaque workflow gagne à être cadré par un critère mesurable, formulé avant l'exécution plutôt qu'évalué a posteriori sur une impression générale. Le schéma ci-dessous résume ce cycle en trois temps : un critère défini avant toute écriture de fichier, une exécution outillée qui s'y conforme, puis une vérification factuelle qui décide de l'acceptation ou du renvoi vers une nouvelle proposition.
| Workflow | Signal de réussite | Ce que l'humain doit vérifier lui-même |
|---|---|---|
| Expliquer un bug | L'hypothèse de cause correspond aux faits observés | La reproduction du bug colle exactement au rapport initial |
| Proposer un patch | Le comportement cible est atteint sans régression | Lecture ligne par ligne du diff, dans le contexte du fichier |
| Écrire des tests | Le test échoue avant le correctif, passe après | Le test capture bien le cas signalé, pas un comportement voisin |
| Refactor borné | Comportement externe identique, structure améliorée | Suite de tests complète avant/après, périmètre respecté |
| Revue de diff | Zones à risque identifiées avant lecture | Lecture humaine intégrale, notamment config et migrations |
Pièges fréquents
- Sauter le diagnostic pour gagner du temps, ce qui produit des correctifs de symptôme plutôt que de cause.
- Laisser le périmètre d'un refactor s'étendre au fil de l'exécution, sans reformuler explicitement les limites.
- Valider un diff sur la foi du résumé automatique, sans lecture ligne par ligne des zones sensibles.
- Accepter un test qui passe sans avoir vérifié qu'il échoue dans le cas contraire — un test qui ne peut jamais échouer ne protège rien.
- Exposer des secrets dans le contexte fourni à l'agent — variables d'environnement, fichiers de configuration avec identifiants — lors d'une explication de bug ou d'une revue de diff qui inclut ces fichiers par inadvertance.
- Confondre un chat web et un agent outillé — demander une revue « à distance » sans jamais rouvrir le dépôt localement pour vérifier ce qui a réellement été écrit sur le disque.
- Reformuler un test pour qu'il corresponde au résultat produit plutôt que de corriger le code — un test ajusté après coup pour passer perd toute valeur de spécification.
- Traiter un refactor et un correctif comme une seule tâche — mélanger changement de comportement et changement de structure dans le même diff rend la revue beaucoup plus difficile et masque la cause d'une éventuelle régression.
Ces pièges partagent une racine commune : ils apparaissent quand la vitesse d'exécution prime sur la clarté du critère. Un rappelrappelIAProportion des cas positifs réels effectivement détectés par un modèle. Sur un jeu déséquilibré, c'est un indicateur bien plus parlant que l'exactitude globale.Voir dans le glossaire régulier de la checklist ci-dessous, en fin de tâche plutôt qu'en début, aide à repérer ces dérives avant qu'elles ne s'accumulent d'une session à l'autre.
Checklist avant de fermer une tâche
- Le critère d'acceptation initial est-il satisfait, et pas seulement « quelque chose a changé » ?
- Le diff a-t-il été lu intégralement, pas seulement résumé ?
- La suite de tests pertinente a-t-elle été exécutée après modification, avec un résultat comparé à l'état de référence ?
- Le périmètre effectivement modifié correspond-il au périmètre annoncé au départ ?
- Aucun secret ni donnée sensible n'a été introduit ou exposé dans le processus ?
Ce qu'il faut retenir
Ces cinq workflows partagent une même logique : poser un critère avant d'agir, produire un artefact vérifiable à chaque étape, et réserver la validation finale à une lecture humaine réelle plutôt qu'à un résumé automatique. Cette discipline, une fois installée comme réflexe, transforme Claude Code d'un outil qui « produit du texte plausible » en un collaborateur dont le travail peut être audité à chaque étape — ce qui est la seule base solide pour l'intégrer à un flux de travail professionnel.
Les chapitres suivants s'appuient directement sur ces cinq recettes pour aborder des situations plus spécifiques — travail sur une base de code inconnue, coordination avec un dépôt distant, usage d'outilstool callingIACapacité d'un agent ou d'un LLM à invoquer des outils externes (API, calcul, recherche) pendant le raisonnement.Voir dans le glossaire externes via un protocole standardisé. Le socle reste le même : un critère avant l'action, une lecture réelle avant la validation.
L'essentiel à retenir
Ce chapitre présente cinq workflows concrets pour travailler avec Claude Code au quotidien : expliquer un bug avant de le corriger, proposer un patch, écrire ou étendre des tests, mener un refactor à périmètre borné, et réviser un diff Git. Chaque recette repose sur la même discipline : définir un critère d'acceptation vérifiable avant que l'agent ne modifie quoi que ce soit, puis lire réellement ce qui est produit plutôt que de valider par réflexe. Le chapitre détaille aussi les pièges les plus fréquents — dérive de périmètre, secrets exposés, confiance excessive dans un résumé automatique — et propose une checklist de clôture de tâche.
Questions fréquentes
Faut-il toujours passer par les cinq workflows dans l'ordre, même pour une tâche simple ?
Si l'agent propose un plan avant exécution, dois-je le lire en entier ou puis-je me contenter du résumé qu'il en fait ?
Comment savoir si un refactor a réellement préservé le comportement externe du code ?
Que faire si l'agent modifie des fichiers en dehors du périmètre annoncé pour un refactor ?
Un test écrit par l'agent est-il fiable sans relecture humaine ?
Est-il risqué de demander à l'agent de résumer un diff qui contient des informations sensibles ?
Ces workflows s'appliquent-ils différemment en mode print (non interactif) par rapport au mode interactif ?
Comment mesurer si la discipline décrite dans ce chapitre est réellement suivie au sein d'une équipe ?
Progression sauvegardée dans votre navigateur.
Quiz de validation
Quiz Player
Quiz de validation
Plusieurs réponses possibles — validez ensuite.
Vrai ou faux.
Quiz indisponible (données invalides).