





Pièges courants et suite du parcours
Les trois erreurs qui expliquent la majorité des sessions décevantes avec Claude Code, une FAQ opérationnelle dense pour débloquer les situations courantes, et les pistes concrètes pour monter en puissance après ce parcours.
Table des matières
Pourquoi ce chapitre clôt le parcours autrement
Les chapitres précédents ont montré comment installer Claude CodeClaude CodeIAInterface en ligne de commande agentique qui lit, édite et exécute des actions dans un dépôt de code sous contrôle de permissions, par opposition à un simple chat web.Voir dans le glossaire, formuler des demandes, exploiter le mode plan, structurer un CLAUDE.md, enchaîner des workflows et cadrer la sécurité d'une session. Ce dernier chapitre change de registre : il ne présente aucune fonctionnalité nouvelle. Il recense les erreurs qui reviennent le plus souvent une fois que les fondamentaux sont acquis — pas au moment de la découverte, mais quelques semaines plus tard, quand l'outil est devenu une habitude et que la vigilance initiale s'est relâchée.
La quasi-totalité des sessions décevantes que rencontrent les utilisateurs expérimentés se ramènent à trois causes : une instruction trop vague, un contextefenêtre de contexteIAQuantité de texte qu'un modèle peut prendre en compte simultanément : question, documents fournis et historique. Au-delà, les éléments les plus anciens sortent du champ.Voir dans le glossaire trop large, ou une confiance excessive accordée au résultat. Ce ne sont pas des défaillances de l'outil — ce sont des choix d'utilisation qui se corrigent facilement une fois identifiés.
Comprendre ces trois anti-patrons permet de diagnostiquer une session qui part mal avant qu'elle ne produise un résultat inexploitable, plutôt que de le découvrir après coup en relisant un diff qu'on ne comprend plus.
Anti-patron n°1 : le prompt flou
Une instruction comme « corrige le bug » ou « améliore ce fichier » semble économiser du temps de formulation. En réalité, elle transfère à l'agentagentIASystème qui enchaîne des appels d'outils de façon autonome pour atteindre un objectif : il planifie, agit, observe, recommence. Sa fiabilité décroît exponentiellement avec le nombre d'étapes.Voir dans le glossaire une décision qui devrait rester la vôtre : quel bug, quel critère de correction, quelle définition d'« amélioration ». Faute de précisionprécisionIAProportion des alertes émises par un modèle qui sont justifiées. Elle s'oppose au rappel : améliorer l'une dégrade l'autre.Voir dans le glossaire, Claude Code interprète l'instruction du mieux qu'il peut à partir du contexte disponible — et cette interprétation ne coïncide pas toujours avec ce que vous aviez en tête.
Le symptôme caractéristique n'est pas un échec bruyant, mais une correction qui fonctionne « techniquement » sans résoudre le problème réel : un test qui passe parce qu'il a été modifié plutôt que le code testé, une fonction renommée alors que la demande portait sur son comportement, un fichier corrigé alors que le bug se trouvait dans un autre.
« Corrige le bug d'affichage » laisse ouvertes des dizaines d'interprétations. « Le prix affiché sur la page produit n'inclut pas la TVA alors qu'il le devrait — corrige le calcul dans
pricing.ts, sans toucher à l'affichage du panier » élimine l'ambiguïté sur le fichier concerné, le comportement attendu et le périmètre à ne pas dépasser.
Une instruction bien formée contient généralement trois éléments : le résultat attendu formulé de façon vérifiable, le périmètre de fichiers ou de dossiers concernés, et les limites explicites de ce qui ne doit pas changer. Ce n'est pas plus long à écrire qu'une instruction vague — c'est simplement plus précis, et cette précision se paie une seule fois à l'écriture plutôt que plusieurs fois en corrections.
Anti-patron n°2 : le contexte trop large
L'intuition répandue veut que plus l'agent « voit » de contexte, meilleure sera sa réponse. C'est vrai jusqu'à un certain point, au-delà duquel l'effet s'inverse. Un contexte surchargé — un dépôt entier ouvert sans ciblage, un historique de conversation trop long conservé d'une tâche à l'autre, un CLAUDE.md qui liste tout au lieu de hiérarchiser l'essentiel — dilue l'information utile dans du bruit, et augmente la probabilité que l'agent s'appuie sur un détail non pertinent pour la tâche en cours.
Un contexte trop large ne se traduit pas par une erreur visible. Il se traduit par une dérivedériveIADégradation progressive des performances d'un modèle après son déploiement, causée par l'évolution des comportements ou du contexte. Elle impose surveillance et réentraînement.Voir dans le glossaire progressive : la réponse reste plausible, mais s'éloigne discrètement de l'intention de départ parce qu'un élément secondaire du contexte a pris plus de poids qu'il n'aurait dû.
Quelques réflexes limitent ce risque, déjà évoqués dans les chapitres sur le contexte projet et les workflows, et qu'il vaut la peine de rappeler ici comme discipline d'usage :
- Cibler le périmètre de chaque tâche plutôt que de laisser l'agent explorer l'ensemble du dépôt par défaut.
- Ouvrir une nouvelle session pour une tâche sans rapport, plutôt que d'enchaîner des sujets différents dans un fil de conversation déjà long.
- Garder
CLAUDE.mdcourt et hiérarchisé — les conventions les plus structurantes en premier, pas une liste exhaustive de détails secondaires. - Résumer ou clore une session longue avant d'entamer une tâche significativement différente, pour repartir sur un contexte propre.
Le contexte n'est pas une ressource à maximiser, c'est une ressource à cibler. Un contexte réduit mais pertinent produit des résultats plus fiables qu'un contexte exhaustif mais dilué.
Anti-patron n°3 : la confiance excessive
C'est le piège le plus tardif à apparaître, et le plus coûteux quand il s'installe. Après plusieurs semaines d'usage sans incident, la tentation est de relâcher la revue systématique présentée dans le chapitre précédent : accepter un diff sans le lire en détail, valider une suite de commandes sans vérifier chaque étape, considérer qu'un résultat qui « a l'air correct » l'est réellement.
Traitez chaque session comme la première, du point de vue de la revue — pas du point de vue de la formulation. Le fait que les cent dernières sessions se soient bien passées ne dit rien sur celle en cours : chaque tâche a son propre risque d'erreur silencieuse, indépendamment de l'historique.
La confiance excessive ne vient pas d'un excès de confiance abstrait dans le système, mais d'une généralisation trompeuse : parce qu'un agent a bien réussi des tâches similaires, on suppose qu'il réussira la suivante sans vérification équivalente. Or la fiabilité d'un résultat dépend de la tâche précise, de la clarté de l'instruction et de la qualité du contexte fourni pour cette tâche-là — pas d'un historique de succès qui ne s'applique pas automatiquement au cas présent.
Le signal d'alarme le plus fiable est comportemental, pas technique : si vous validez un diff en moins de temps qu'il ne vous en faudrait pour le lire réellement, la revue n'a pas eu lieu, quelle que soit la case cochée.
Panorama des pièges fréquents
| Piège | Symptôme typique | Correction |
|---|---|---|
| PromptpromptIAConsigne ou contexte fourni à un modèle de langage pour orienter sa réponse. La qualité du prompt conditionne souvent la qualité du résultat.Voir dans le glossaire flou | Résultat plausible mais hors sujet | Objectif vérifiable, fichiers ciblés, limites explicites |
| Contexte trop large | Dérive progressive difficile à repérer | Périmètre ciblé, session dédiée par sujet |
| Confiance excessive | Diff accepté sans lecture réelle | Revue systématique, indépendante de l'historique |
| Session fleuve | Réponses de moins en moins cohérentes | Clôturer et rouvrir une session propre |
| Permissions élargies par lassitude | Actions sensibles exécutées sans confirmation | Garder les confirmations actives sur le sensible |
Absence de CLAUDE.md à jour |
L'agent recrée des conventions déjà décidées | Mettre à jour le fichier après chaque décision structurante |
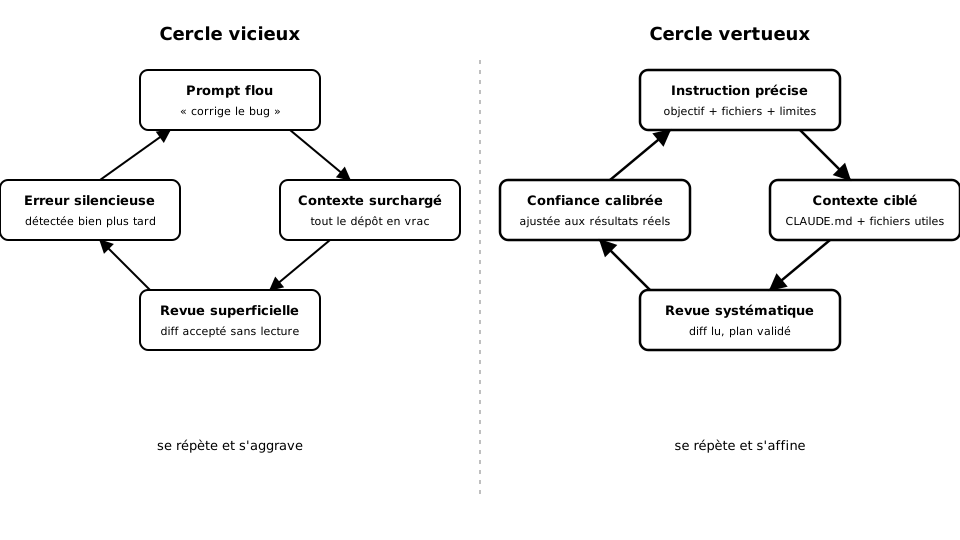
Diagnostiquer une session qui part mal
Avant de conclure qu'une session est mal engagée, il est utile de vérifier trois points, dans cet ordre :
- L'instruction de départ était-elle vérifiable ? Si le résultat attendu ne peut pas être formulé comme une condition testable (« le prix affiché correspond à X », pas « le prix est correct »), l'ambiguïté vient probablement de là.
- Le contexte utilisé correspondait-il au périmètre réel de la tâche ? Un agent qui modifie des fichiers hors sujet a souvent reçu un périmètre plus large que nécessaire, pas une instruction absurde.
- La dernière revue a-t-elle été réelle ou formelle ? Si la validation précédente s'est faite sans lecture attentive, l'origine du problème peut remonter à une étape antérieure déjà acceptée à tort.
Ce diagnostic en trois temps évite de blâmer l'outil pour un problème qui relève de la formulation, du périmètre ou de la revue — trois leviers entièrement sous votre contrôle.
Questions opérationnelles fréquentes
Quelques situations reviennent assez souvent pour mériter une réponse directe, en complément de la FAQ détaillée en fin de chapitre :
- L'agent boucle sur la même erreur. Interrompez la session plutôt que de laisser plusieurs tentatives s'accumuler : chaque nouvelle tentative s'appuie sur le contexte des précédentes, y compris sur leurs erreurs. Reformulez avec l'information manquante identifiée entre-temps.
- Le résultat ne correspond pas du tout à la demande. Vérifiez en premier lieu le périmètre de contexte fourni, avant de suspecter une mauvaise interprétation : un fichier de référence absent ou périmé explique une large part de ces écarts.
- La session devient lente à répondre. C'est souvent le signe d'un contexte de conversation devenu trop long. Clore la session et en ouvrir une nouvelle, éventuellement avec un résumé bref de l'état d'avancement, résout la majorité des cas.
- Une action attendue ne déclenche pas de demande de confirmation. Vérifiez le niveau de permission actif pour ce type d'action — il a pu être élargi lors d'une session précédente et être resté actif depuis.
Monter en puissance : sous-agents, CI, politique d'équipe
Une fois les fondamentaux solides — instructions précises, contexte ciblé, revue systématique — plusieurs pistes permettent d'aller au-delà d'un usage individuel ponctuel.
La délégation à des sous-agents consiste à confier des sous-tâches indépendantes à des instances distinctes de l'agent, chacune avec son propre contexte ciblé, plutôt que de tout faire porter à une seule session étendue. C'est pertinent quand une tâche se décompose naturellement en parties indépendantes — explorer une zone du code pendant qu'une autre est modifiée, par exemple — mais cela suppose une définition claire de ce que chaque sous-tâche doit produire, sans quoi la complexité de coordination dépasse le gain obtenu.
La délégation à des sous-agents n'est pas un raccourci pour éviter de formuler des instructions précises : elle multiplie simplement le nombre de contextes à cadrer correctement. Elle devient utile une fois que le cadrage d'une session unique est déjà maîtrisé, pas avant.
L'intégration en intégration continue permet d'automatiser des tâches répétitives et bien définies — génération de documentation, vérifications de cohérence, propositions de correctifs sur des alertes connues — dans un pipeline existant. Ce type d'usage exige un cadrage encore plus strict qu'une session interactive, puisque personne ne valide chaque étape en temps réel : le périmètre d'action, les permissions accordées et les conditions de déclenchement doivent être définis à l'avance, avec une revue humaine positionnée avant toute fusion de code, pas après.
La politique d'équipe, déjà abordée dans le chapitre sur la sécurité, devient incontournable dès que l'usage dépasse une personne. Elle gagne à évoluer avec l'expérience collective : les incidents mineurs rencontrés au fil des semaines, correctement documentés, sont la matière première la plus fiable pour affiner les consignes du projet, bien plus que des règles générales décidées a priori sans retour d'usage.
Où continuer après ce parcours
Ce parcours a couvert l'installation, l'interface, le contexte projet, les workflows courants, les extensions via MCPMCPIAModel Context Protocol : protocole permettant de brancher des outils et sources externes (docs, tickets, bases) à un agent LLM via des serveurs dédiés.Voir dans le glossaire et la sécurité — la base opérationnelle pour un usage quotidien fiable. La suite naturelle dépend du contexte dans lequel Claude Code s'intègre :
- Sur un projet individuel, l'axe de progression le plus rentable reste l'affinement du
CLAUDE.mdau fil des sessions : chaque convention redécouverte manuellement est une convention à y consigner. - Sur un projet d'équipe, la priorité est la politique d'usage collective — permissions par défaut, périmètres exclus, convention de revue — avant d'envisager des automatisations plus poussées.
- Sur des tâches répétitives et bien définies, l'intégration en CI devient pertinente, à condition de conserver une revue humaine avant toute fusion.
- Sur des tâches complexes à décomposer, la délégation à des sous-agents mérite d'être expérimentée, en gardant à l'esprit qu'elle amplifie les bonnes pratiques déjà en place — elle ne les remplace pas.
Aucune de ces pistes ne dispense des trois réflexes de base couverts dans ce chapitre. Ils restent la condition de fiabilité, quelle que soit l'échelle à laquelle l'outil est utilisé.
Checklist de fin de parcours
Avant de considérer ce parcours terminé, ces quelques points résument l'essentiel :
- Une instruction formule-t-elle un résultat vérifiable, un périmètre et des limites explicites ?
- Le contexte fourni à une session correspond-il au périmètre réel de la tâche, ni plus ni moins ?
- Chaque diff est-il lu en détail avant validation, indépendamment du nombre de sessions réussies auparavant ?
CLAUDE.mdreflète-t-il les conventions réellement en vigueur, ou reste-t-il figé depuis sa création ?- Une politique d'équipe existe-t-elle si l'outil est utilisé par plusieurs personnes sur le même dépôt ?
Ces cinq questions ne garantissent pas l'absence d'erreur — aucune checklist ne le peut. Elles garantissent en revanche que les erreurs qui subsistent seront visibles rapidement plutôt que découvertes tard, ce qui reste le meilleur indicateur d'un usage mature de l'outil.
L'essentiel à retenir
Ce chapitre de clôture recense les trois anti-patrons qui expliquent la plupart des sessions Claude Code décevantes : le prompt flou, le contexte trop large et la confiance excessive dans le résultat produit. Il fournit une grille de diagnostic pour repérer une session qui part mal avant qu'elle ne produise un résultat inexploitable, ainsi qu'une FAQ opérationnelle dense couvrant les blocages les plus fréquents. Il se termine sur les pistes concrètes pour monter en puissance une fois les fondamentaux acquis : délégation à des sous-agents, intégration en CI, et construction d'une politique d'équipe durable.
Questions fréquentes
Comment savoir si une instruction que je m'apprête à donner est trop vague ?
Faut-il toujours limiter le contexte au strict minimum, même sur des tâches complexes ?
Si mes cent dernières sessions se sont bien passées, puis-je relâcher un peu la revue des diffs ?
L'agent boucle sur la même erreur après plusieurs tentatives de correction, que faire ?
Quelle différence entre la délégation à des sous-agents et le simple fait d'enchaîner plusieurs demandes dans une session ?
Une intégration en CI avec Claude Code peut-elle fusionner du code sans intervention humaine ?
Comment une politique d'équipe doit-elle évoluer dans le temps ?
Ce parcours étant terminé, sur quoi porter l'attention en premier dans les semaines qui suivent ?
Progression sauvegardée dans votre navigateur.
Quiz de validation
Quiz Player
Quiz de validation
Plusieurs réponses possibles — validez ensuite.
Vrai ou faux.
Quiz indisponible (données invalides).