





Kernels et patterns d'optimisation
Les patterns qui reviennent dans quasi tout kernel CUDA performant : reduction, scan, tiling memoire partagee, loop unrolling, __restrict__, gestion de la divergence de warps, calcul d'occupancy et arbitrage fusion vs multi-kernel.
Table des matières
Pourquoi ce chapitre est le plus operationnel
Les chapitres precedents ont pose le modele d'execution SIMT, la hierarchie memoire et les bases de l'allocation de threads. Ce chapitre est different : il rassemble les patterns concrets que l'on retrouve, sous une forme ou une autre, dans la quasi-totalite des kernels CUDAGPUIAProcesseur graphique parallélisant massivement les calculs matriciels ; indispensable à l'entraînement et à l'inférence des modèles de deep learning.Voir dans le glossaire ecrits pour de la production ou de l'inference haute performance. Reduction, scan, tiling, unrolling, gestion de la divergence — ce ne sont pas des techniques exotiques reservees a des cas limites, ce sont les briques de base sur lesquelles reposent cuBLAS, cuDNN et la plupart des noyaux d'entrainement de reseaux de neurones.
Aucune des techniques presentees ici ne doit etre appliquee a l'aveugle. Chaque optimisation a un cout (lisibilite, portabilite, registres consommes) et un benefice qui depend du profil reel du kernel. Profilez avec Nsight Compute avant et apres chaque changement. Un unrolling qui degrade l'occupancy peut faire perdre plus que ce qu'il fait gagner en reduction de branchements.
Le pattern de reduction : de l'arbre naif au warp shuffle
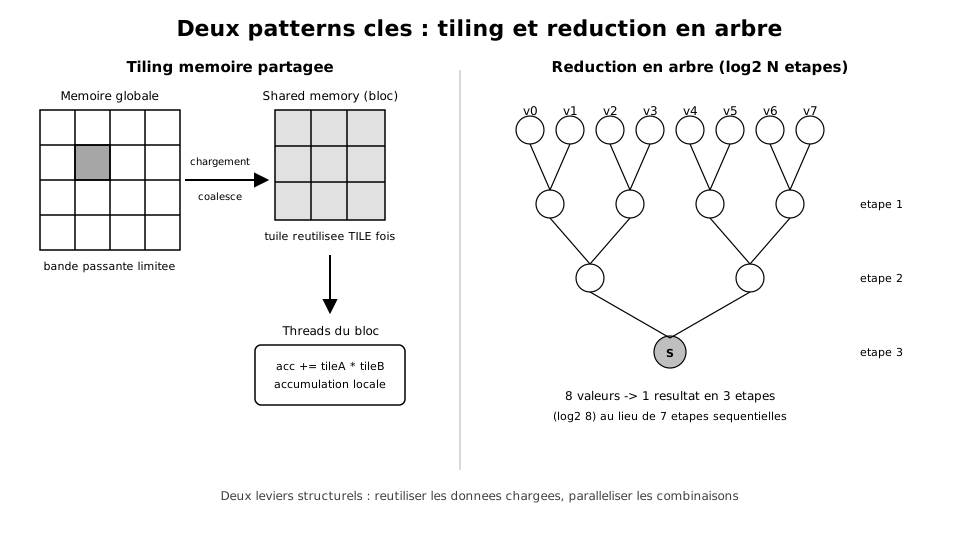
Reduire un tableau de N valeurs a une seule (somme, max, min, produit) est l'operation la plus frequente apres le simple mapping element par element. Une implementation sequentielle sur un seul thread coute O(N) etapes. L'objectif du pattern de reduction parallele est de descendre a O(log2 N) etapes en combinant les valeurs deux a deux a chaque niveau.
La version classique en memoire partagee charge un bloc de valeurs, puis fait converger les threads actifs a chaque etape :
- Etape 1 : les threads 0 a N/2-1 additionnent leur valeur avec celle du thread N/2+i.
- Etape 2 : les threads 0 a N/4-1 repetent l'operation sur le resultat precedent.
- Ainsi de suite jusqu'a n'avoir plus qu'une seule valeur active.
Deux pieges classiques sur cette version naive : l'indexation par pas (stride) qui laisse des threads inactifs de maniere non contigue a l'interieur d'un warp, ce qui gaspille des lanes sans meme gagner en simplicite, et l'absence de __syncthreads() entre les etapes, qui produit des resultats faux de maniere intermittente (donc difficiles a detecter en test rapide).
La version moderne combine deux niveaux : une reduction warp-level via les instructions de shuffle, qui evite completement la memoire partagee pour les 32 threads d'un meme warp, puis une reduction finale entre les resultats partiels des differents warps du bloc.
__inline__ __device__ float warpReduceSum(float val) {
  for (int offset = warpSize / 2; offset > 0; offset >>= 1)
    val += __shfl_down_sync(0xffffffff, val, offset);
  return val;
}
Cette approche supprime les acces memoire partagee et les synchronisations intra-warp (les 32 threads d'un warp sont deja synchrones en SIMT), ce qui la rend nettement plus rapide qu'une reduction entierement basee sur la memoire partagee des lors que le nombre d'elements a reduire est de l'ordre de quelques centaines a quelques milliers par bloc.
Scan parallele : la somme prefixe sans boucle sequentielle
Le scan (ou somme prefixe) calcule, pour chaque position i d'un tableau, la somme cumulee des elements precedents. C'est un ingredient discret mais omnipresent : compaction de flux, calcul d'offsets d'allocation, tri par bucket, construction d'histogrammes. Une implementation sequentielle est triviale (O(N)) mais interdit toute parallelisation directe puisque chaque sortie depend de toutes les entrees precedentes.
Deux algorithmes dominent en pratique :
- Hillis-Steele : simple a ecrire, O(N log N) operations au total, chaque etape double la distance de combinaison. Convient bien aux petits tableaux tenant dans un seul bloc.
- Blelloch (work-efficient) : deux phases, une montee (up-sweep) qui construit un arbre de sommes partielles, puis une descente (down-sweep) qui distribue les prefixes. O(N) operations au total, donc preferable pour les grands tableaux, au prix d'un code plus dense et de davantage de synchronisations.
En pratique, sauf contrainte pedagogique explicite, on delegue ce pattern a thrust::exclusive_scan ou aux primitives de CUB (cub::BlockScan, cub::DeviceScan), deja optimisees pour la coalescence et l'occupancy. Reecrire un scan a la main reste toutefois l'exercice de reference pour comprendre les dependances de donnees en environnement massivement parallele.
Tiling en memoire partagee : reutiliser ce qui est deja charge
Le tiling est le pattern qui transforme un kernel memory-bound en kernel compute-bound. Le cas d'ecole est le produit matriciel : sans tiling, calculer un element C[i][j] relit une ligne entiere de A et une colonne entiere de B depuis la memoire globale, alors que ces memes valeurs sont relues par des dizaines d'autres threads du meme bloc.
Le principe : chaque bloc de threads charge une sous-tuile de A et une sous-tuile de B en memoire partagee une seule fois, puis tous les threads du bloc reutilisent ces donnees pour plusieurs multiplications-accumulations avant de charger la tuile suivante.
__global__ void matmulTiled(const float* __restrict__ A,
                             const float* __restrict__ B,
                             float* __restrict__ C, int N) {
  __shared__ float tileA[TILE][TILE];
  __shared__ float tileB[TILE][TILE];
  int row = blockIdx.y * TILE + threadIdx.y;
  int col = blockIdx.x * TILE + threadIdx.x;
  float acc = 0.0f;
  for (int t = 0; t < N / TILE; ++t) {
    tileA[threadIdx.y][threadIdx.x] = A[row * N + t * TILE + threadIdx.x];
    tileB[threadIdx.y][threadIdx.x] = B[(t * TILE + threadIdx.y) * N + col];
    __syncthreads();
    for (int k = 0; k < TILE; ++k)
      acc += tileA[threadIdx.y][k] * tileB[k][threadIdx.x];
    __syncthreads();
  }
  C[row * N + col] = acc;
}
Avec une tuile de cote TILE, chaque valeur chargee depuis la memoire globale est reutilisee TILE fois au lieu d'une seule : le trafic memoire global est divise d'autant. Deux points de vigilance : les acces a tileA et tileB doivent eviter les conflits de banques (une dimension mal alignee sur 32 provoque des acces serialises), et le __syncthreads() doit encadrer chaque phase de chargement et de calcul pour garantir que la tuile est entierement ecrite avant d'etre lue.
Loop unrolling : reduire le cout de controle
Le deroulement de boucle remplace une boucle a faible nombre d'iterations par sa version depliee, executee via #pragma unroll ou manuellement :
#pragma unroll 4
for (int i = 0; i < 4; ++i) {
  acc += a[i] * b[i];
}
Le gain vient de deux sources : suppression du branchement de fin de boucle et de l'incrementation de l'index (overhead relativement lourd quand le corps de boucle est court), et davantage d'instructions independantes exposees au scheduler, ce qui augmente le parallelisme d'instructions (ILP) au sein d'un meme thread.
Le cout est symetrique : le code deroule occupe plus de registres (l'ordonnanceur ne peut plus reutiliser les memes registres d'une iteration a l'autre) et plus d'espace en cache d'instructions. Un unrolling agressif sur un kernel deja limite par les registres peut faire chuter l'occupancy et annuler tout le gain.
Reservez l'unrolling explicite aux boucles a trip-count fixe et connu au moment de la compilation (typiquement la boucle interne d'un tiling, avec TILE constant). Laissez le compilateur decider pour les boucles a trip-count variable :
#pragma unrollsans argument, ou son absence, donne generalement de meilleurs resultats que forcer un facteur arbitraire.
restrict : lever l'ambiguite d'aliasing pour le compilateur
En C/C++, deux pointeurs peuvent en theorie pointer vers des zones memoire qui se chevauchent. Sans information supplementaire, le compilateur doit se comporter comme si c'etait toujours le cas : il ne peut pas garder une valeur lue depuis un pointeur dans un registre s'il existe une ecriture ulterieure via un autre pointeur susceptible de modifier la meme adresse. Cette prudence bloque des optimisations basiques comme le caching de lecture ou la reordonnance d'instructions.
Le qualificatif __restrict__ applique a un parametre de pointeur est une promesse faite au compilateur : ce pointeur n'aliase aucun autre pointeur du meme scope. Le compilateur peut alors garder les valeurs en registre, utiliser le chemin de lecture seule (cache en lecture seule / __ldg), et reordonner plus librement.
__restrict__est une promesse, pas une verification. Si deux pointeurs marques__restrict__se chevauchent reellement a l'execution, le comportement est indefini : resultats incorrects, silencieux, parfois dependants de la configuration de lancement. Ne l'utilisez que lorsque l'appelant garantit l'absence de chevauchement (ce qui est le cas pour la quasi-totalite des kernels d'algebre lineaire ou les buffers d'entree et de sortie sont distincts).
Divergence de warps : le cout cache du branchement
Un warp regroupe 32 threads qui executent la meme instruction en lockstep (modele SIMT). Quand un branchement conditionnel (if/else) produit des chemins differents selon les threads d'un meme warp, le hardware ne peut pas executer les deux chemins simultanement : il execute le premier chemin en desactivant (masquant) les threads qui ne l'empruntent pas, puis le second chemin en desactivant les threads restants. Le cout total est proche de la somme des deux chemins, meme si chaque thread individuel n'en execute qu'un.
Les cas les plus frequents de divergence evitable : des tests de bornes mal alignes sur la taille de warp (32), des branches basees sur la parite de l'indice de thread, ou des traitements differents selon la valeur d'une donnee (par exemple un seuillage). Les leviers pour la reduire : restructurer les conditions pour qu'elles soient uniformes a l'echelle du warp plutot qu'a l'echelle du thread, remplacer un if court par une expression predicable (cond ? a : b), ou trier/regrouper les donnees en amont pour que les threads d'un meme warp suivent le meme chemin.
Point de vigilance additionnel : un __syncthreads() place a l'interieur d'une branche divergente est une source classique de deadlock ou de comportement indefini si tous les threads du bloc ne l'atteignent pas. La regle est stricte : tous les threads d'un bloc doivent executer le meme __syncthreads(), ou aucun.
Occupancy : dimensionner blocs et registres
L'occupancy est le ratio entre le nombre de warps actifs par SM et le nombre maximal de warps que ce SM peut heberger simultanement. Une occupancy elevee permet au scheduler de masquer la latence memoire en basculant vers un autre warp pendant qu'un warp attend une donnee. Trois ressources limitent conjointement l'occupancy :
| Facteur limitant | Effet sur l'occupancy | Levier disponible |
|---|---|---|
| Registres par thread | Moins de warps residents si le nombre de registres par thread est eleve | Compiler avec -maxrregcount, simplifier le kernel, unrolling plus prudent |
| Shared memory par bloc | Reduit le nombre de blocs co-residents sur un meme SM | Reduire TILE_WIDTH, shared memory dynamique dimensionnee au plus juste |
| Threads par bloc | Un multiple de 32 evite de gaspiller des lanes ; trop petit sous-utilise les warps schedulables | Choisir 128 ou 256 threads par bloc en premiere approche |
| Blocs residents par SM | Plafond materiel independant des registres et de la shared memory | Depend de la compute capability cible, non ajustable par le code |
L'API cudaOccupancyMaxPotentialBlockSize calcule automatiquement une taille de bloc candidate maximisant l'occupancy theorique pour un kernel donne ; Nsight Compute affiche l'occupancy theorique et l'occupancy realisee (souvent inferieure du fait des desequilibres de charge entre blocs).
Une occupancy elevee est necessaire mais pas suffisante. Certains kernels compute-bound avec beaucoup d'ILP par thread sont plus rapides avec une occupancy volontairement basse et davantage de registres par thread, parce que le gain en parallelisme d'instructions depasse la perte en masquage de latence. Ne traitez jamais l'occupancy maximale comme un objectif en soi : c'est un indicateur a lire conjointement avec le profil memoire-bound ou compute-bound du kernel.
Fusion de kernels vs pipeline multi-kernel
Quand plusieurs kernels s'enchainent sur les memes donnees (par exemple une activationfonction d'activationIAOpération non linéaire appliquée en sortie d'un neurone. Sans elle, empiler des couches serait inutile : une succession d'opérations linéaires reste équivalente à une seule.Voir dans le glossaire suivie d'une normalisation), chaque kernel separe implique une ecriture complete du resultat en memoire globale suivie d'une relecture complete par le kernel suivant, en plus du cout fixe de lancement (de l'ordre de quelques microsecondes, negligeable isolement mais cumulatif sur des pipelines a dizaines d'etapes).
La fusion de kernels consiste a combiner ces etapes en un seul kernel, en gardant les resultats intermediaires en registres ou en memoire partagee plutot qu'en memoire globale. Le gain est direct sur les kernels memory-bound, ou le trafic memoire domine le temps d'execution.
Un pipeline convolution puis activation ReLU puis addition de biaisbiaisIARégularité correctement apprise dans des données qui ne représentent pas la réalité visée, ou qui enregistrent des décisions passées avec leurs préjugés. Changer d'algorithme ne le corrige pas.Voir dans le glossaire, ecrit comme trois kernels distincts, effectue trois allers-retours en memoire globale. Fusionne en un seul kernel qui applique le biais et le ReLU immediatement apres avoir calcule chaque valeur de sortie de la convolution, il n'en effectue plus qu'un seul. Sur un tenseur de grande taille, ce genre de fusion peut reduire le temps total de 30 a 50 pour cent lorsque le kernel est memory-bound.
La fusion a un cout organisationnel : le kernel fusionne est plus difficile a profiler isolement (impossible de distinguer la part du temps due a chaque etape logique), son profil de registres et de shared memory devient la somme des besoins de chaque etape, ce qui peut degrader l'occupancy, et toute modification d'une des etapes oblige a retoucher un code plus dense. Gardez les kernels separes quand les etapes ont des profils de ressources tres differents (l'une memory-bound, l'autre compute-bound avec forte pression registre), ou quand une des etapes appelle une bibliotheque optimisee (cuBLAS, cuDNN) qu'il serait contre-productif de reimplementer a la main.
Quand le probleme est surtout le cout de lancement cumule plutot que les allers-retours memoire, les CUDA Graphs offrent une alternative : ils capturent une sequence de kernels et la rejouent avec un seul appel de lancement, sans fusionner la logique elle-meme.
Checklist avant d'optimiser
- Profiler d'abord (Nsight Compute ou Nsight Systems) pour identifier si le kernel est memory-bound ou compute-bound plutot que de deviner.
- Verifier la coalescence des acces a la memoire globale avant toute autre optimisation : c'est generalement le plus gros levier.
- Introduire le tiling en memoire partagee si des donnees sont relues par plusieurs threads du meme bloc.
- Verifier l'absence de conflits de banques dans la memoire partagee.
- Chercher les sources de divergence de warps evitables et les restructurer.
- Ajouter
__restrict__la ou l'absence d'aliasing est garantie. - Mesurer l'occupancy theorique et realisee, et ne l'augmenter que si le kernel est bien limite par la latence.
- Envisager l'unrolling seulement sur des boucles a trip-count fixe et apres avoir verifie l'impact sur les registres.
- Evaluer la fusion de kernels seulement quand le profil memoire confirme des allers-retours evitables.
- Rebenchmarker apres chaque changement, isolement et dans le pipeline complet : un gain isole ne garantit pas un gain de bout en bout.
L'essentiel à retenir
Ce chapitre presente les patterns d'optimisation qui reviennent dans la quasi-totalite des kernels CUDA performants : reduction en arbre et warp shuffle, scan parallele, tiling en memoire partagee, loop unrolling et __restrict__. Il detaille le cout de la divergence de warps et la maniere de calculer et interpreter l'occupancy d'un kernel. Il se termine par l'arbitrage entre fusion de kernels et pipeline multi-kernel, et une checklist d'optimisation a suivre dans l'ordre plutot qu'au hasard.
Questions fréquentes
Faut-il toujours preferer le warp shuffle a la reduction en memoire partagee ?
Comment savoir si mon kernel est limite par les registres, la shared memory ou le nombre de blocs par SM ?
Le loop unrolling automatique du compilateur suffit-il, ou faut-il l'ecrire a la main ?
Un branchement if/else dans un kernel provoque-t-il systematiquement de la divergence ?
Pourquoi CUB ou Thrust plutot que reecrire soi-meme un scan ou une reduction ?
La fusion de kernels degrade-t-elle toujours la lisibilite du code ?
Quelle est la premiere optimisation a essayer sur un kernel qui n'a jamais ete profile ?
Progression sauvegardée dans votre navigateur.
Quiz de validation
Quiz Player
Quiz de validation
Plusieurs réponses possibles — validez ensuite.
Vrai ou faux.
Quiz indisponible (données invalides).