





Modèle de programmation CUDA
Comprendre la séparation host/device, la chaîne de compilation nvcc et la hiérarchie grid/block/thread pour écrire et lancer un premier kernel CUDA sans tomber dans les pièges classiques du débutant.
Table des matières
Pourquoi ce chapitre est le socle de tout le reste
Avant d'optimiser l'occupation des SM, de jongler avec la mémoire partagée ou de profiler un kernel avec Nsight, il faut maîtriser un modèle mental précis : qui exécute quoi, où, et dans quel ordre. La majorité des bugs CUDAGPUIAProcesseur graphique parallélisant massivement les calculs matriciels ; indispensable à l'entraînement et à l'inférence des modèles de deep learning.Voir dans le glossaire rencontrés en production — kernels qui ne font rien, résultats silencieusement faux, crashs difficiles à reproduire — viennent d'une mauvaise compréhension de ce chapitre, pas d'un problème d'algorithme.
CUDA n'est pas un langage à part entière : c'est une extension de C++ compilée par une chaîne d'outilstool callingIACapacité d'un agent ou d'un LLM à invoquer des outils externes (API, calcul, recherche) pendant le raisonnement.Voir dans le glossaire qui produit du code pour deux cibles radicalement différentes dans le même fichier source. Comprendre cette dualité conditionne tout ce qui suit dans la formation.
CUDA distingue en permanence deux mondes d'exécution : le host (le CPU et sa RAM) et le device (le GPU et sa mémoire dédiée, la VRAM). Un pointeur alloué côté host n'est pas valide côté device, et réciproquement. Cette confusion est la source numéro un de segfaults en CUDA.
Host et device : deux machines, un seul fichier source
Dans un fichier .cu, le code s'exécute soit sur le CPU (host), soit sur le GPU (device). Trois qualificateurs de fonction indiquent où le code tourne et depuis où il peut être appelé :
| Qualificateur | Exécuté sur | Appelable depuis | Usage typique |
|---|---|---|---|
__host__ |
CPU | CPU | fonction C++ classique (implicite si aucun qualificateur) |
__device__ |
GPU | GPU uniquement | fonction utilitaire appelée depuis un kernel |
__global__ |
GPU | CPU (lancement) | le kernel lui-même, point d'entrée du parallélisme |
Un kernel __global__ doit toujours retourner void. Il ne renvoie pas de valeur au host par un simple return : le résultat doit être écrit dans un buffer mémoire préalablement alloué, puis rapatrié explicitement.
__device__ float carre(float x) {
    return x * x;
}

__global__ void kernel_carre(float* donnees, int n) {
    int idx = blockIdx.x * blockDim.x + threadIdx.x;
    if (idx < n) {
        donnees[idx] = carre(donnees[idx]);
    }
}
Notez que carre est appelée depuis le kernel, pas depuis le host — c'est la fonction __device__ qui le permet. Tenter d'appeler kernel_carre directement comme une fonction C++ (kernel_carre(donnees, n);) est une erreur de compilation : un kernel s'invoque uniquement via la syntaxe de lancement <<<...>>>.
nvcc : une chaîne de compilation à deux sorties
nvcc (NVIDIA CUDA Compiler) n'est pas un compilateur monolithique : c'est un orchestrateur qui sépare le fichier .cu en deux flux de compilation distincts, puis les recombine dans un binaire unique.
- Le code host est extrait et transmis au compilateur C++ de la plateforme (
gcc,clangoucl.exeselon l'OS). - Le code device est compilé par le backend CUDA en PTX (Parallel Thread Execution), une forme de bytecode intermédiaire indépendant de l'architecture GPU précise.
- Le PTX est ensuite assemblé en SASS (code machine réel pour une architecture cible), soit à la compilation (
ahead-of-time), soit au premier lancement (just-in-time, via le driver). - Un binaire « fat binary » regroupe le code host et un ou plusieurs binaires device pour différentes architectures.
nvcc -arch=sm_86 -o vecadd vecadd.cu
L'option -arch (ou -gencode pour cibler plusieurs architectures simultanément) détermine pour quelle génération de GPU le SASS est généré. Un binaire compilé uniquement pour sm_86 (Ampere) peut échouer silencieusement à trouver un kernel compatible sur un GPU plus ancien si aucun PTX de repli n'est embarqué.
En développement, compilez avec
-gencode arch=compute_XX,code=sm_XXpour votre GPU cible et ajoutez-gencode arch=compute_XX,code=compute_XXpour embarquer le PTX. Le driver pourra alors recompiler en JIT sur une architecture plus récente que celle prévue à la compilation, ce qui évite de reconstruire à chaque nouvelle génération de carte.
La hiérarchie grid, block, thread
Un kernel CUDA n'est pas exécuté une fois : il est lancé pour être exécuté simultanément par un très grand nombre de threads, organisés selon une hiérarchie à trois niveaux.
- La grid est l'ensemble complet des threads lancés pour un appel de kernel.
- La grid est subdivisée en blocks, groupes de threads qui partagent une mémoire partagée (
__shared__) et peuvent se synchroniser entre eux via__syncthreads(). - Chaque block contient des threads, l'unité d'exécution la plus fine.
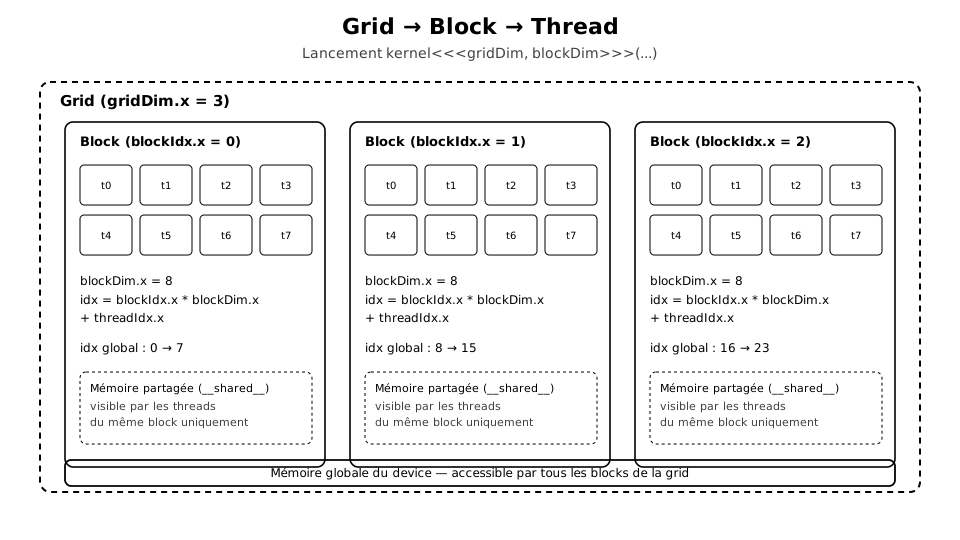
Ces trois niveaux disposent chacun d'une dimension jusqu'à trois axes (x, y, z), ce qui permet de mapper naturellement des donnéesdonnéesIAEnsemble d'informations structurées ou non utilisées pour entraîner, évaluer ou alimenter un modèle. La qualité, la quantité et la représentativité des données sont les facteurs décisifs pour les performances en apprentissage automatique.Voir dans le glossaire 1D, 2D (images) ou 3D (volumes). À l'intérieur d'un kernel, quatre variables intégrées donnent la position du thread courant :
threadIdx— position du thread dans son blockblockIdx— position du block dans la gridblockDim— dimensions d'un block (nombre de threads par axe)gridDim— dimensions de la grid (nombre de blocks par axe)
Le calcul d'un index global unique pour un tableau 1D est le motif le plus répété de tout le code CUDA :
int idx = blockIdx.x * blockDim.x + threadIdx.x;
Ce calcul revient constamment dans la formation : c'est lui qui traduit la hiérarchie logique (grid/block/thread) en un index linéaire exploitable pour adresser un tableau en mémoire.
Le nombre maximal de threads par block dépend de l'architecture, mais la limite classique est de 1024 threads par block sur la quasi-totalité des GPU actuels. Le nombre de blocks dans une grid, en revanche, peut être très largement supérieur (plusieurs millions sur l'axe x). Il faut donc systématiquement découper le travail en plusieurs blocks plutôt que de chercher à tout faire tenir dans un seul.
Le warp : l'unité réelle d'exécution matérielle
La hiérarchie logique grid/block/thread cache une réalité matérielle qu'il faut connaître dès ce stade, même si son exploitation fine fera l'objet d'un chapitre dédié plus loin. Sur le GPU, les threads d'un block ne s'exécutent pas indépendamment les uns des autres : ils sont regroupés par paquets de 32 threads consécutifs, appelés warps, et un multiprocesseur (SM) exécute un warp entier en lock-step — tous les threads du warp exécutent la même instruction au même cycle, sur des données différentes (modèle SIMT, Single Instruction Multiple Threads).
Cette contrainte a deux conséquences pratiques immédiates, même pour un kernel aussi simple que vecAdd :
- Choisir une taille de block multiple de 32 (128, 256, 512...) évite de gaspiller une fraction de warp avec des threads inactifs.
- Si le code contient une branche conditionnelle (
if) dont le résultat diffère entre threads d'un même warp, le matériel exécute séquentiellement les deux branches pour l'ensemble du warp, en désactivant les threads non concernés à chaque passage — un phénomène appelé divergence de warp, qui dégrade les performances sans jamais produire de résultat incorrect.
Cette notion sera approfondie plus loin dans la formation, en particulier pour l'optimisation de l'occupation des SM ; elle est mentionnée ici car elle explique directement pourquoi 256 est une taille de block bien plus fréquente dans le code réel que 250 ou 300.
Écrire un premier kernel : addition de deux vecteurs
L'exemple canonique pour valider sa compréhension du modèle est l'addition vectorielle : calculer c[i] = a[i] + b[i] pour n éléments, en parallèle.
__global__ void vecAdd(const float* a, const float* b, float* c, int n) {
    int idx = blockIdx.x * blockDim.x + threadIdx.x;
    if (idx < n) {
        c[idx] = a[idx] + b[idx];
    }
}

int main() {
    int n = 1 << 20;              // ~1 million d'éléments
    size_t taille = n * sizeof(float);

    float *h_a, *h_b, *h_c;       // buffers host
    h_a = (float*)malloc(taille);
    h_b = (float*)malloc(taille);
    h_c = (float*)malloc(taille);
    // ... remplissage de h_a et h_b ...

    float *d_a, *d_b, *d_c;       // buffers device
    cudaMalloc(&d_a, taille);
    cudaMalloc(&d_b, taille);
    cudaMalloc(&d_c, taille);

    cudaMemcpy(d_a, h_a, taille, cudaMemcpyHostToDevice);
    cudaMemcpy(d_b, h_b, taille, cudaMemcpyHostToDevice);

    int threadsParBlock = 256;
    int nombreBlocks = (n + threadsParBlock - 1) / threadsParBlock;
    vecAdd<<<nombreBlocks, threadsParBlock>>>(d_a, d_b, d_c, n);

    cudaDeviceSynchronize();
    cudaMemcpy(h_c, d_c, taille, cudaMemcpyDeviceToHost);

    cudaFree(d_a); cudaFree(d_b); cudaFree(d_c);
    free(h_a); free(h_b); free(h_c);
    return 0;
}
Ce squelette contient tous les éléments incontournables : allocation device (cudaMalloc), copie explicite host→device (cudaMemcpy), lancement avec la syntaxe <<<grid, block>>>, synchronisation, copie retour device→host, puis libération. Chaque étape sera détaillée en profondeur dans les chapitres suivants sur la gestion mémoire, mais ce squelette doit devenir un réflexe avant d'aborder des cas plus complexes.
Avec
n = 1 048 576etthreadsParBlock = 256, le calcul(n + 255) / 256donne exactement4096blocks. Sinn'était pas un multiple de 256 — par exemplen = 1 000 000— ce même calcul produirait3907blocks, dont le dernier ne serait que partiellement rempli. C'est précisément pour cette raison que la gardeif (idx < n)dans le kernel est indispensable : sans elle, les threads surnuméraires du dernier block écriraient hors des bornes du tableau.
Vérifier les erreurs : ne jamais lancer un kernel « à l'aveugle »
Un lancement de kernel (<<<...>>>) est asynchrone : l'appel retourne immédiatement au host, avant même que le GPU ait commencé à exécuter quoi que ce soit. Cela a une conséquence directe sur la détection d'erreurs : une erreur de configuration de lancement (trop de threads par block, paramètres invalides) est signalée immédiatement, mais une erreur survenant pendant l'exécution du kernel (accès mémoire hors bornes, division par zéro sur le device) ne sera visible qu'après une synchronisation.
vecAdd<<<nombreBlocks, threadsParBlock>>>(d_a, d_b, d_c, n);

cudaError_t erreurLancement = cudaGetLastError();
if (erreurLancement != cudaSuccess) {
    fprintf(stderr, "Erreur de lancement : %s\n", cudaGetErrorString(erreurLancement));
}

cudaError_t erreurExecution = cudaDeviceSynchronize();
if (erreurExecution != cudaSuccess) {
    fprintf(stderr, "Erreur d'exécution : %s\n", cudaGetErrorString(erreurExecution));
}
cudaGetLastError()ne capture que les erreurs de configuration du lancement (par exemple demander 2048 threads dans un block alors que la limite est 1024). Il ne dit strictement rien sur ce qui se passe pendant l'exécution du kernel. Sans un appel àcudaDeviceSynchronize()suivi d'une vérification de son code de retour, un kernel qui plante silencieusement (accès mémoire invalide) peut laisser croire que tout s'est bien passé, alors que le buffer résultat contient des données corrompues ou non initialisées.
En pratique, la plupart des bases de code CUDA sérieuses encapsulent cette vérification dans une macro appelée après chaque appel API et après chaque lancement de kernel :
#define VERIFIER_CUDA(appel) \
    do { \
        cudaError_t e = (appel); \
        if (e != cudaSuccess) { \
            fprintf(stderr, "Erreur CUDA %s:%d : %s\n", \
                    __FILE__, __LINE__, cudaGetErrorString(e)); \
            exit(1); \
        } \
    } while (0)
Cette macro s'utilise en enveloppant chaque appel : VERIFIER_CUDA(cudaMalloc(&d_a, taille));. C'est un investissement minime qui transforme des heures de débogage silencieux en un message d'erreur exploitable immédiatement.
Pièges classiques du débutant
- Oublier la garde
if (idx < n). Dès quenn'est pas un multiple exact dethreadsParBlock, des threads du dernier block calculent un index hors bornes. Sans garde, c'est une écriture mémoire invalide, parfois silencieuse selon l'allocateur. - Confondre
cudaMemcpyHostToDeviceetcudaMemcpyDeviceToHost. L'inversion des deux constantes ne provoque pas toujours une erreur immédiate visible, mais corrompt les données transférées. - Déréférencer un pointeur host dans du code device (ou l'inverse). Le compilateur ne le détecte pas toujours ; le comportement observé est un crash ou des données aberrantes, souvent loin du point d'origine du bug.
- Ne pas synchroniser avant de lire le résultat sur le host. Comme le lancement est asynchrone, lire
h_cjuste après le kernel sanscudaDeviceSynchronize()(ou sans passer par uncudaMemcpybloquant, qui synchronise implicitement) peut lire un buffer encore en cours d'écriture. - Dépasser la limite de threads par block sans le savoir. Demander
<<<n, 2048>>>sur un GPU limité à 1024 threads par block échoue au lancement — visible uniquement sicudaGetLastError()est vérifié. - Négliger les fuites mémoire device.
cudaMallocsanscudaFreecorrespondant épuise progressivement la VRAM sur des exécutions répétées, notamment en boucle d'entraînement.
Checklist avant de considérer un premier kernel comme fonctionnel
- Le kernel est-il qualifié
__global__et retourne-t-ilvoid? - L'index global est-il calculé correctement pour la dimensionnalité des données (1D, 2D, 3D) ?
- Une garde protège-t-elle contre le dépassement de bornes quand la taille des données n'est pas un multiple exact de
blockDim? - Chaque appel
cudaMalloc,cudaMemcpyet le lancement du kernel sont-ils vérifiés (viacudaGetLastErroret une macro de contrôle) ? cudaDeviceSynchronize()est-il appelé avant toute lecture du résultat côté host (sauf si uncudaMemcpybloquant s'en charge) ?- Chaque
cudaMalloca-t-il soncudaFreecorrespondant ?
Cette checklist paraît élémentaire, mais elle couvre la très grande majorité des incidents rencontrés en environnement de production sur des pipelines d'inférenceinférenceIAUtilisation d'un modèle déjà entraîné sur une donnée nouvelle. Peu coûteuse à l'unité mais répétée à chaque requête, elle constitue le coût récurrent d'exploitation.Voir dans le glossaire ou d'entraînement GPU. Les chapitres suivants s'appuient directement sur ce modèle pour aborder la mémoire partagée, la coalescence des accès mémoire et l'occupation des multiprocesseurs — autant de leviers de performance qui n'ont de sens qu'une fois ce socle solidement acquis.
L'essentiel à retenir
Ce chapitre pose les fondations opérationnelles de CUDA : la séparation entre code host (CPU) et code device (GPU), le rôle exact de nvcc dans la compilation, et la hiérarchie d'exécution grid/block/thread qui organise des milliers de threads en parallèle. On y écrit un premier kernel d'addition vectorielle de bout en bout, avec allocation mémoire, lancement et vérification systématique des erreurs via cudaGetLastError et cudaDeviceSynchronize. Le chapitre se termine sur les pièges qui font perdre des heures à tout débutant : oubli de synchronisation, dépassement silencieux des limites de threads par block, confusion entre erreurs de lancement et erreurs d'exécution asynchrones.
- Séparation host/device
- Chaîne de compilation nvcc
- Hiérarchie grid, block, thread
- Index global via blockIdx, blockDim, threadIdx
- Qualificateurs __global__, __device__, __host__
- Gestion des erreurs CUDA (cudaGetLastError, cudaDeviceSynchronize)
- Allocation et transfert mémoire (cudaMalloc, cudaMemcpy)
- Pièges courants du premier kernel
Questions fréquentes
Faut-il toujours appeler cudaDeviceSynchronize() après chaque lancement de kernel ?
Quelle est la différence entre une erreur de lancement et une erreur d'exécution ?
Peut-on choisir n'importe quelle taille de block, par exemple 100 ou 333 threads ?
Que se passe-t-il si j'utilise un pointeur alloué avec cudaMalloc directement dans du code host, par exemple avec printf ?
Pourquoi mon kernel semble s'exécuter sans erreur mais produit un résultat entièrement à zéro ?
Faut-il réécrire le calcul d'index global si mes données sont en 2D, comme une image ?
L'option -arch de nvcc est-elle obligatoire pour compiler un kernel simple ?
Progression sauvegardée dans votre navigateur.
Quiz de validation
Quiz Player
Quiz de validation
Plusieurs réponses possibles — validez ensuite.
Vrai ou faux.
Quiz indisponible (données invalides).