





Multi-GPU et NCCL
Topologie PCIe/NVLink/NVSwitch, mécanique des collectives AllReduce, mise en œuvre avec NCCL et PyTorch DDP, stratégies de sharding pour l'entraînement et l'inférence, et arithmétique de la rentabilité du multi-GPU.
Table des matières
Pourquoi la topologie compte avant le code
Ajouter des GPUGPUIAProcesseur graphique parallélisant massivement les calculs matriciels ; indispensable à l'entraînement et à l'inférence des modèles de deep learning.Voir dans le glossaire à un job d'entraînement ne divise pas automatiquement le temps d'exécution par le nombre de cartes. C'est l'erreur la plus fréquente au passage du mono-GPU au multi-GPU : on raisonne en FLOPS cumulés en oubliant que chaque GPU supplémentaire doit désormais échanger des donnéesdonnéesIAEnsemble d'informations structurées ou non utilisées pour entraîner, évaluer ou alimenter un modèle. La qualité, la quantité et la représentativité des données sont les facteurs décisifs pour les performances en apprentissage automatique.Voir dans le glossaire avec les autres à chaque étape d'optimisation. La vitesse de ces échanges dépend directement de la topologie matérielle, et cette topologie fixe un plafond de performance que le code applicatif ne peut pas contourner.
Ce chapitre part de la couche physique — comment les GPU sont reliés entre eux et entre nœuds — pour remonter vers la couche logicielle : NCCL, PyTorch DDP, stratégies de sharding. Il se termine par la question qui compte réellement en production : à partir de quel point le multi-GPU cesse d'être rentable.
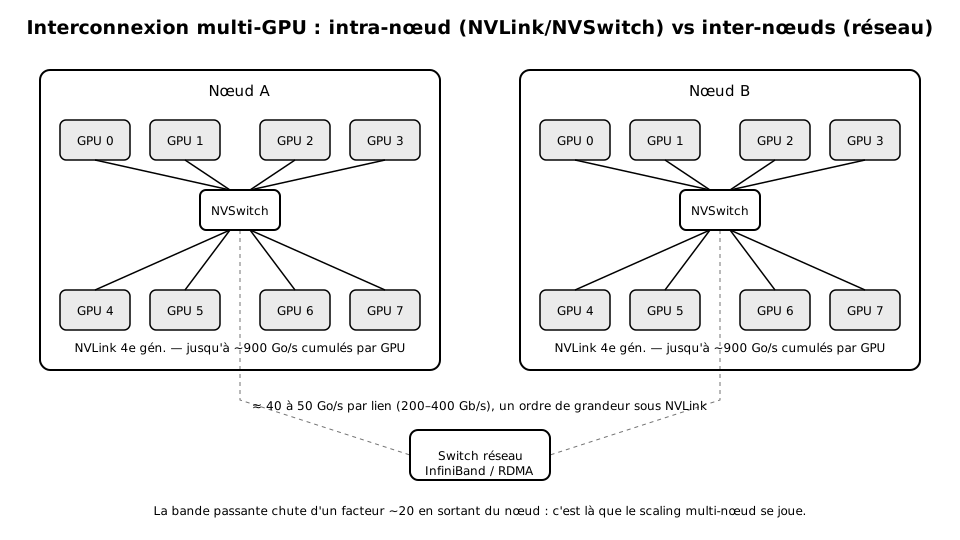
Interconnexions : PCIe, NVLink, NVSwitch, réseau
Trois échelles de communication coexistent dans un cluster GPU, avec des ordres de grandeur très différents :
| Lien | Bande passante typique | Portée |
|---|---|---|
| PCIe Gen4 x16 | ~32 Go/s bidirectionnel | GPU vers CPU, ou GPU vers GPU si pas de NVLink |
| NVLink 4e génération | ~900 Go/s cumulés par GPU (H100) | Intra-nœud, pair-à-pair direct |
| NVSwitch | non bloquant, agrège les liens NVLink | Intra-nœud, tous-vers-tous |
| InfiniBand NDR / Ethernet RDMA | ~40 à 50 Go/s par lien (200–400 Gb/s) | Inter-nœuds |
Deux GPU reliés uniquement par PCIe et transitant par le CPU pour échanger des données subissent une latence et une bande passante très inférieures à deux GPU reliés par NVLink. Sur des serveurs multi-GPU sans NVSwitch, la topologie peut même varier par paire : deux cartes sur le même pont PCIe communiquent plus vite qu'une paire séparée par un pont NUMA. nvidia-smi topo -m affiche cette matrice et doit être la première commande lancée sur toute nouvelle machine avant d'y planifier un job distribué.
Ne présumez jamais qu'une instance cloud « 8x GPU » dispose de NVSwitch. Certaines offres d'entrée de gamme relient les GPU par paires PCIe sans pont haut débit. Le même code de training peut afficher une efficacité de scaling de 90 % sur une instance et de 55 % sur une autre, pour un prix horaire comparable. Vérifiez la topologie avant de signer un contrat de réservation longue durée.
À l'échelle du cluster, le réseau inter-nœuds devient le goulot d'étranglement dominant : un lien InfiniBand NDR à 400 Gb/s, soit environ 50 Go/s, représente moins de 6 % de la bande passante NVLink intra-nœud. C'est pourquoi les stratégies de parallélisme placent systématiquement les communications les plus fréquentes (tensor parallelism) à l'intérieur d'un nœud, et réservent les communications inter-nœuds aux échanges les moins fréquents (data parallelism, pipeline parallelism).
Les primitives collectives : ce qui se passe réellement pendant un AllReduce
Quand N GPU doivent moyenner un tenseur de gradients identique en taille sur chacun, l'opération s'appelle un AllReduce. L'implémentation la plus répandue, le Ring-AllReduce, découpe le tenseur en N segments et fait circuler ces segments sur un anneau logique en deux phases :
- Scatter-reduce — chaque GPU envoie un segment à son voisin et reçoit le segment correspondant de son autre voisin, en accumulant la somme au passage. Après N-1 étapes, chaque GPU détient la somme complète d'un segment.
- All-gather — les segments complets circulent à nouveau sur l'anneau pendant N-1 étapes supplémentaires, jusqu'à ce que chaque GPU possède le tenseur entier réduit.
Au total, 2(N-1) étapes de communication sont nécessaires, et chaque GPU émet et reçoit environ 2 fois la taille du tenseur divisée par N. La particularité du Ring-AllReduce est que la bande passante utilisée par GPU ne dépend pas de N : c'est un algorithme optimal en bande passante. Sa limite est la latence, qui croît linéairement avec le nombre de GPU — problématique au-delà de quelques dizaines de participants.
Pour les configurations à très grand nombre de GPU (centaines à milliers), NCCL bascule sur des algorithmes en arbre (double binary tree), qui réduisent la latence en log(N) au prix d'un usage légèrement moins optimal de la bande passante. NCCL choisit automatiquement l'algorithme et le protocole (Simple, LL, LL128) selon la taille du message et la topologie détectée — un comportement observable via NCCL_DEBUG=INFO.
NCCL en pratique
NCCL (NVIDIA Collective Communications Library) est la couche qui implémente ces collectives (AllReduce, BroadcastbroadcastRéseauxEnvoi d'une trame à toutes les machines d'un même réseau local simultanément. C'est le mécanisme employé par ARP ou DHCP quand le destinataire n'est pas encore connu.Voir dans le glossaire, AllGather, ReduceScatter, Send/Recv point-à-point) en exploitant automatiquement NVLink, PCIe P2P et le réseau, sans que le code applicatif ait à connaître la topologie. PyTorch, TensorFlow, Horovod et DeepSpeed s'appuient tous dessus en interne.
Quelques leviers concrets pour diagnostiquer ou ajuster son comportement :
NCCL_DEBUG=INFO— affiche l'algorithme, le protocole et les canaux choisis pour chaque collective ; indispensable en cas de scaling décevant.NCCL_IB_DISABLE=1— force NCCL à retomber sur TCPTCPRéseauxProtocole de transport qui garantit que les données arrivent complètes, dans l'ordre et sans doublon. Il établit une connexion, numérote chaque segment et retransmet ce qui manque.Voir dans le glossaire/Ethernet si InfiniBand pose problème (diagnostic, pas une solution de production).NCCL_SOCKET_IFNAME— force l'interface réseau utilisée, utile quand plusieurs NIC sont présentes et que NCCL en sélectionne une mal adaptée.NCCL_P2P_LEVEL— contrôle l'usage du peer-to-peer PCIe direct entre GPU proches.NCCL_TOPO_FILE— permet de fournir une description explicite de la topologie quand la détection automatique échoue (fréquent sur certaines VM cloud virtualisées).
Avant de suspecter un bug applicatif face à un scaling décevant, lancez un job avec
NCCL_DEBUG=INFOet cherchez la ligne indiquant l'algorithme retenu. Un AllReduce qui bascule sur le protocole réseau le plus lent alors que les GPU sont censés partager un NVSwitch révèle presque toujours un problème de détection de topologie ou de driver, pas un problème de modèle.
Distributed Data Parallel avec PyTorch
DDP (torch.nn.parallel.DistributedDataParallel) est le mode de parallélisme de données par défaut de PyTorch. Chaque processus possède une copie complète du modèle sur un GPU dédié, traite un sous-lot différent, calcule son forward et son backward indépendamment, puis synchronise les gradients par AllReduce avant l'étape d'optimiseur. Le point clé : cette synchronisation n'attend pas la fin complète du backward. Des hooks se déclenchent dès qu'un groupe de paramètres (« bucket ») a fini d'accumuler son gradient, ce qui permet de recouvrir la communication par le calcul restant du backward.
import torch.distributed as dist
from torch.nn.parallel import DistributedDataParallel as DDP

dist.init_process_group(backend="nccl")
model = MyModel().to(local_rank)
model = DDP(model, device_ids=[local_rank])
# lancement : torchrun --nproc_per_node=8 train.py
La taille des buckets (
bucket_cap_mb, 25 Mo par défaut) détermine le recouvrement communication/calcul. Des buckets trop petits multiplient les lancements de collectives et augmentent l'overhead fixe par appel ; des buckets trop grands retardent le déclenchement de l'AllReduce et réduisent le recouvrement. Sur des modèles aux couches très hétérogènes en taille, ajuster ce paramètre peut faire gagner plusieurs points d'efficacité de scaling sans toucher au modèle.
DDP suppose que chaque GPU peut contenir une copie complète du modèle, de ses gradients et de l'état de l'optimiseur. Pour les modèles qui dépassent cette contrainte, il faut changer de stratégie.
Sharding pour l'entraînement et l'inférence à grande échelle
Trois familles de sharding répondent à la limite mémoire de DDP :
- Tensor parallelism — chaque couche (typiquement les projections linéaires des blocs attentionattentionIAMécanisme par lequel un modèle pondère l'importance de chaque token du contexte lorsqu'il en traite un autre, quelle que soit la distance qui les sépare.Voir dans le glossaire et MLP) est découpée entre GPU, qui calculent chacun une portion de la couche et se synchronisent par AllReduce ou AllGather à chaque couche. Le volume de communication est élevé et fréquent : cette stratégie n'est viable qu'à l'intérieur d'un nœud, sur liens NVLink.
- Pipeline parallelism — les couches du modèle sont réparties en segments séquentiels sur des GPU différents ; les activations transitent d'un segment à l'autre. Moins gourmand en bande passante que le tensor parallelism, mais introduit une « bulle » d'inactivité pendant le remplissage et la vidange du pipeline, qui pénalise l'efficacité si le micro-batch est trop petit ou le nombre d'étages trop élevé.
- ZeRO / FSDP (Fully Sharded Data Parallel) — au lieu de dupliquer l'état de l'optimiseur, les gradients et les paramètres sur chaque GPU, ZeRO les partitionne. Stage 1 partitionne l'état de l'optimiseur, stage 2 ajoute les gradients, stage 3 ajoute les paramètres eux-mêmes, reconstitués par AllGather juste avant chaque utilisation puis relâchés. Le gain mémoire est considérable, au prix d'un volume de communication supérieur à DDP classique.
Un modèle de 70 milliards de paramètres en précisionprécisionIAProportion des alertes émises par un modèle qui sont justifiées. Elle s'oppose au rappel : améliorer l'une dégrade l'autre.Voir dans le glossaire mixte représente environ 140 Go rien que pour les poids, avant gradients et état Adam (qui double ou triple ce volume). Aucun GPU actuel ne loge cela seul. Une configuration réaliste combine tensor parallelism à 4 ou 8 voies à l'intérieur du nœud (liens NVLink), pipeline parallelism entre nœuds, et ZeRO stage 1 ou 2 pour l'état de l'optimiseur — plutôt qu'une seule stratégie appliquée uniformément.
Pour l'inférenceinférenceIAUtilisation d'un modèle déjà entraîné sur une donnée nouvelle. Peu coûteuse à l'unité mais répétée à chaque requête, elle constitue le coût récurrent d'exploitation.Voir dans le glossaire pure, le sharding privilégié diffère : le tensor parallelism reste pertinent pour réduire la latence par requête sur de très gros modèles, mais on lui préfère souvent des découpages plus simples (pipeline entre nœuds, ou réplication complète du modèle sur des GPU indépendants) quand la métrique visée est le débit global plutôt que la latence d'une requête unique.
Pourquoi le scaling casse : l'arithmétique de la rentabilité
L'efficacité de scaling peut se résumer par un ratio simple : temps de calcul divisé par (temps de calcul + temps de communication non recouvert). Ajouter des GPU réduit le temps de calcul par GPU, mais le volume de communication ne diminue pas dans les mêmes proportions — il dépend de la taille du modèle, pas du nombre de GPU. Mécaniquement, la part relative de la communication augmente à mesure que le nombre de GPU croît, jusqu'à ce que l'ajout d'une carte supplémentaire n'apporte plus qu'un gain marginal.
Quelques repères observés en pratique :
- Sur un nœud unique avec NVSwitch, une efficacité de scaling de 85 à 95 % jusqu'à 8 GPU est courante pour des modèles suffisamment grands (le calcul par GPU domine largement la communication).
- Passer à plusieurs nœuds fait typiquement chuter cette efficacité de 10 à 30 points supplémentaires, selon la bande passante réseau disponible et le recouvrement effectif calcul/communication.
- Pour de petits modèles ou de petits batchs, le temps de calcul par GPU devient trop court pour recouvrir la latence des collectives : au-delà d'un certain nombre de GPU, le temps d'époque peut cesser de diminuer, voire augmenter.
Ce phénomène n'est pas spécifique à NCCL ou à PyTorch : c'est une conséquence directe de la loi d'Amdahl appliquée à la fraction non parallélisable d'un job — ici, la synchronisation. Aucune optimisation logicielle ne fait disparaître cette borne, elle ne fait que la repousser.
En pratique, cela signifie qu'un budget GPU doublé ne réduit pas nécessairement le temps d'entraînement de moitié, et que la question pertinente n'est pas « combien de GPU puis-je me payer » mais « à partir de combien de GPU le gain marginal ne couvre-t-il plus le coût marginal ». Mesurer l'efficacité de scaling réel (temps observé vs. temps théorique en scaling linéaire) sur un run court avant d'engager un budget de calcul important évite des semaines de calcul sous-optimal.
Checklist avant d'investir dans le multi-GPU
- Le modèle et le batch sont-ils assez gros pour que le calcul par GPU domine largement la communication au nombre de GPU visé ?
- La topologie réelle de la machine ou de l'instance cloud a-t-elle été vérifiée (
nvidia-smi topo -m), pas seulement supposée à partir de la fiche produit ? - Le sharding choisi (tensor, pipeline, ZeRO) est-il aligné avec la topologie — communications fréquentes sur NVLink, communications rares entre nœuds ?
- Un test de scaling court (2, 4, 8 GPU) a-t-il été mesuré avant de réserver la configuration cible ?
- Le gain de temps attendu justifie-t-il le surcoût, une fois l'efficacité de scaling réelle prise en compte plutôt qu'un scaling linéaire supposé ?
- Une alternative mono-GPU avec quantification, gradient checkpointing ou offloading CPU a-t-elle été chiffrée comme point de comparaison ?
L'essentiel à retenir
Ce chapitre explique pourquoi la topologie physique — PCIe, NVLink, NVSwitch, réseau inter-nœuds — plafonne les gains du multi-GPU avant même d'écrire une ligne de code. Il détaille le fonctionnement des collectives de communication (Ring-AllReduce, arbres) implémentées par NCCL, leur intégration dans PyTorch DDP, et les stratégies de sharding (tensor parallelism, pipeline parallelism, ZeRO/FSDP) pour l'entraînement et l'inférence à grande échelle. Il se termine par une lecture chiffrée des inefficacités de scaling et une checklist pour décider si un investissement multi-GPU est réellement justifié.
Questions fréquentes
Faut-il toujours du NVLink pour faire du multi-GPU ?
Quelle est la différence concrète entre data parallelism et tensor parallelism ?
Comment savoir si mon entraînement multi-GPU est bien scalé ?
NCCL fonctionne-t-il entre GPU de fournisseurs cloud différents ou de générations différentes ?
Le pipeline parallelism vaut-il le coup pour mon cas ?
Comment déboguer un blocage (hang) NCCL qui bloque tout le job sans message d'erreur clair ?
Le multi-GPU peut-il coûter plus cher qu'il ne rapporte ?
Progression sauvegardée dans votre navigateur.
Quiz de validation
Quiz Player
Quiz de validation
Plusieurs réponses possibles — validez ensuite.
Vrai ou faux.
Quiz indisponible (données invalides).