





Atelier : checklist production
Parcourir un cluster fictif comme un auditeur : six stations, findings priorisés et plan de remédiation sur 30 jours pour une équipe plateforme réaliste.
Table des matières
Le cluster fictif : NordCloud Retail
Vous intervenez chez NordCloud Retail, enseigne de e-commerce qui exploite un cluster Kubernetes managé (EKS) en production depuis dix-huit mois. Trois namespaces métier (checkout, catalog, loyalty), un namespace partagé platform (ingress, monitoring, CI runners), et un environnement de préproduction staging sur le même cluster. L'équipe plateforme compte quatre ingénieurs ; les équipes produit déploient via GitOps (Argo CD). Aucun audit de sécurité Kubernetes n'a encore été formalisé.
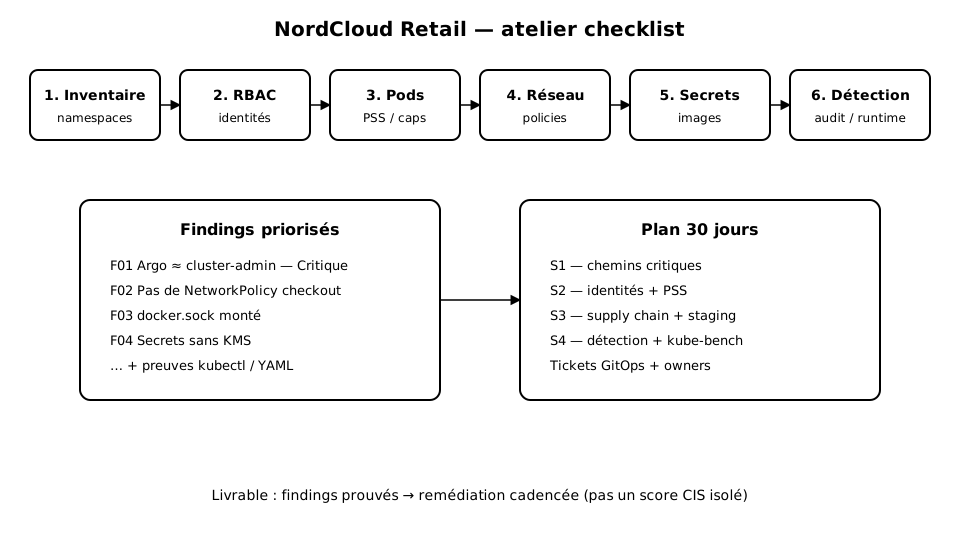
Votre mission : en une journée d'atelier, parcourir le cluster comme un auditeur, produire une liste de findings priorisés, puis bâtir un plan de remédiation sur 30 jours réaliste pour une équipe de cette taille. Cet atelier synthétise les chapitres précédents : surface d'attaque, RBAC, Pod Security, Network Policies, secrets, supply chain, runtime et hardening CIS.
Un atelier de checklist n'est pas un test d'intrusion. Vous ne cherchez pas à « casser » le cluster : vous vérifiez, documentez et priorisez. Chaque finding doit être reproductible, assignable et mesurable — sinon il ne survivra pas à la réunion avec le COMEX.
Méthode : parcours en six stations
Travaillez dans l'ordre suivant. Chaque station produit des findings bruts ; la priorisation vient ensuite.
| Station | Question directrice | Artefacts à collecter |
|---|---|---|
| 1. Inventaire | Qu'est-ce qui tourne, où, avec quels droits ? | Inventaire namespaces, Deployments, SA |
| 2. Identités | Qui peut faire quoi sur l'API ? | ClusterRoleBindings critiques |
| 3. Workloads | Les Pods sont-ils isolés et durcis ? | PSS, capabilities, privileged |
| 4. Réseau | L'est-ouest est-il filtré ? | NetworkPolicies présentes/absentes |
| 5. Secrets & images | Où sont les secrets ? Qui signe les images ? | Secrets en clair, registries |
| 6. Observabilité | Que verrait-on en cas d'incident ? | Audit logs, runtime, alertes |
Chronométrez chaque station (45–60 min). Si vous bloquez sur un finding ambigu, notez-le en « à clarifier » et passez. Un atelier incomplet mais structuré vaut mieux qu'une exploration sans livrable.
Station 1 — Inventaire et surface
Sur le cluster NordCloud, l'inventaire révèle immédiatement trois écarts :
- Le namespace
defaultcontient encore des workloads (un Job de migration oublié et un Pod de debugkubectl-rundatant de trois semaines). Tout ce qui vit dansdefaulthérite souvent de politiques plus permissives et brouille la cartographie des responsabilités. - Des DaemonSets dans
platformmontent le socketsocketRéseauxAssociation d'une adresse IP et d'un port, qui identifie une extrémité de communication. Le quadruplet formé par les deux sockets d'une connexion la distingue de toutes les autres.Voir dans le glossaire Docker (/var/run/docker.sock) pour des besoins de monitoring legacy. C'est un chemin classique d'élévation vers le nœud. - Staging et production partagent le même cluster sans isolation forte de nœuds ni de Network Policies inter-namespaces. Un Pod staging compromis peut atteindre les services de
checkoutsi les règles réseau le permettent.
Documentez chaque élément avec : namespace, ressource, propriétaire GitOps (chemin du manifeste), et preuve (commande kubectl ou extrait YAML). Sans preuve, le finding ne compte pas.
Station 2 — RBAC et identités
La revue des ClusterRoleBinding sort trois findings majeurs :
- Le ServiceAccount
argo-cd-serverdispose d'un binding vers un ClusterRole quasicluster-admin« pour faciliter les sync ». En pratique, une compromission de l'UI Argo CD = contrôle total du cluster. - Plusieurs équipes produit partagent le SA
defaultdu namespace, avecautomountServiceAccountToken: trueimplicite. Tout Pod qui n'a pas besoin de l'API Kubernetes reçoit quand même un tokentokenIAFragment de texte manipulé par un modèle de langage, généralement plus court qu'un mot — trois à quatre caractères en français. La tarification et la limite de contexte se comptent en tokens.Voir dans le glossaire. - Un utilisateur humain
devops-oncallest lié àcluster-adminvia un binding permanent, sans MFA côté IdP et sans expiration.
Ne corrigez pas les bindings critiques en live pendant l'atelier sans plan de rollback. Documentez, proposez un rôle moindre, et planifiez le changement dans la fenêtre de maintenance. Un binding cassé peut bloquer GitOps et tout le pipeline de déploiement.
Pour chaque binding excessif, proposez un rôle cible (liste de verbes/ressources) plutôt qu'un simple « retirer cluster-admin ». La remédiation sans alternative opérationnelle sera rejetée par l'équipe plateforme.
Station 3 — Pod Security et isolation
Aucun namespace n'a de label pod-security.kubernetes.io/enforce. Les Pods de checkout tournent majoritairement en root ; deux Deployments demandent privileged: true pour des sidecars de capture réseau non justifiés depuis la migration vers un CNI moderne. Les capabilities NET_ADMIN et SYS_ADMIN apparaissent dans loyalty.
Checklist rapide à cocher pour chaque namespace critique :
- Profil PSS
baselinepuis trajectoire versrestricted runAsNonRoot: true+readOnlyRootFilesystem: truelà où compatible- Drop de toutes les capabilities, add ciblé documenté
seccompProfile.type: RuntimeDefault- Interdiction de
hostNetwork,hostPID,hostIPChors exceptions signées
Station 4 — Network Policies
Le CNI (Calico) est capable de Network Policies, mais aucune policy n'existe hors d'un essai abandonné dans staging. Le trafic est-ouest est donc permissif par défaut : un Pod catalog peut joindre la base Redis de checkout, et les runners CI dans platform peuvent scraper des endpoints internes non exposés.
Proposez un modèle progressif :
- Default deny ingress/egress sur
checkoutetloyalty - Autoriser DNSDNSRéseauxSystème qui traduit un nom de domaine en adresse IP, par interrogations successives de la racine, des serveurs de premier niveau puis des serveurs faisant autorité.Voir dans le glossaire (kube-dns) et les flux métier documentés uniquement
- Isoler
stagingde la production au niveau réseau, même sur cluster partagé - Mesurer les cassures via métriques d'erreur applicatives avant généralisation
Station 5 — Secrets et supply chain
NordCloud stocke encore des mots de passe de bases dans des Secrets Kubernetes non chiffrés au repos côté etcd (encryptionConfig absent sur le control plane managé… en réalité sur EKS le chiffrementchiffrementCybersécuritéTransformation d'une donnée lisible en une forme inintelligible à l'aide d'une clé. Le destinataire disposant de la clé peut retrouver le message original. C'est le socle de la confidentialité sur Internet.Voir dans le glossaire KMS est optionnel et n'a pas été activé). Plusieurs Deployments injectent des secrets en variables d'environnement plutôt qu'en volume fichier. Les images viennent d'un registry public pour deux sidecars, sans signature Cosign ni politique d'admission.
Findings typiques à formuler :
- Activer le chiffrement des Secrets via KMS provider
- Migrer vers External Secrets / Secrets Store CSI pour les secrets métier
- Interdire les images
:latestet les registries non allowlistés - Introduire signature + admission (Kyverno ou Gatekeeper) sur
checkoutd'abord
Station 6 — Runtime, audit et détection
Les audit logs API sont activés au niveau EKS mais aucune règle d'alerte ne surveille create de Pods privileged, les bindings cluster-admin, ou les exec dans les Pods de production. Aucun agentagentIASystème qui enchaîne des appels d'outils de façon autonome pour atteindre un objectif : il planifie, agit, observe, recommence. Sa fiabilité décroît exponentiellement avec le nombre d'étapes.Voir dans le glossaire runtime type Falco n'est déployé. En cas d'incident, l'équipe disposerait de logs bruts difficilement exploitables sous la pression.
Livrable de cette station : une liste de cinq alertes prioritaires + un runbook d'une page pour « Pod privileged créé en production ».
Findings synthétiques de NordCloud Retail
Après consolidation, voici le tableau de findings que vous présenteriez (extrait réaliste) :
| ID | Finding | Sévérité | Exploitabilité | Station |
|---|---|---|---|---|
| F01 | Binding Argo CD ≈ cluster-admin | Critique | Haute (UI exposée SSO) | 2 |
| F02 | Pas de NetworkPolicy sur checkout | Haute | Haute (est-ouest ouvert) | 4 |
| F03 | docker.sock monté (DaemonSet) | Haute | Haute (nœud) | 1 |
| F04 | Secrets sans encryption KMS | Haute | Moyenne | 5 |
| F05 | Aucun PSS enforce | Moyenne | Moyenne | 3 |
| F06 | Images non signées / registry public | Moyenne | Moyenne | 5 |
| F07 | SA default + automount | Moyenne | Moyenne | 2 |
| F08 | Staging↔prod non isolés | Moyenne | Haute si staging faible | 1/4 |
| F09 | Pas d'alertes audit runtime | Moyenne | — (détection) | 6 |
| F10 | devops-oncall cluster-admin permanent | Haute | Moyenne | 2 |
Pour F01, la preuve est un extrait
kubectl get clusterrolebinding -o yamlmontrant le sujetsystem:serviceaccount:platform:argo-cd-serverlié à un ClusterRole listant*.*. La remédiation proposée : ClusterRole limité aux ressources syncées + impersonation contrôlée, testé d'abord sur un ApplicationSet non critique.
Plan de remédiation 30 jours
Un plan crédible pour quatre ingénieurs plateforme, sans arrêter le business :
Semaine 1 — Couper les chemins critiques
- Réduire le binding Argo CD ; journaliser les syncs
- Retirer ou isoler le DaemonSet docker.sock
- Activer encryption KMS des Secrets
- Poser default-deny NetworkPolicy sur
checkout(mode audit puis enforce)
Semaine 2 — Identités et Pod Security
- Remplacer
devops-oncallcluster-admin par un rôle time-bound (JIT) automountServiceAccountToken: falsepar défaut + SA dédiés- PSS
baselineenforce surloyaltyetcatalog, warn surcheckout
Semaine 3 — Supply chain et isolation staging
- Allowlist registries + interdiction
:latestvia admission - Signature Cosign sur les images
checkout - NetworkPolicies isolant
stagingdes namespaces prod
Semaine 4 — Détection et pérennisation
- Cinq alertes audit + runbook privileged Pod
- Déployer Falco (ou équivalent) en mode detect
- CronJob kube-bench + registre d'exceptions
- Revue COMEX : indicateurs (bindings admin, % namespaces PSS, policies réseau)
Comment écrire un finding qui passe en comité
Chaque finding doit tenir sur une fiche :
- Titre factuel (pas « sécurité insuffisante »)
- Preuve (commande, extrait, capture)
- Impact métier en une phrase (ex. : « accès aux paiements via checkout »)
- Effort estimé (jours-personne) et risque de régression
- Owner nommé et date cible
Sans owner et sans date, le finding rejoint le cimetière des audits. Le plan 30 jours ci-dessus n'est utile que s'il est découpé en tickets GitOps avec revue de merge.
Pièges de l'atelier
- Tout classer Critique — dilue l'attentionattentionIAMécanisme par lequel un modèle pondère l'importance de chaque token du contexte lorsqu'il en traite un autre, quelle que soit la distance qui les sépare.Voir dans le glossaire ; gardez 2–3 critiques maximum.
- Corriger sans GitOps — un
kubectl edithors dépôt sera écrasé au prochain sync. - Ignorer le staging partagé — souvent le vrai pivot d'attaque vers la prod.
- Oublier la détection — un cluster durci sans alerte laisse l'incident invisible.
- Promettre 100 % CIS en 30 jours — irréaliste ; visez les contrôles à fort impact.
Checklist de clôture de l'atelier
- Inventaire namespaces / owners à jour
- Tableau findings avec sévérité et preuves
- Plan 30 jours découpé en tickets
- Exceptions documentées (registre)
- Métriques de suivi définies pour le mois suivant
- Date de re-scan kube-bench et revue RBAC calendrées
Vous sortez de cet atelier avec une méthode rejouable : six stations, findings prouvés, plan cadencé. C'est ce livrable — pas un score CIS isolé — qui fait progresser réellement la posture du cluster NordCloud Retail, et la vôtre sur vos prochains audits.
Mesurer le succès après 30 jours
Le plan n'a de valeur que s'il se traduit en indicateurs suivis. Pour NordCloud Retail, définissez un tableau de bord minimal dès la clôture de l'atelier :
| Indicateur | Cible à 30 jours | Source |
|---|---|---|
Bindings cluster-admin hors break-glass |
≤ 1 (JIT documenté) | kubectl get clusterrolebinding |
| Namespaces métier avec PSS enforce ≥ baseline | ≥ 2/3 | labels namespaces |
| Namespaces avec NetworkPolicy default-deny | checkout + loyalty |
API networking |
| Secrets chiffrés au repos (KMS) | activé | config control plane / console EKS |
| Alertes audit sur événements privilégiés | ≥ 5 règles actives | SIEM / CloudWatch |
Rejouez les stations 2, 4 et 6 à J+30 avec les mêmes commandes de preuve. Si un indicateur régresse, le finding revient en Critique automatique — c'est le contrat passé avec le COMEX. Documentez aussi le temps réellement passé par l'équipe plateforme : un plan 30 jours qui a demandé 60 jours-personne n'est pas un échec de sécurité, c'est un calibrage pour le prochain cycle.
L'essentiel à retenir
Cet atelier applique l'ensemble du parcours sécurité Kubernetes sur le cluster fictif NordCloud Retail (EKS). Six stations — inventaire, RBAC, Pod Security, Network Policies, secrets/supply chain, détection — produisent des findings prouvés et priorisés. Le chapitre propose un plan de remédiation sur 30 jours adapté à une petite équipe plateforme, avec critères de rédaction des findings et pièges à éviter. L'objectif est un livrable actionnable pour le COMEX, pas un score CIS cosmétique.
Questions fréquentes
Faut-il un cluster de lab pour suivre cet atelier ?
Combien de findings faut-il viser pour un atelier d'une journée ?
Comment prioriser si l'équipe plateforme n'a que deux ingénieurs ?
Les Network Policies cassent-elles forcément la production au premier enforce ?
Faut-il attendre d'avoir Falco avant de publier le plan 30 jours ?
Que faire des exceptions qui ne seront pas corrigées en 30 jours ?
Cet atelier remplace-t-il kube-bench et les CIS Benchmarks ?
Progression sauvegardée dans votre navigateur.
Quiz de validation
Quiz Player
Quiz de validation
Plusieurs réponses possibles — validez ensuite.
Vrai ou faux.
Quiz indisponible (données invalides).