





Hardening et audit
Mettre en œuvre les CIS Benchmarks Kubernetes avec kube-bench, interpréter les résultats et prioriser les corrections qui réduisent réellement la surface d'attaque du cluster.
Table des matières
Pourquoi ce chapitre compte
Avoir déployé RBAC, des Network Policies et un contrôleur d'admission ne garantit pas un cluster durci. Chaque brique de sécurité repose sur des dizaines de paramètres de configuration fins — flags de l'API server, permissions de fichiers sur les nœuds, options d'exposition du kubelet — que personne ne vérifie manuellement de façon fiable. C'est le rôle du hardening et de l'audit : transformerTransformerIAArchitecture introduite en 2017, fondée sur le mécanisme d'attention, qui traite une séquence entière en parallèle. Elle sert de base à tous les grands modèles de langage actuels.Voir dans le glossaire des bonnes pratiques dispersées en une checklist vérifiable, rejouable, et versionnée.
Ce chapitre s'appuie sur les CIS Benchmarks, le référentiel de facto pour l'audit Kubernetes, et sur kube-bench, l'outil qui l'automatise. L'objectif n'est pas de viser 100 % de conformité — un score élevé sans priorisation est un indicateur trompeur — mais d'identifier les écarts qui comptent réellement pour votre modèle de menace.
Un audit CIS n'est pas un test de pénétration. Il vérifie des configurations statiques, pas des chemins d'exploitation réels. Un cluster à 95 % de conformité CIS peut rester vulnérable si un seul contrôle critique — par exemple l'anonymous-auth de l'API server — reste actif.
Le référentiel CIS Benchmarks Kubernetes
Le Center for Internet Security publie un benchmark Kubernetes structuré en sections qui reflètent l'architecture du cluster :
- Control Plane — API server, controller-manager, scheduler
- etcd — la base de donnéesdonnéesIAEnsemble d'informations structurées ou non utilisées pour entraîner, évaluer ou alimenter un modèle. La qualité, la quantité et la représentativité des données sont les facteurs décisifs pour les performances en apprentissage automatique.Voir dans le glossaire de vérité du cluster
- Control Plane Configuration — fichiers de configuration et permissions
- Worker Nodes — kubelet, kube-proxy, configuration des nœuds
- Policies — RBAC, Pod Security Standards, Network Policies
Chaque contrôle porte un identifiant (par exemple 1.2.1, 4.2.6) et une sévérité — Scored ou Not Scored selon qu'il est vérifiable automatiquement. Le benchmark existe en plusieurs versions alignées sur les versions mineures de Kubernetes, et en variantes adaptées aux distributions managées : EKS, GKE, AKS ont chacun un profil dédié, car certains contrôles ne sont pas actionnables sur un control plane géré par le cloud provider.
Sur EKS, GKE ou AKS, le control plane appartient au fournisseur cloud. Auditer les sections "Control Plane" avec le profil générique produira des FAIL sur des contrôles hors de votre contrôle direct. Utilisez toujours le profil kube-bench correspondant à votre distribution (
eks-1.2.0,gke-1.2.0, etc.).
kube-bench : fonctionnement et mise en œuvre
kube-bench, développé par Aqua Security, exécute les tests du benchmark CIS sous forme de scripts shell qui interrogent la configuration réelle du cluster : contenu des fichiers de manifests statiques, arguments de ligne de commande des processus, permissions Unix, valeurs retournées par l'API.
Deux modes de déploiement dominent :
- Exécution en Job Kubernetes, qui monte les répertoires hôtes pertinents (
/etc/kubernetes,/var/lib/kubelet) en volumes pour inspecter la configuration réelle des nœuds sans installation locale. - Exécution en binaire sur l'hôte, utile pour un audit ponctuel via SSHSSHRéseauxProtocole sécurisé d'accès distant à un serveur, chiffrant session et authentification (clé ou mot de passe).Voir dans le glossaire sur un nœud, notamment en environnement air-gapped.
apiVersion: batch/v1
kind: Job
metadata:
  name: kube-bench
spec:
  template:
    spec:
      hostPID: true
      containers:
        - name: kube-bench
          image: aquasec/kube-bench:v0.9.1
          command: ["kube-bench", "run", "--targets", "node,policies"]
          volumeMounts:
            - name: var-lib-kubelet
              mountPath: /var/lib/kubelet
              readOnly: true
            - name: etc-kubernetes
              mountPath: /etc/kubernetes
              readOnly: true
      restartPolicy: Never
      volumes:
        - name: var-lib-kubelet
          hostPath: { path: /var/lib/kubelet }
        - name: etc-kubernetes
          hostPath: { path: /etc/kubernetes }
Le flag --targets permet de restreindre l'exécution à certaines sections. Sur un cluster managé, on limitera typiquement l'audit aux nœuds (node) et aux politiques (policies), le control plane étant hors périmètre.
Le Job kube-bench requiert
hostPID: trueet des montages en lecture sur des répertoires sensibles de l'hôte. Ne l'exécutez jamais avec un ServiceAccount disposant de droits étendus, et supprimez le Job après collecte du rapport. Un Pod capable de lire/etc/kubernetes/pkiest lui-même une surface d'attaque à traiter avec la même rigueur que ce qu'il audite.
Lire et interpréter les résultats
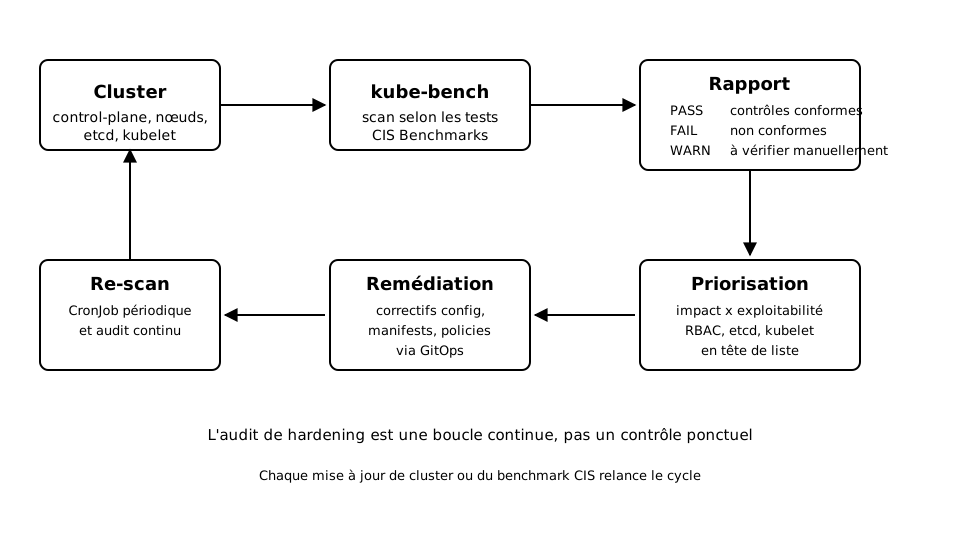
La sortie de kube-bench classe chaque contrôle en trois états :
| État | Signification | Action |
|---|---|---|
| PASS | Configuration conforme au benchmark | Aucune, surveiller la régression |
| FAIL | Configuration non conforme, vérifiable automatiquement | Corriger ou documenter une exception |
| WARN | Contrôle non automatisable, nécessite une revue manuelle | Vérifier manuellement puis statuer |
Les WARN sont souvent ignorés à tort. Beaucoup de contrôles à fort impact — comme la revue des règles RBAC accordant cluster-admin, ou la vérification qu'aucun secret n'est monté en variable d'environnement en clair — tombent dans cette catégorie précisément parce qu'ils dépendent du contextefenêtre de contexteIAQuantité de texte qu'un modèle peut prendre en compte simultanément : question, documents fournis et historique. Au-delà, les éléments les plus anciens sortent du champ.Voir dans le glossaire métier et ne peuvent pas être évalués par un script générique.
Contrôles prioritaires
Sur un cluster réel, traiter les dizaines de FAIL par ordre alphabétique d'identifiant est une perte de temps. Voici les contrôles qui réduisent le plus la surface d'attaque, classés par composant.
etcd
- ChiffrementchiffrementCybersécuritéTransformation d'une donnée lisible en une forme inintelligible à l'aide d'une clé. Le destinataire disposant de la clé peut retrouver le message original. C'est le socle de la confidentialité sur Internet.Voir dans le glossaire du trafic client-serveur et peer-to-peer via TLSTLSRéseauxProtocole cryptographique assurant confidentialité et intégrité des communications applicatives (notamment HTTPS).Voir dans le glossaire (contrôles 2.1 à 2.7)
--client-cert-auth=truepour exiger une authentification par certificat client- Permissions du répertoire de données etcd restreintes à
700
etcd contient l'intégralité de l'état du cluster, secrets compris. Un accès en lecture à etcd sans chiffrement au repos équivaut à un accès root sur tous les Secrets Kubernetes.
API server
--anonymous-auth=false— désactive l'accès anonyme à l'API--insecure-port=0— supprime le portportRéseauxNuméro sur 16 bits qui désigne l'application destinataire sur une machine. Les ports 0 à 1023 sont réservés aux services système, comme 443 pour HTTPS.Voir dans le glossaire HTTP non chiffré (déjà par défaut depuis 1.20+, à vérifier sur les clusters anciens)--authorization-modeincluantNode,RBAC, sansAlwaysAllow--audit-log-pathconfiguré pour tracer les appels API
kubelet
--anonymous-auth=falsesur chaque nœud--authorization-mode=Webhookplutôt qu'AlwaysAllow- Port en lecture seule (
--read-only-port) désactivé — il exposait historiquement des métadonnées de Pods sans authentification
Un kubelet avec
--read-only-port=10255actif et accessible depuis le réseau expose sans authentification la liste des Pods du nœud, leurs variables d'environnement et parfois des jetons de ServiceAccount montés. Un attaquant ayant un accès réseau au nœud — via un Pod compromis sur le même VPC, par exemple — peut lister ces informations sans jamais interroger l'API server ni déclencher les logs d'audit habituels.
RBAC et comptes de service
- Aucune liaison
ClusterRoleBindingverscluster-adminen dehors des comptes d'administration identifiés automountServiceAccountToken: falsepar défaut sur les Pods qui n'appellent pas l'API Kubernetes- Comptes de service dédiés par workload, jamais le
defaultdu namespace
Priorisation : la matrice impact × exploitabilité
Face à une liste de FAIL, classez chaque contrôle selon deux axes : l'impact en cas d'exploitation (accès à des secrets, élévation de privilèges, contrôle total du cluster) et la facilité d'exploitation (accessible depuis le réseau externe, depuis un Pod compromis, ou uniquement avec un accès local au nœud).
Un FAIL sur les permissions de fichiers d'un manifest statique (600 au lieu de 644) a un impact réel mais nécessite déjà un accès local au nœud pour être exploité — l'attaquant a alors probablement déjà d'autres options. Un anonymous-auth activé sur l'API server, en revanche, est exploitable depuis n'importe quel point du réseau qui atteint le endpoint, sans identifiants. Traitez ce second cas en premier, systématiquement.
Ne corrigez pas les FAIL un par un au fil de leur apparition dans le rapport. Exportez la liste complète, triez-la manuellement selon la matrice impact × exploitabilité, et traitez les cinq à dix contrôles les plus critiques avant de vous soucier du taux de conformité global. Un score de 70 % concentré sur les bons contrôles vaut mieux qu'un score de 95 % qui laisse passer l'anonymous-auth.
Automatiser l'audit en continu
Un audit exécuté une fois lors de la mise en production perd sa valeur dès la première dérivedériveIADégradation progressive des performances d'un modèle après son déploiement, causée par l'évolution des comportements ou du contexte. Elle impose surveillance et réentraînement.Voir dans le glossaire de configuration — un correctif d'urgence qui réactive un flag, un opérateur tiers qui redéploie un DaemonSet avec des permissions plus larges. Deux approches complémentaires permettent de maintenir l'audit à jour :
- CronJob périodique exécutant kube-bench sur chaque nœud et exportant les résultats vers un système de collecte (Prometheus via un exporter, ou simplement des logs centralisés), avec alerte sur toute régression d'un contrôle précédemment PASS.
- Étape CI/CD sur les manifests avant déploiement, à l'aide d'outilstool callingIACapacité d'un agent ou d'un LLM à invoquer des outils externes (API, calcul, recherche) pendant le raisonnement.Voir dans le glossaire complémentaires comme kubeaudit, Polaris ou Trivy en mode config-scan, qui appliquent des règles similaires directement sur les fichiers YAML avant qu'ils n'atteignent le cluster.
Cette seconde approche déplace le contrôle à gauche : plutôt que de détecter une dérive après coup, on bloque au niveau de la pull request un manifest qui monterait un ServiceAccount avec un tokentokenIAFragment de texte manipulé par un modèle de langage, généralement plus court qu'un mot — trois à quatre caractères en français. La tarification et la limite de contexte se comptent en tokens.Voir dans le glossaire automatique inutile, ou un conteneur en privileged: true non justifié.
Au-delà de CIS : ce que le benchmark ne couvre pas
Les CIS Benchmarks Kubernetes se concentrent sur la configuration du cluster lui-même — control plane, etcd, nœuds, politiques RBAC. Ils ne couvrent pas certains aspects pourtant centraux d'une posture de sécurité complète, et un audit qui s'arrête à kube-bench laisse des angles morts.
Les Pod Security Standards (PSS) définissent trois profils — privileged, baseline, restricted — appliqués via l'admission controller natif PodSecurity. Le CIS benchmark recommande leur activationfonction d'activationIAOpération non linéaire appliquée en sortie d'un neurone. Sans elle, empiler des couches serait inutile : une succession d'opérations linéaires reste équivalente à une seule.Voir dans le glossaire mais ne vérifie pas finement quel profil est appliqué à quel namespace. Un cluster peut être conforme CIS sur ce point tout en laissant le namespace default en profil privileged, ce qui autorise des conteneurs avec hostNetwork, hostPID ou des capabilities Linux étendues. Ce contrôle-là relève d'une revue namespace par namespace, hors du périmètre automatisable de kube-bench.
L'analyse d'images — vulnérabilités connues dans les couches de base, binaires setuid superflus, secrets embarqués dans les layers — est un axe totalement absent du benchmark CIS, qui audite la configuration du cluster, pas le contenu des workloads qui y tournent. Des outils comme Trivy ou Grype comblent ce manque en amont, idéalement dans le pipeline CI/CD avant push vers le registre.
La supply chain — provenance des images, signature avec Cosign, politique d'admission n'acceptant que des images signées — dépasse également le cadre CIS. Sur un cluster exposé publiquement ou traitant des données sensibles, cet axe mérite un chapitre d'audit à part entière.
Un score CIS élevé mesure la rigueur de la configuration du cluster, pas la sécurité globale de la plateforme. Complétez systématiquement l'audit kube-bench par un scan d'images et une revue des Pod Security Standards appliqués namespace par namespace.
Gérer les exceptions dans la durée
Certains FAIL ne seront jamais corrigés, pour des raisons légitimes : compatibilité avec un composant tiers non maintenu, contrainte d'un environnement de test qui ne justifie pas le même niveau de durcissement qu'en production, ou dépendance historique difficile à retirer sans risque de régression fonctionnelle.
Dans ce cas, la pire option est le silence — un FAIL qui réapparaît à chaque audit sans qu'aucune décision explicite n'ait été prise se noie dans le bruit et finit par masquer de vraies régressions. La bonne pratique consiste à consigner chaque exception dans un registre versionné avec le contrôle concerné, la justification métier, le porteur de la décision et une date de réexamen. Un exemple simple sous forme de tableau suivi en dépôt Git :
| Contrôle | Justification | Porteur | Réexamen |
|---|---|---|---|
| 4.2.6 read-only-port | Legacy monitoring dépendant du port 10255 | Équipe Plateforme | 2026-Q4, migration prévue |
| 1.2.16 audit-log-maxage | Rétention réduite pour environnement de dev | Équipe Dev | Revue annuelle |
Ce registre transforme une dérive tolérée en décision assumée et traçable, ce qui change la nature de la conversation lors d'un audit externe ou d'une revue de conformité : on ne découvre plus un écart, on retrouve une décision déjà documentée.
Pièges fréquents
- Confondre audit statique et détection d'intrusion. kube-bench ne détecte aucune activité malveillante en cours ; il vérifie une configuration à un instant T.
- Ignorer les profils spécifiques aux distributions managées, ce qui génère un bruit de FAIL non actionnables et décrédibilise l'outil auprès des équipes.
- Traiter les WARN comme des non-problèmes alors qu'ils couvrent souvent les contrôles RBAC les plus sensibles.
- Ne jamais rejouer l'audit après une mise à jour de version Kubernetes — chaque montée de version peut réintroduire des flags par défaut différents.
- Corriger sans tester — désactiver
--anonymous-authsans vérifier qu'aucun composant interne ne dépendait de cet accès peut casser des health checks ou des intégrations de monitoring legacy.
Checklist de mise en œuvre
- Identifier le profil kube-bench correspondant à la distribution (self-managed, EKS, GKE, AKS, OpenShift).
- Exécuter un premier scan complet et exporter le rapport brut.
- Trier les FAIL selon la matrice impact × exploitabilité.
- Traiter en priorité etcd, API server et kubelet.
- Revoir manuellement chaque WARN, en particulier les liaisons RBAC à privilèges élevés.
- Mettre en place un CronJob de re-scan avec alerte sur régression.
- Ajouter un contrôle équivalent en CI/CD sur les manifests avant fusion.
- Documenter les exceptions assumées avec leur justification, pour éviter qu'elles ne soient rouvertes sans discussion à chaque audit.
Le hardening n'est jamais définitivement acquis : c'est un processus qui accompagne le cycle de vie du cluster, au même titre que les mises à jour de sécurité ou la rotation des certificats.
L'essentiel à retenir
Ce chapitre présente le référentiel CIS Benchmarks pour Kubernetes et l'outil kube-bench qui permet de l'auditer automatiquement sur le control plane, les nœuds et etcd. Il détaille la lecture des résultats PASS/FAIL/WARN, la logique de priorisation des correctifs et les contrôles à traiter en premier : chiffrement d'etcd, restriction de l'API anonyme, permissions du kubelet et RBAC. Il propose enfin une méthode pour automatiser l'audit en continu via CI/CD ou CronJob, plutôt que de le traiter comme un contrôle ponctuel.
Questions fréquentes
kube-bench remplace-t-il un test d'intrusion sur le cluster Kubernetes ?
Faut-il viser 100 % de conformité CIS sur un cluster de production ?
Quelle différence entre kube-bench et des outils comme kubeaudit ou Polaris ?
Comment auditer etcd si l'accès aux fichiers de configuration est restreint par l'équipe infrastructure ?
Un FAIL sur un contrôle CIS signifie-t-il automatiquement une vulnérabilité exploitable ?
Est-il risqué de faire tourner le Job kube-bench directement sur un cluster de production ?
Comment prioriser quand plusieurs dizaines de contrôles échouent après un premier scan ?
Progression sauvegardée dans votre navigateur.
Quiz de validation
Quiz Player
Quiz de validation
Plusieurs réponses possibles — validez ensuite.
Vrai ou faux.
Quiz indisponible (données invalides).