





Network Policies
Comment verrouiller les flux réseau internes d'un cluster Kubernetes avec les NetworkPolicy : default deny, segmentation est-ouest, DNS et isolation multi-tenant.
Table des matières
Pourquoi ce chapitre est déterminant
Par défaut, un cluster Kubernetes ne segmente rien. N'importe quel pod peut ouvrir une connexion TCPTCPRéseauxProtocole de transport qui garantit que les données arrivent complètes, dans l'ordre et sans doublon. Il établit une connexion, numérote chaque segment et retransmet ce qui manque.Voir dans le glossaire vers n'importe quel autre pod, dans n'importe quel namespace, sans qu'aucune règle ne s'y oppose. Ce choix de conception n'est pas un oubli : Kubernetes a été pensé pour maximiser la connectivité par défaut et laisser l'opérateur restreindre ensuite ce dont il n'a pas besoin. Le problème, c'est que beaucoup de clusters restent dans cet état « tout ouvert » bien après leur mise en production.
Ce chapitre traite des NetworkPolicy, la ressource native qui permet de fermer ce réseau plat. L'objectif n'est pas de lister exhaustivement le champ des possibles de l'API, mais de construire une intuition opérationnelle : comment raisonner en default deny, comment segmenter le trafic entre services (est-ouest), comment ne pas casser la résolution DNSDNSRéseauxSystème qui traduit un nom de domaine en adresse IP, par interrogations successives de la racine, des serveurs de premier niveau puis des serveurs faisant autorité.Voir dans le glossaire en cours de route, et comment appliquer ces mécanismes à un cluster multi-tenant.
Une
NetworkPolicyne fait rien par elle-même. Elle est interprétée par le plugin CNI (Calico, Cilium, Antrea, etc.). Si votre CNI ne supporte pas les NetworkPolicy — c'est le cas dekubenetet de certaines installations minimales de Flannel — l'objet est accepté par l'API server, ne génère aucune erreur, et n'a strictement aucun effet. Vérifiez le support CNI avant de bâtir une stratégie de sécurité dessus.
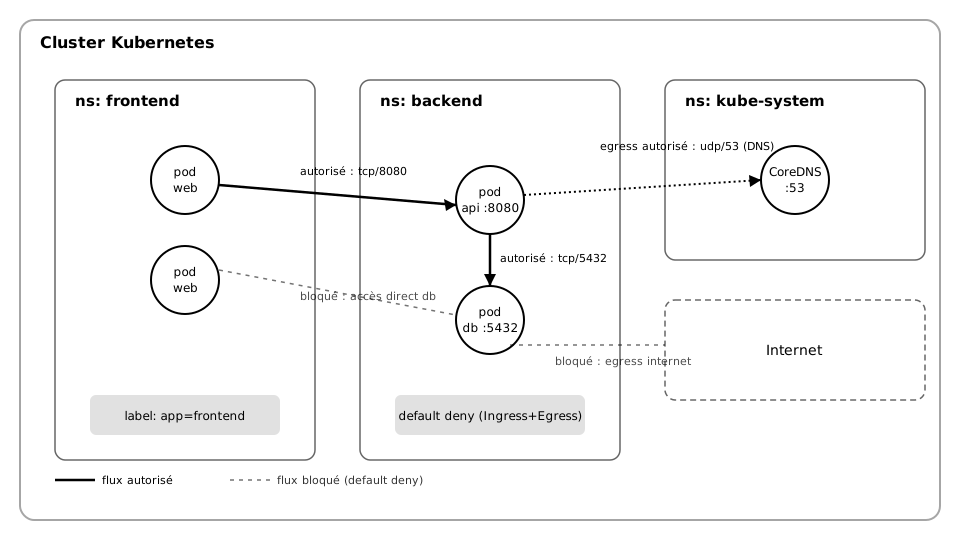
Anatomie d'une NetworkPolicy
Une NetworkPolicy cible un ensemble de pods via spec.podSelector, puis définit des règles ingress et/ou egress qui s'appliquent à ces pods. Trois éléments structurent chaque règle :
podSelector— sélectionne les pods cibles de la politique, dans le namespace où l'objet est créé.policyTypes— indique si la politique régit l'ingress, l'egress, ou les deux. Un piège classique : oublierEgressdanspolicyTypesalors qu'on définit une sectionegress, ce qui rend cette section inopérante.from/to— dans chaque règle, on combinepodSelector,namespaceSelectoretipBlockpour désigner les pairs autorisés.
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: api-allow-from-web
  namespace: backend
spec:
  podSelector:
    matchLabels:
      app: api
  policyTypes:
    - Ingress
  ingress:
    - from:
        - namespaceSelector:
            matchLabels:
              kubernetes.io/metadata.name: frontend
          podSelector:
            matchLabels:
              app: web
      ports:
        - protocol: TCP
          port: 8080
Cette politique autorise uniquement les pods app=web du namespace frontend à joindre les pods app=api du namespace backend, sur le portportRéseauxNuméro sur 16 bits qui désigne l'application destinataire sur une machine. Les ports 0 à 1023 sont réservés aux services système, comme 443 pour HTTPS.Voir dans le glossaire 8080. Notez la combinaison namespaceSelector + podSelector dans le même bloc from : les deux sélecteurs s'appliquent en ET logique. Si vous les placez dans deux entrées séparées de la liste from, ils s'appliquent en OU logique — une erreur de syntaxe fréquente qui élargit silencieusement l'accès.
Deux sélecteurs dans le même élément de liste = ET. Deux éléments différents dans la liste = OU. Cette nuance syntaxique change radicalement la portée de la règle et n'est signalée par aucun linter standard. Relisez toujours l'indentation YAML d'une politique avant de la déployer.
Default deny : la brique fondatrice
Avant d'écrire la moindre règle d'autorisation, il faut poser un default deny. Sans lui, chaque NetworkPolicy que vous ajoutez ne fait qu'autoriser du trafic supplémentaire sur un fond déjà ouvert : elle n'a donc aucun effet restrictif tant que rien ne bloque par défaut.
Le default deny s'obtient avec un podSelector vide, qui sélectionne tous les pods du namespace, et une liste de règles vide :
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: default-deny-all
  namespace: backend
spec:
  podSelector: {}
  policyTypes:
    - Ingress
    - Egress
Cette politique, appliquée seule, isole totalement le namespace backend : plus aucun trafic entrant ni sortant n'est autorisé, y compris le DNS. C'est un état intentionnellement strict, qui sert de socle. Toute politique d'autorisation ajoutée ensuite dans le même namespace vient s'additionner à ce socle, jamais le remplacer.
Les
NetworkPolicysont additives, jamais exclusives. Si deux politiques ciblent le même pod, l'ensemble des flux autorisés est l'union des deux. Il n'existe pas de notion de priorité ni de règle « deny » explicite dans l'API v1 standard — tout ce qui n'est pas explicitement autorisé reste bloqué dès qu'au moins une politique s'applique au pod pour la direction considérée (ingress ou egress).
Ce comportement additif a une conséquence pratique importante : vous pouvez déployer un default deny global par namespace, puis ajouter des politiques ciblées et granulaires sans jamais risquer de « retirer » une autorisation accordée ailleurs. C'est la stratégie recommandée pour tout cluster de production : un default deny par namespace, complété par des politiques nominatives par flux métier.
Trafic est-ouest : segmenter entre services
Le terme « est-ouest » désigne le trafic entre services à l'intérieur du cluster, par opposition au trafic « nord-sud » qui entre ou sort du cluster via un Ingress ou une sortie internet. C'est le trafic est-ouest qui pose le plus de risques en cas de compromission : un attaquant qui obtient l'exécution de code dans un pod frontend peu sensible cherchera ensuite à pivoter latéralement vers les pods qui détiennent des donnéesdonnéesIAEnsemble d'informations structurées ou non utilisées pour entraîner, évaluer ou alimenter un modèle. La qualité, la quantité et la représentativité des données sont les facteurs décisifs pour les performances en apprentissage automatique.Voir dans le glossaire (bases, caches, services de paiement).
La segmentationChunkingIADécoupage d'un document en segments de taille fixe ou sémantique avant indexation vectorielle, pour optimiser la récupération RAG.Voir dans le glossaire est-ouest consiste à n'autoriser que les chemins de communication réellement nécessaires entre composants. Concrètement, on modélise le graphe d'appels de l'application, puis on écrit une NetworkPolicy par couple (consommateur, fournisseur) plutôt qu'une politique large « tout le namespace peut parler à tout le namespace ».
Une architecture à trois niveaux —
web,api,db— ne devrait jamais autoriserwebà atteindredbdirectement. Seulapidoit avoir accès àdbsur le port 5432. Le schéma plus haut illustre exactement ce cas : le fluxweb → dbest représenté en pointillés bloqués, tandis queweb → apietapi → dbsont autorisés explicitement, chacun sur son port applicatif.
Cette discipline a un coût opérationnel réel : chaque nouveau flux applicatif nécessite une mise à jour de politique. C'est justement ce frein qui constitue la valeur de sécurité — il force à documenter et à valider chaque nouvelle dépendance réseau plutôt que de la laisser émerger implicitement.
Le piège du DNS
Le piège le plus courant lors de la mise en place d'un default deny egress, c'est de casser la résolution DNS. Kubernetes résout les noms de service via CoreDNS, hébergé dans kube-system, sur le port UDPUDPRéseauxProtocole de transport sans connexion ni garantie de livraison, réduit à un en-tête de 8 octets. Sa légèreté convient au DNS, à la voix et à la vidéo, où un retard coûte plus qu'une perte.Voir dans le glossaire/TCP 53. Si votre default deny bloque tout l'egress sans exception, les pods ne peuvent plus résoudre le moindre nom — y compris les noms de service internes — et l'application semble « tomber en panne réseau » alors que le problème est purement DNS.
Il faut donc systématiquement accompagner un default deny egress d'une règle d'autorisation explicite vers CoreDNS :
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: allow-dns-egress
  namespace: backend
spec:
  podSelector: {}
  policyTypes:
    - Egress
  egress:
    - to:
        - namespaceSelector:
            matchLabels:
              kubernetes.io/metadata.name: kube-system
      ports:
        - protocol: UDP
          port: 53
        - protocol: TCP
          port: 53
Testez toujours la résolution DNS immédiatement après l'application d'un default deny egress, avec un pod de diagnostic (
kubectl run -it --rm debug --image=busybox -- nslookup kubernetes.default). C'est le test le plus rapide pour détecter une règle DNS manquante avant que les symptômes ne se propagent en cascade sur toutes les applications du namespace.
Un autre piège lié au DNS : si CoreDNS tourne en mode hostNetwork ou si son IP change (upgrade, migration de nodegroup), une règle basée sur un ipBlock statique se casse silencieusement. Préférez toujours un namespaceSelector + podSelector sur les labels de CoreDNS plutôt qu'une adresse IPadresse IPRéseauxIdentifiant numérique attribué à une machine sur un réseau, qui permet de l'atteindre depuis n'importe où. Elle tient sur 32 bits en IPv4 et sur 128 bits en IPv6.Voir dans le glossaire figée.
Patterns multi-tenant
Dans un cluster partagé entre plusieurs équipes ou plusieurs clients, les NetworkPolicy servent de frontière d'isolation entre tenants, chaque tenant occupant généralement un ou plusieurs namespaces dédiés. Trois patterns reviennent régulièrement :
- Isolation stricte par namespace — chaque namespace applique un default deny ingress, avec une exception uniquement pour le trafic venant du même namespace (
podSelector: {}sansnamespaceSelector, ce qui restreint implicitement à l'espace de noms courant) et pour les composants d'infrastructure partagée (ingress controller, observabilité). - Namespace de plateforme partagé — un namespace
platform(ingress controller, service mesh, monitoring) a le droit d'atteindre tous les tenants, mais aucun tenant ne peut atteindre un autre tenant ni le namespaceplatformau-delà des ports de métriques exposés. - ÉtiquetageétiquetageIATravail consistant à associer à chaque exemple la réponse attendue. C'est presque toujours le poste le plus coûteux d'un projet d'apprentissage supervisé.Voir dans le glossaire systématique des namespaces — pour que les
namespaceSelectorfonctionnent de façon fiable, chaque namespace doit porter un label stable (tenant: acme, ou le label automatiquekubernetes.io/metadata.namedisponible depuis Kubernetes 1.21). Sans convention de labels appliquée à la création des namespaces, les politiques deviennent impossibles à maintenir à l'échelle.
| Pattern | Portée de l'isolation | Complexité opérationnelle |
|---|---|---|
| Default deny par namespace | Bloque tout, à l'unité du namespace | Faible à mettre en place, nécessite des exceptions DNS/plateforme |
| Isolation tenant-à-tenant | Empêche tout flux entre tenants, autorise l'intra-tenant | Moyenne, dépend du labellingannotationIAProcessus d'étiquetage manuel des données d'entraînement par des experts humains. La qualité de l'annotation conditionne directement les performances du modèle d'apprentissage supervisé.Voir dans le glossaire des namespaces |
| Politiques par flux applicatif | Granularité fine service-à-service | Élevée, mais donne la meilleure traçabilité des dépendances |
Les
NetworkPolicyne remplacent pas une isolation forte au niveau du kernel ou du nœud (namespaces Linux dédiés, nœuds dédiés,RuntimeClassgVisor/Kata). Dans un cluster multi-tenant à haute sensibilité, considérez-les comme une couche de défense en profondeur, pas comme la seule barrière entre tenants.
Pièges fréquents et checklist avant mise en production
Avant de déployer une stratégie de NetworkPolicy en production, vérifiez systématiquement les points suivants :
- Le CNI du cluster supporte-t-il effectivement les
NetworkPolicy? (kubectl get pods -n kube-systempour repérer Calico, Cilium, Antrea, Weave) - Chaque default deny egress est-il accompagné d'une règle d'autorisation DNS explicite ?
- Les sondes de liveness/readiness (
kubeletvers le pod) restent-elles fonctionnelles ? Les probes HTTP/TCP émises par le kubelet ne sont pas soumises auxNetworkPolicyd'ingress dans la plupart des implémentations, mais certains CNI en mode strict peuvent les filtrer — à vérifier sur votre plateforme précise. - Les namespaces portent-ils un label stable et prévisible avant que des politiques ne référencent leur
namespaceSelector? - Une politique
policyTypes: [Egress]sans sectionegressbloque-t-elle par erreur tout le trafic sortant au lieu de ne rien changer ? (une listeegressabsente avecpolicyTypes: [Egress]équivaut à un deny total, pas à une absence de restriction) - Les outilstool callingIACapacité d'un agent ou d'un LLM à invoquer des outils externes (API, calcul, recherche) pendant le raisonnement.Voir dans le glossaire d'observabilité et de scraping de métriques (Prometheus) ont-ils un chemin d'ingress autorisé explicitement vers chaque namespace applicatif ?
- Existe-t-il un pod de diagnostic reproductible pour tester rapidement un flux bloqué en cas d'incident ?
La bonne pratique consiste à dérouler cette checklist dans un environnement de pré-production strictement équivalent, avant tout déploiement en production, et à documenter chaque NetworkPolicy avec le flux métier qu'elle autorise — l'objet YAML seul ne raconte jamais pourquoi la règle existe.
Ce qu'il faut retenir
Les NetworkPolicy transforment un cluster Kubernetes d'un réseau plat en un ensemble de segments contrôlés, à condition d'être portées par un CNI compatible et pensées en deux temps : un default deny qui ferme tout, puis des autorisations nominatives qui rouvrent exactement ce qui est nécessaire. La difficulté n'est presque jamais dans la syntaxe de l'API, mais dans la rigueur de gouvernance qu'elle impose — labelling des namespaces, cartographie des flux réels, et discipline de test avant chaque déploiement en default deny.
L'essentiel à retenir
Ce chapitre explique pourquoi un cluster Kubernetes est ouvert par défaut et comment le fermer avec des NetworkPolicy. Il détaille la construction d'une politique default deny, la segmentation du trafic est-ouest entre services, la gestion souvent négligée du DNS, et les patterns d'isolation entre tenants dans un cluster partagé. Il se termine par une checklist des erreurs les plus courantes en production.
Questions fréquentes
Une NetworkPolicy peut-elle bloquer le trafic entre deux pods du même namespace ?
Faut-il une NetworkPolicy par pod ou peut-on cibler plusieurs pods à la fois ?
Les NetworkPolicy filtrent-elles le trafic au niveau IP ou au niveau applicatif (HTTP, gRPC) ?
Que se passe-t-il si aucune NetworkPolicy ne cible un pod donné ?
Peut-on autoriser du trafic depuis une plage d'adresses IP externes au cluster ?
Comment déboguer une NetworkPolicy qui bloque un flux de façon inattendue ?
Les NetworkPolicy s'appliquent-elles aussi au trafic vers des Service de type LoadBalancer ou NodePort ?
Progression sauvegardée dans votre navigateur.
Quiz de validation
Quiz Player
Quiz de validation
Plusieurs réponses possibles — validez ensuite.
Vrai ou faux.
Quiz indisponible (données invalides).