





Panorama de la vision moderne
Un état des lieux des tâches, des familles de modèles et des niveaux de maturité de la vision par ordinateur, pour cadrer les choix techniques du reste de la formation.
Table des matières
Pourquoi ce chapitre est le plus utile
La vision par ordinateur n'est pas une technologie unique : c'est une famille de tâches distinctes, résolues par des architectures différentes, avec des niveaux de fiabilité très inégaux selon le cas d'usage. Un système qui classe des radiographies avec 98 % d'exactitude et un système qui détecte des piétons en conditions de pluie nocturne n'appartiennent pas à la même catégorie de risque, même s'ils reposent sur des briques techniques voisines.
Ce chapitre pose le vocabulaire et les repères qui serviront dans toute la formation. Il ne s'agit pas de survoler des concepts pour le plaisir de l'exhaustivité : chaque distinction introduite ici a une conséquence directe sur la façon de spécifier un projet, de choisir un modèle, ou d'estimer un budget de donnéesdonnéesIAEnsemble d'informations structurées ou non utilisées pour entraîner, évaluer ou alimenter un modèle. La qualité, la quantité et la représentativité des données sont les facteurs décisifs pour les performances en apprentissage automatique.Voir dans le glossaire d'annotationannotationIAProcessus d'étiquetage manuel des données d'entraînement par des experts humains. La qualité de l'annotation conditionne directement les performances du modèle d'apprentissage supervisé.Voir dans le glossaire.
« Vision par ordinateur » désigne un ensemble de tâches aux exigences très différentes. Le choix de la tâche à résoudre — et non seulement du modèle — est la première décision d'architecture, et c'est souvent celle qu'on bâcle.
Les grandes familles de tâches
On regroupe généralement les tâches de vision en six familles, qui répondent chacune à une question différente posée à l'image.
Classification. La question posée est « qu'y a-t-il globalement dans cette image ? ». Le modèle renvoie une étiquetteétiquetageIATravail consistant à associer à chaque exemple la réponse attendue. C'est presque toujours le poste le plus coûteux d'un projet d'apprentissage supervisé.Voir dans le glossaire (ou une distribution de probabilités sur plusieurs étiquettes) pour l'image entière. C'est la tâche la plus ancienne et la mieux maîtrisée : tri de produits, contrôle qualité binaire (conforme / non conforme), reconnaissance d'espèces.
Détection d'objets. La question devient « où sont les objets, et lesquels ? ». Le modèle renvoie une liste de boîtes englobantes (bounding boxes) accompagnées d'une classe et d'un score de confiance. C'est la brique de base de la vidéosurveillance intelligente, du comptage, ou de la détection d'anomalies localisées.
SegmentationChunkingIADécoupage d'un document en segments de taille fixe ou sémantique avant indexation vectorielle, pour optimiser la récupération RAG.Voir dans le glossaire. Ici, on veut une réponse au pixel près. La segmentation sémantique attribue une classe à chaque pixel (« ceci est de la route, ceci est un trottoir »), sans distinguer les instances. La segmentation d'instances va plus loin et sépare chaque objet individuel, même quand ils se chevauchent — utile en imagerie médicale pour délimiter des lésions, ou en robotique pour isoler des objets à saisir.
OCR et compréhension de documents. La reconnaissance de caractères a longtemps été traitée comme une tâche à part, avec ses propres pipelines. Les modèles récents combinent détection de zones de texte, reconnaissance des caractères et compréhension de la mise en page (tableaux, formulaires, signatures) dans un seul système.
Estimation de pose et de profondeur. La pose humaine (position des articulations) sert au sport, à la rééducation, à l'interaction homme-machine. L'estimation de profondeur reconstruit une information 3D à partir d'une ou plusieurs images 2D — brique essentielle pour la navigation autonome et la réalité augmentée.
Génération et édition d'images. Famille plus récente en usage industriel : génération d'images de synthèse, inpainting (remplissage de zones manquantes), super-résolution. Ces modèles ne « comprennent » pas une image existante, ils en produisent une nouvelle — la distinction avec les cinq familles précédentes est fondamentale et sera creusée dans un chapitre dédié.
Un même projet combine souvent plusieurs de ces tâches en cascade : par exemple détecter un véhicule, puis segmenter sa plaque, puis appliquer de l'OCR sur la zone segmentée. Chaque étage introduit sa propre marge d'erreur, qui se cumule.
Anatomie d'un pipeline de vision
Quel que soit le cas d'usage, un système de vision en production suit une structure commune en cinq étapes.
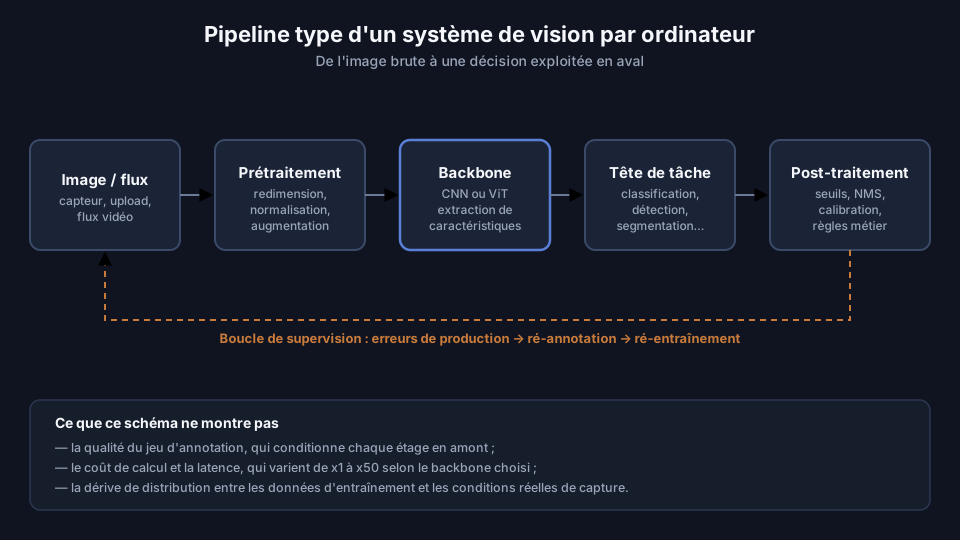
- Acquisition. L'image ou le flux vidéo brut, avec ses défauts propres : compression, bruit capteur, éclairage variable, angle de prise de vue non contrôlé.
- Prétraitement. Redimensionnement, normalisation des couleurs, parfois augmentation de données à l'entraînement (rotations, recadrages, variations d'exposition) pour rendre le modèle plus robuste aux conditions réelles.
- Backbone. Le réseau qui extrait des caractéristiques (features) de plus en plus abstraites à partir des pixels — c'est le cœur du modèle, souvent réutilisé d'une tâche à l'autre par transfert d'apprentissage.
- Tête de tâche. Une couche finale spécialisée qui transforme les caractéristiques extraites en sortie exploitable : classe, boîtes, masques, coordonnées.
- Post-traitement. Application de seuils de confiance, suppression des détections redondantes (non-maximum suppression), calibration des scores, et enfin croisement avec des règles métier avant toute décision.
Une part importante des erreurs perçues comme « erreurs du modèle » sont en réalité des erreurs de post-traitement : seuil de confiance mal calibré, règle métier absente, agrégation temporelle négligée sur un flux vidéo. Avant d'incriminer le modèle, vérifiez cette couche.
Des CNN aux Transformers
Les réseaux de neuronesréseau de neuronesIAFonction mathématique composée de neurones artificiels organisés en couches, dont les coefficients sont ajustés pendant l'entraînement. Malgré son nom, il n'a presque rien de commun avec un cerveau.Voir dans le glossaire convolutifs (CNNCNNIARéseau de neurones convolutif, architecture dominante en vision par ordinateur pour détecter des motifs locaux dans les images.Voir dans le glossaire) ont dominé la vision par ordinateur pendant une décennie. Leur principe : appliquer des filtres locaux qui se répètent sur toute l'image, ce qui leur donne une forte capacité à détecter des motifs indépendamment de leur position. Cette propriété, l'invariance par translation, en fait des architectures naturellement adaptées aux images, avec un besoin de données d'entraînement relativement modéré.
Les Vision TransformersTransformerIAArchitecture introduite en 2017, fondée sur le mécanisme d'attention, qui traite une séquence entière en parallèle. Elle sert de base à tous les grands modèles de langage actuels.Voir dans le glossaire (ViT), adaptation aux images du Transformer initialement conçu pour le texte, découpent l'image en patchs traités comme une séquence de tokenstokenIAFragment de texte manipulé par un modèle de langage, généralement plus court qu'un mot — trois à quatre caractères en français. La tarification et la limite de contexte se comptent en tokens.Voir dans le glossaire. Ils n'ont pas de biaisbiaisIARégularité correctement apprise dans des données qui ne représentent pas la réalité visée, ou qui enregistrent des décisions passées avec leurs préjugés. Changer d'algorithme ne le corrige pas.Voir dans le glossaire inductif spatial intégré comme les CNNréseau convolutifIAArchitecture conçue pour les images, qui fait glisser des filtres appris détectant des motifs locaux, puis les combine en motifs de plus en plus abstraits.Voir dans le glossaire : ils doivent apprendre eux-mêmes les relations spatiales à partir des données. Conséquence directe — ils ont besoin de volumes d'entraînement nettement supérieurs pour atteindre des performances comparables, mais ils captent mieux les dépendances à longue distance dans l'image (une texture dans un coin qui informe sur un objet à l'autre bout).
En pratique, le choix ne se fait presque jamais « CNN pur » contre « ViT pur ». Trois cas de figure dominent :
- Peu de données, contraintes de calcul fortes (edge, embarqué) → CNN léger (famille MobileNet, EfficientNet) ou architecture hybride.
- Beaucoup de données, ou modèle pré-entraîné disponible sur une tâche voisine → ViT ou hybride CNN-Transformer, avec fine-tuningFine-tuningIAAjustement des poids d'un modèle pré-entraîné sur un jeu de données spécifique pour adapter son comportement à un domaine ou une tâche cible.Voir dans le glossaire.
- Besoin de compréhension globale de scène (relations entre objets éloignés) → Transformer ou architecture à mécanisme d'attentionattentionIAMécanisme par lequel un modèle pondère l'importance de chaque token du contexte lorsqu'il en traite un autre, quelle que soit la distance qui les sépare.Voir dans le glossaire.
Ne partez jamais d'une architecture par réputation. Partez du triplet volume de données disponible / contrainte de latence-matériel / nature de la tâche, puis choisissez la famille qui correspond. Le meilleur modèle sur un benchmark public n'est pas nécessairement le meilleur choix pour votre contrainte d'inférenceinférenceIAUtilisation d'un modèle déjà entraîné sur une donnée nouvelle. Peu coûteuse à l'unité mais répétée à chaque requête, elle constitue le coût récurrent d'exploitation.Voir dans le glossaire en 40 ms sur un boîtier embarqué.
Maturité par tâche : ce qui est fiable, ce qui ne l'est pas
Toutes les tâches de vision n'ont pas atteint le même niveau de maturité industrielle. Un projet mal cadré consiste souvent à traiter une tâche encore expérimentale comme si elle était aussi fiable qu'une tâche éprouvée.
| Tâche | Maturité en production | Points de vigilance |
|---|---|---|
| Classification d'images (catégories bien définies) | Élevée | Sensible au déséquilibre des classes, aux catégories ambiguës |
| Détection d'objets courants | Élevée à moyenne | Objets petits, occultés ou hors distribution d'entraînement |
| OCR sur documents structurés | Élevée | Chute nette sur écritures manuscrites ou mise en page atypique |
| Segmentation sémantique | Moyenne | Coût d'annotation très élevé, frontières ambiguës |
| Segmentation d'instances en scène dense | Moyenne à faible | Chevauchements, occultations partielles |
| Estimation de pose | Moyenne | Vêtements amples, angles de caméra inhabituels |
| Estimation de profondeur monoculaire | Faible à moyenne | Erreurs d'échelle, surfaces réfléchissantes ou transparentes |
| Génération / édition d'image | Variable selon usage | Artefacts subtils, cohérence temporelle en vidéo |
Un service de tri postal automatisé combine classification (type de courrier), détection (localisation de l'adresse) et OCR (lecture du texte). Le maillon le plus faible est presque toujours l'OCR sur écriture manuscrite dégradée — pas la détection, plus mature. Un audit de fiabilité doit examiner chaque étage séparément plutôt que la sortie finale seule, sous peine de mal diagnostiquer l'origine des erreurs.
Image fixe ou flux vidéo : une distinction structurante
Traiter une image isolée et traiter un flux vidéo continu sont deux problèmes différents, même quand la tâche sous-jacente (détecter, segmenter) semble identique. Trois écarts méritent d'être anticipés dès le cadrage.
La dimension temporelle change la nature du signal. Sur une image fixe, une détection manquée est une erreur isolée. Sur un flux vidéo, la même détection peut être rattrapée à l'image suivante — à condition que le système exploite la cohérence temporelle (suivi d'objet, lissage des scores) plutôt que de traiter chaque image indépendamment. À l'inverse, une détection erronée qui se répète sur plusieurs images consécutives devient plus difficile à filtrer qu'une erreur ponctuelle.
Le budget de calcul se compte différemment. Un modèle qui met 200 ms à traiter une photo peut convenir à une application d'upload asynchrone. Le même modèle appliqué à un flux à 25 images par seconde doit tenir en moins de 40 ms par image pour rester en temps réel, sous peine d'accumuler un retard croissant. Ce facteur oriente souvent le choix d'un backbone plus léger, quitte à sacrifier un peu d'exactitude par image.
L'annotation vidéo introduit son propre coût. Annoter une vidéo image par image est rarement viable économiquement ; les outilstool callingIACapacité d'un agent ou d'un LLM à invoquer des outils externes (API, calcul, recherche) pendant le raisonnement.Voir dans le glossaire d'annotation vidéo interpolent les boîtes ou les masques entre des images clés annotées manuellement, ce qui introduit une marge d'erreur supplémentaire sur les images interpolées, en particulier lors de mouvements rapides.
Un projet qui bascule d'un prototype sur images fixes vers un déploiement sur flux vidéo change de nature technique, pas seulement d'échelle : il est prudent de le traiter comme un second projet à part entière, avec ses propres jalons de validation.
Pièges fréquents à ce stade de cadrage
Confondre performance sur benchmark et performance en production. Un modèle évalué à 95 % d'exactitude sur un jeu de testjeu de testIAPartie des données réservée à l'évaluation finale, à n'utiliser qu'une seule fois. Ajuster le modèle d'après ses résultats sur ce jeu lui ôte toute valeur de mesure indépendante.Voir dans le glossaire public peut chuter à 70 % sur des images réelles si les conditions de capture diffèrent (éclairage, angle, résolution, matériel).
Sous-estimer la dérivedériveIADégradation progressive des performances d'un modèle après son déploiement, causée par l'évolution des comportements ou du contexte. Elle impose surveillance et réentraînement.Voir dans le glossaire de distribution. Les données évoluent avec le temps : nouveaux produits en rayon, nouvelle génération de capteurs, saisonnalité. Un modèle figé sans boucle de supervision se dégrade silencieusement.
Ignorer le coût d'annotation. La segmentation d'instances peut coûter dix à vingt fois plus cher à annoter que la classification, pour un volume de données équivalent. Ce facteur doit entrer dans l'arbitrage entre tâches dès le cadrage, pas après le premier prototype.
Choisir une tâche plus fine que nécessaire. Si l'objectif métier est « y a-t-il un défaut sur cette pièce ? », une classification binaire suffit souvent. Basculer directement vers une segmentation pixel par pixel multiplie le coût sans bénéfice métier proportionnel.
Une exactitude globale élevée peut ainsi cacher une défaillance complète sur une sous-catégorie critique (objets rares, minorités dans les données, cas limites de sécurité) : mieux vaut toujours ventiler les métriques par sous-groupe avant de valider un déploiement.
Checklist de cadrage avant tout projet de vision
Avant de lancer un chantier de vision par ordinateur, il est utile de répondre par écrit aux questions suivantes :
- Quelle est la tâche exacte (classification, détection, segmentation, OCR, pose, profondeur, génération) et pourquoi celle-ci plutôt qu'une tâche plus simple ?
- Quel est le volume de données annotées disponible, et quel est le coût réaliste d'annotation supplémentaire ?
- Quelles sont les conditions de capture réelles (éclairage, angle, résolution, matériel), et diffèrent-elles de celles des données d'entraînement envisagées ?
- Quelle contrainte de latence et de matériel s'applique à l'inférence (cloud, edge, embarqué) ?
- Quel est le coût d'une erreur par type (faux positif, faux négatif) selon les sous-groupes concernés ?
- Existe-t-il une boucle de supervision prévue pour détecter la dérive de distribution après mise en production ?
Cette checklist sera reprise et détaillée dans les chapitres suivants de la formation, notamment ceux consacrés au choix d'architecture et à l'évaluation.
Ce qui suit dans la formation
Les chapitres suivants creusent chacune de ces briques : architectures de détection et de segmentation en détail, stratégies d'annotation et de gestion de jeux de données, métriques d'évaluation adaptées à chaque tâche, déploiement et supervision en production. Ce panorama sert de carte de référence à laquelle il sera utile de revenir à chaque nouvelle notion.
L'essentiel à retenir
Ce chapitre pose le vocabulaire commun de la vision par ordinateur appliquée : classification, détection, segmentation, OCR, estimation de pose et de profondeur, génération. Il détaille l'anatomie d'un pipeline (prétraitement, backbone, tête de tâche, post-traitement) et compare les familles de modèles CNN et Transformers. Il propose une grille de maturité par tâche pour distinguer ce qui est fiable en production de ce qui reste expérimental. Il se termine par une checklist de cadrage avant tout déploiement, réutilisée dans les chapitres suivants.
Questions fréquentes
Quelle tâche de vision par ordinateur choisir pour un contrôle qualité en usine ?
Faut-il toujours préférer un Vision Transformer à un CNN ?
Pourquoi mon modèle qui performe bien sur mon jeu de test échoue-t-il en production ?
Combien de temps faut-il pour annoter un jeu de données de segmentation ?
Qu'est-ce qui distingue le post-traitement du modèle lui-même ?
Comment savoir si une tâche de vision est assez mature pour être mise en production ?
Qu'est-ce qu'un backbone en vision par ordinateur ?
Progression sauvegardée dans votre navigateur.
Quiz de validation
Quiz Player
Quiz de validation
Plusieurs réponses possibles — validez ensuite.
Vrai ou faux.
Quiz indisponible (données invalides).