





Déploiement edge et cloud
Choisir entre inférence locale, cloud ou architecture hybride selon la latence, la connectivité et la confidentialité, puis réduire et opérer un modèle de vision en production.
Table des matières
Pourquoi ce chapitre est stratégique
Un modèle de vision par ordinateur qui affiche d'excellents scores en laboratoire peut s'avérer inutilisable en production si son déploiement n'a pas été pensé en amont. Latence excessive, modèle trop lourd pour le matériel cible, absence de supervision une fois en ligne : ce sont, en pratique, les causes les plus fréquentes d'échec des projets de vision par ordinateur — bien plus souvent que la qualité intrinsèque du modèle entraîné. Ce chapitre traite le déploiement comme un problème d'ingénierie à part entière, distinct de l'entraînement, avec ses propres arbitrages et ses propres modes de défaillance.
Trois décisions structurent tout projet de mise en production : où exécuter l'inférenceinférenceIAUtilisation d'un modèle déjà entraîné sur une donnée nouvelle. Peu coûteuse à l'unité mais répétée à chaque requête, elle constitue le coût récurrent d'exploitation.Voir dans le glossaire (edge, cloud, ou architecture hybride), comment réduire l'empreinte du modèle sans dégrader la précisionprécisionIAProportion des alertes émises par un modèle qui sont justifiées. Elle s'oppose au rappel : améliorer l'une dégrade l'autre.Voir dans le glossaire utile, et comment opérer le système une fois qu'il tourne en continu, sans supervision humaine permanente.
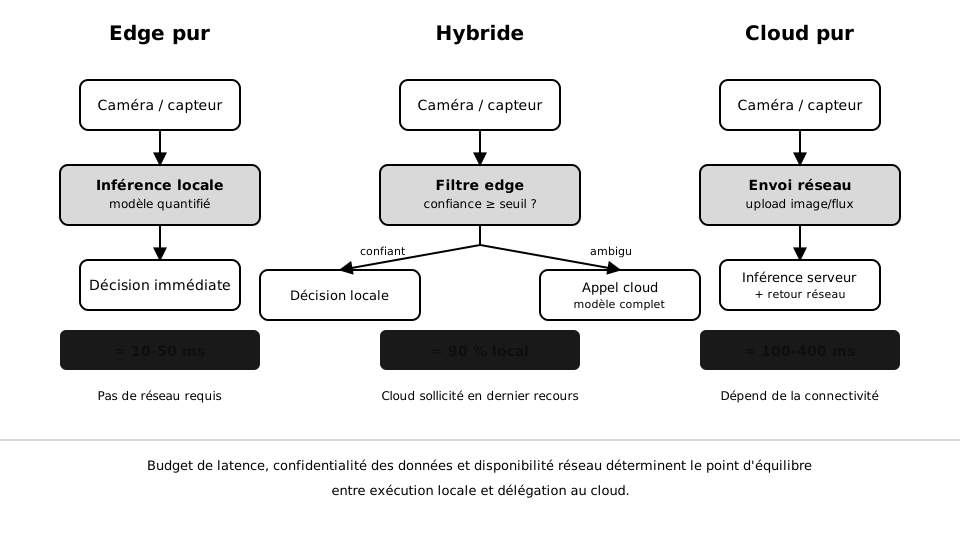
Edge, cloud ou hybride : poser le bon cadre
Le edge désigne l'exécution de l'inférence directement sur ou à proximité du capteur — caméra intelligente, carte embarquée (Jetson, Coral, module NPU), smartphone, poste industriel. Le cloud désigne l'exécution sur des serveurs distants, mutualisés, accessibles via une API réseau. L'hybride combine les deux : un modèle léger filtre localement les cas triviaux, un modèle plus lourd en cloud traite les cas ambigus ou sert de deuxième avis.
Le choix ne se résume pas à une question de budget. Quatre critères le déterminent réellement :
- Contrainte de latence — un système de freinage d'urgence ou de contrôle qualité sur ligne à cadence rapide tolère quelques dizaines de millisecondes, pas un aller-retour réseau.
- Connectivité disponible — un site industriel isolé, un véhicule en zone blanche ou un drone ne peuvent pas dépendre d'une liaison permanente et stable.
- Confidentialité des donnéesdonnéesIAEnsemble d'informations structurées ou non utilisées pour entraîner, évaluer ou alimenter un modèle. La qualité, la quantité et la représentativité des données sont les facteurs décisifs pour les performances en apprentissage automatique.Voir dans le glossaire — des flux vidéo de zones sensibles (santé, sites classifiés, espaces privés) posent des contraintes réglementaires qui découragent l'envoi systématique vers un tiers.
- Élasticité de la charge — un pic d'analyse ponctuel (traitement d'un lot d'archives, campagne d'annotationannotationIAProcessus d'étiquetage manuel des données d'entraînement par des experts humains. La qualité de l'annotation conditionne directement les performances du modèle d'apprentissage supervisé.Voir dans le glossaire assistée) se prête bien à une puissance de calcul cloud provisionnée à la demande, que l'edge ne peut pas offrir.
Ce ne sont pas deux façons équivalentes d'obtenir le même résultat à des coûts différents. Le edge impose des contraintes dures sur la taille et la complexité du modèle ; le cloud impose des contraintes dures sur la latence et la dépendance réseau. Concevoir l'architecture après avoir choisi le modèle, plutôt qu'avant, conduit presque toujours à devoir soit dégrader le modèle a posteriori, soit renoncer à la cible edge initialement prévue.
La latence : décomposer avant d'optimiser
Le mot « latence » recouvre en réalité plusieurs composantes distinctes, qu'il faut mesurer séparément avant de chercher à les réduire :
- Acquisition — temps de capture et de transfert du capteur vers la mémoire exploitable.
- Prétraitement — redimensionnement, normalisation, conversion de format.
- Inférence pure — temps de calcul du modèle sur le matériel cible.
- Post-traitement — décodage des sorties (NMS pour la détection, seuillage, agrégation temporelle).
- Transfert réseau, le cas échéant — aller-retour vers un service distant, avec sérialisation et files d'attente.
En edge, les postes 1 à 4 dominent et sont directement liés au choix du modèle et du matériel. En cloud, le poste 5 domine souvent largement les autres : un aller-retour réseau ajoute typiquement 50 à 300 millisecondes de latence incompressible, avant même de compter le temps d'inférence côté serveur, et cette latence varie avec la charge du réseau et du service — ce qui la rend difficile à garantir contractuellement sans marge confortable.
Un temps d'inférence de 8 ms mesuré isolément sur GPUGPUIAProcesseur graphique parallélisant massivement les calculs matriciels ; indispensable à l'entraînement et à l'inférence des modèles de deep learning.Voir dans le glossaire de développement ne présage en rien du temps de bout en bout observé sur le matériel de production. Le prétraitement, la copie mémoire CPU-GPU, la contention avec d'autres processus et le post-traitement peuvent multiplier ce chiffre par cinq ou dix. Toujours mesurer le pipeline complet, sur le matériel cible réel, sous charge représentative.
Un budget de latence se fixe en partant du besoin métier, pas du modèle. Si le système doit réagir en moins de 100 ms, ce budget se répartit ensuite entre les postes ci-dessus, ce qui contraint directement le choix d'architecture et de matériel — et non l'inverse.
Réduire la taille du modèle sans sacrifier ce qui compte
Un modèle destiné à l'edge doit généralement être réduit par rapport à sa version d'entraînement. Trois familles de techniques, souvent combinées, permettent cette réduction.
La quantization convertit les poids et parfois les activations d'une précision flottante (FP32) vers une précision réduite (FP16, INT8, voire INT4). Le gain est direct sur la taille mémoire et souvent sur la vitesse, car les accélérateurs matériels modernes traitent l'arithmétique entière ou demi-précision plus efficacement. Le coût est une perte de précision, généralement faible en quantization post-entraînement calibrée sur un jeu de données représentatif, mais qui peut devenir significative sur des tâches fines (petits objets, classes proches visuellement) si elle est appliquée sans calibration ni validation.
Le pruning (élagage) supprime les poids ou les canaux dont la contribution à la sortie est marginale. Le pruning structuré, qui retire des canaux ou des couches entières, produit un gain de vitesse réel et exploitable sur du matériel standard. Le pruning non structuré, qui met à zéro des poids individuels dispersés dans les tenseurs, réduit la taille du fichier mais n'accélère pas l'inférence sans matériel spécialisé capable d'exploiter la parcimonie — un piège fréquent chez les équipes qui pruinent sans vérifier le gain réel sur le matériel cible.
La distillation de connaissances entraîne un modèle « élève » compact à reproduire les sorties d'un modèle « enseignant » plus grand, souvent en utilisant les probabilités complètes (soft labels) plutôt que les seules étiquettes dures. Elle permet fréquemment d'obtenir un modèle élève nettement plus petit et plus rapide que l'enseignant, pour une perte de précision inférieure à ce qu'un entraînement direct sur les mêmes données aurait produit à taille égale.
Une équipe de contrôle qualité industriel entraîne un modèle de détection à haute précision (backbone lourd, entraînement cloud sur GPU). Elle distille ensuite ce modèle vers une architecture plus légère adaptée à l'edge, applique un pruning structuré pour retirer les canaux redondants identifiés par analyse de sensibilité, puis quantifie le résultat en INT8 avec calibration sur images de production. Le modèle final tourne à 45 images par seconde sur une carte embarquée, contre 6 pour le modèle enseignant sur le même matériel, avec une perte de précision mesurée inférieure à deux points.
| Technique | Gain principal | Risque associé | Où le vérifier |
|---|---|---|---|
| Quantization INT8 | Taille mémoire, vitesse | Perte de précision sur classes fines | Jeu de testjeu de testIAPartie des données réservée à l'évaluation finale, à n'utiliser qu'une seule fois. Ajuster le modèle d'après ses résultats sur ce jeu lui ôte toute valeur de mesure indépendante.Voir dans le glossaire représentatif post-conversion |
| Pruning structuré | Vitesse réelle | Gain nul si matériel non adapté | Benchmark sur matériel cible |
| Distillation | Compacité à précision élevée | Coût d'un entraînement enseignant + élève | Comparaison élève seul vs enseignant |
Formats et runtimes de déploiement
Le modèle entraîné dans un framework (PyTorch, TensorFlow) doit généralement être converti vers un format d'échange ou un runtime optimisé avant déploiement :
- ONNX — format d'échange interopérable entre frameworks, servant souvent d'étape intermédiaire.
- TensorRT (NVIDIA) — compile le graphe pour l'exécution optimisée sur GPU NVIDIA, avec fusion d'opérations et sélection de noyaux optimaux pour le matériel exact.
- TensorFlow Lite — ciblé mobile et embarqué, avec délégués matériels (GPU, NNAPI, Edge TPU).
- Core MLapprentissage automatiqueIABranche de l'IA où le programme dégage lui-même ses règles à partir d'exemples, au lieu de les recevoir d'un développeur. C'est ce déplacement des règles écrites vers les régularités apprises qui définit l'IA moderne.Voir dans le glossaire — écosystème Apple, avec accélération sur le Neural Engine des puces Apple Silicon.
- OpenVINO (Intel) — optimisation pour CPU et accélérateurs Intel.
Chaque conversion introduit un risque de divergence numérique par rapport au modèle source, en particulier lors de la quantization ou lorsque certaines opérations personnalisées ne sont pas supportées nativement par le runtime cible et doivent être réimplémentées. La validation post-conversion — comparaison des sorties sur un jeu de test fixe, avant et après conversion — n'est pas optionnelle.
Vérifier tôt que les couches et opérations utilisées sont supportées par le runtime cible évite des refontes d'architecture tardives. Une opération exotique, ajoutée en fin de projet pour gagner un point de précision, peut bloquer toute la chaîne de conversion vers TensorRT ou TFLite et forcer un réentraînement.
Architecture hybride : répartir la charge intelligemment
L'architecture hybride ne se limite pas à « edge pour la vitesse, cloud pour la précision ». Le schéma le plus courant utilise un modèle léger en edge comme filtre de confiance : les prédictions à forte confiance sont traitées localement et immédiatement, seules les prédictions ambiguës (score de confiance sous un seuil défini) sont envoyées au modèle plus lourd en cloud pour un second avis. Ce schéma réduit fortement le volume de trafic réseau et la charge du service cloud, tout en conservant une précision élevée sur les cas difficiles.
Un second schéma courant sépare inférence et apprentissage : l'inférence tourne en edge pour la réactivité, tandis que le cloud centralise la collecte des cas limites, le réentraînement périodique et la distribution des mises à jour de modèle vers la flotte d'appareils edge. C'est le schéma dominant pour les flottes de caméras ou de capteurs distribués à grande échelle.
Ops : ce qui se passe après la mise en production
Un modèle déployé n'est pas un livrable figé. Trois pratiques opérationnelles sont indispensables dès le premier déploiement, pas seulement à l'échelle.
Le versioning du modèle, du code de pré/post-traitement et des données de calibration doit permettre de reproduire exactement une version donnée du pipeline en production, et de revenir en arrière (rollback) en cas de régression détectée.
Le monitoring de dérivedériveIADégradation progressive des performances d'un modèle après son déploiement, causée par l'évolution des comportements ou du contexte. Elle impose surveillance et réentraînement.Voir dans le glossaire (drift) surveille l'évolution de la distribution des données réelles par rapport aux données d'entraînement — changement de luminosité saisonnier, nouveau modèle de caméra, nouvel environnement de déploiement — ainsi que l'évolution de la distribution des prédictions elles-mêmes. Une chute silencieuse de la confiance moyenne ou une hausse du taux de rejet vers le cloud dans une architecture hybride sont des signaux précoces de dérive, souvent détectables avant toute dégradation visible des indicateurs métier.
Le déploiement progressif (canary release, déploiement en anneaux) limite l'exposition d'une nouvelle version de modèle à un sous-ensemble de la flotte avant généralisation, avec des critères de bascule et de rollback définis à l'avance plutôt qu'improvisés en cas d'incident.
Un service applicatif classique se surveille surtout par ses erreurs et sa latence. Un modèle de vision peut rester parfaitement disponible et rapide tout en produisant des prédictions silencieusement erronées, sans qu'aucune exception ne soit levée. Le monitoring doit donc porter autant sur la qualité statistique des sorties (distribution des scores, taux de classes prédites) que sur la santé technique du service.
Coûts et arbitrages
Le coût d'une architecture cloud croît avec le volume d'inférences et reste largement variable, ce qui convient à une charge imprévisible ou saisonnière. Le coût d'une architecture edge se concentre en amont, dans l'achat et le déploiement du matériel embarqué sur chaque site ou appareil, avec un coût marginal par inférence proche de zéro une fois le matériel amorti — ce qui convient à une charge stable et élevée en volume, ou à des contraintes de connectivité qui rendent le cloud simplement impraticable, indépendamment du coût.
Un point souvent sous-estimé : le coût opérationnel du parc edge (mises à jour, supervision à distance, remplacement matériel, maintenance sur site) peut dépasser le coût direct du matériel lui-même sur la durée de vie du déploiement, en particulier pour des flottes géographiquement dispersées.
Sécurité et confidentialité en edge
Un appareil edge déployé sur le terrain est physiquement accessible, ce qui change le modèle de menace par rapport à un service cloud protégé par un périmètre réseau. Les poids du modèle embarqué peuvent être extraits par un attaquant ayant un accès physique, ce qui pose problème si le modèle constitue un actif propriétaire sensible. Le chiffrementchiffrementCybersécuritéTransformation d'une donnée lisible en une forme inintelligible à l'aide d'une clé. Le destinataire disposant de la clé peut retrouver le message original. C'est le socle de la confidentialité sur Internet.Voir dans le glossaire du modèle au repos, la signature des mises à jour distribuées et la limitation des interfaces de débogage exposées sont des mesures de base, pas des options avancées, dès lors que l'appareil quitte un environnement physiquement contrôlé.
Checklist avant mise en production
- Le budget de latence de bout en bout a été mesuré sur le matériel cible réel, pas sur un poste de développement.
- Le modèle converti (quantifié, pruné, distillé) a été validé sur un jeu de test représentatif, pas seulement comparé en taille et en vitesse.
- Le format et le runtime cibles ont été confirmés compatibles avec toutes les opérations du modèle avant le développement final.
- Un mécanisme de rollback vers la version précédente du modèle existe et a été testé, pas seulement documenté.
- Le monitoring de dérive statistique des prédictions est en place dès le premier jour de production, pas ajouté après un incident.
- Le modèle de menace pour le matériel edge déployé sur le terrain a été évalué si l'appareil est physiquement accessible à des tiers.
- Le coût opérationnel de maintenance de la flotte edge a été estimé sur la durée de vie prévue, pas seulement au moment de l'achat.
Ce qu'il faut retenir
Le déploiement n'est pas une étape administrative après l'entraînement : c'est une contrainte de conception qui doit peser sur les choix d'architecture dès le début du projet. Edge, cloud et hybride répondent à des besoins différents de latence, de connectivité, de confidentialité et de coût, et le bon choix découle du besoin métier, pas d'une préférence technologique par défaut. Une fois en production, un modèle de vision continue d'exiger une supervision active : sa dégradation est souvent silencieuse, et seul un monitoring conçu pour la détecter permet d'intervenir avant qu'elle n'affecte le métier.
L'essentiel à retenir
Ce chapitre traite le déploiement d'un modèle de vision par ordinateur comme un problème d'ingénierie distinct de l'entraînement, structuré autour de trois décisions : où exécuter l'inférence, comment réduire la taille du modèle, et comment opérer le système en continu. Il détaille les compromis entre edge, cloud et architecture hybride selon la latence, la connectivité et la confidentialité des données, ainsi que les techniques de compression (quantization, pruning, distillation) et les runtimes de déploiement courants. Il couvre également les pratiques opérationnelles indispensables après mise en production : versioning, monitoring de dérive, déploiement progressif et sécurité du matériel edge.
- Architecture edge, cloud et hybride
- Budget de latence de bout en bout
- Quantization, pruning et distillation
- Runtimes de déploiement (ONNX, TensorRT, TFLite, Core ML)
- Filtre de confiance en architecture hybride
- Monitoring de dérive (drift) en production
- Déploiement progressif et rollback
- Modèle de menace sur le matériel edge
Questions fréquentes
Faut-il toujours privilégier le edge pour réduire la latence ?
Quelle technique de compression de modèle donne le meilleur rapport gain/perte de précision ?
Comment savoir si mon modèle est prêt pour un déploiement edge sans le tester sur le matériel final ?
Combien de temps ajoute un aller-retour réseau vers le cloud pour l'inférence ?
Comment détecter une dérive de modèle sans attendre une baisse visible des indicateurs métier ?
Le format ONNX suffit-il pour déployer un modèle sur n'importe quel matériel ?
Quel est le principal poste de coût caché d'un déploiement edge à grande échelle ?
Progression sauvegardée dans votre navigateur.
Quiz de validation
Quiz Player
Quiz de validation
Plusieurs réponses possibles — validez ensuite.
Vrai ou faux.
Quiz indisponible (données invalides).