





Classification d'images
Construire un classifieur d'images performant en s'appuyant sur le transfer learning, et choisir les bonnes métriques pour juger sa qualité avant mise en production.
Table des matières
Pourquoi la classification d'images reste centrale
La classification d'images est la tâche la plus ancienne et la plus étudiée de la vision par ordinateur : associer à une image entière une étiquetteétiquetageIATravail consistant à associer à chaque exemple la réponse attendue. C'est presque toujours le poste le plus coûteux d'un projet d'apprentissage supervisé.Voir dans le glossaire parmi un ensemble fini de classes. Elle sert de brique de base à des usages très concrets — tri de pièces défectueuses en contrôle qualité, catégorisation automatique de photos produits pour un catalogue e-commerce, identification d'espèces sur des images de terrain, filtrage de contenus. Contrairement à la détection d'objets ou à la segmentationChunkingIADécoupage d'un document en segments de taille fixe ou sémantique avant indexation vectorielle, pour optimiser la récupération RAG.Voir dans le glossaire, elle ne localise rien : elle répond uniquement à la question « qu'est-ce que je vois, globalement, sur cette image ? ».
Cette simplicité apparente en fait un excellent point d'entrée pour comprendre des concepts qui se retrouvent ensuite partout ailleurs en vision par ordinateur, en particulier le transfer learningapprentissage par transfertIARéutilisation d'un modèle entraîné sur un grand corpus généraliste, dont on ne réentraîne que les dernières couches. Quelques centaines d'exemples suffisent alors souvent.Voir dans le glossaire et les métriques d'évaluation. C'est aussi une tâche où l'écart entre un prototype convaincant en démonstration et un système fiable en production est souvent sous-estimé.
Un classifieur qui atteint 95 % d'accuracy sur un jeu de testjeu de testIAPartie des données réservée à l'évaluation finale, à n'utiliser qu'une seule fois. Ajuster le modèle d'après ses résultats sur ce jeu lui ôte toute valeur de mesure indépendante.Voir dans le glossaire peut être inutilisable en production si les classes sont déséquilibrées ou si le jeu de test ne reflète pas la distribution réelle des donnéesdonnéesIAEnsemble d'informations structurées ou non utilisées pour entraîner, évaluer ou alimenter un modèle. La qualité, la quantité et la représentativité des données sont les facteurs décisifs pour les performances en apprentissage automatique.Voir dans le glossaire rencontrées après déploiement. L'accuracy seule ne suffit jamais à juger un modèle.
Le pipeline de classification supervisée
Un pipeline de classification supervisée suit toujours la même structure générale :
- Collecte et étiquetage — rassembler des images représentatives et leur associer une étiquette de classe, généralement de façon manuelle ou semi-automatisée.
- Prétraitement — redimensionnement, normalisation des pixels, éventuellement recadrage centré.
- Augmentation de données — transformations aléatoires (rotation, retournement, variation de luminosité, recadrage aléatoire) appliquées à l'entraînement pour simuler artificiellement plus de diversité.
- Extraction de features — un réseau convolutifCNNIARéseau de neurones convolutif, architecture dominante en vision par ordinateur pour détecter des motifs locaux dans les images.Voir dans le glossaire ou un transformeur visuel transforme l'image en un vecteur de caractéristiques.
- Classification — une couche dense finale, généralement suivie d'une fonction softmax, transforme ce vecteur en probabilités par classe.
- Évaluation — mesure de la performance sur un jeu de test indépendant, via des métriques adaptées au problème.
L'étape qui a le plus changé la pratique ces dernières années est la quatrième. Il y a une dizaine d'années, entraîner un extracteur de features performant nécessitait des millions d'images annotées et des semaines de calcul. Le transfer learning a rendu cette étape accessible à quiconque dispose de quelques centaines d'images par classe.
Transfer learning : principe et variantes
Le transfer learning repose sur une observation empirique robuste : les premières couches d'un réseau entraîné sur une grande base généraliste (comme ImageNet, 1,2 million d'images et 1000 classes) apprennent des représentations très génériques — contours, textures, motifs de couleur, formes simples. Ces représentations sont réutilisables telles quelles sur des tâches très différentes de la tâche d'origine. Seules les dernières couches, plus proches de la sortie, encodent des concepts spécifiques aux classes du jeu source.
Concrètement, on part d'un réseau déjà entraîné (le backbone), on retire sa tête de classification d'origine, et on la remplace par une nouvelle tête adaptée au nombre de classes de la tâche cible. Deux stratégies principales existent pour la suite de l'entraînement.
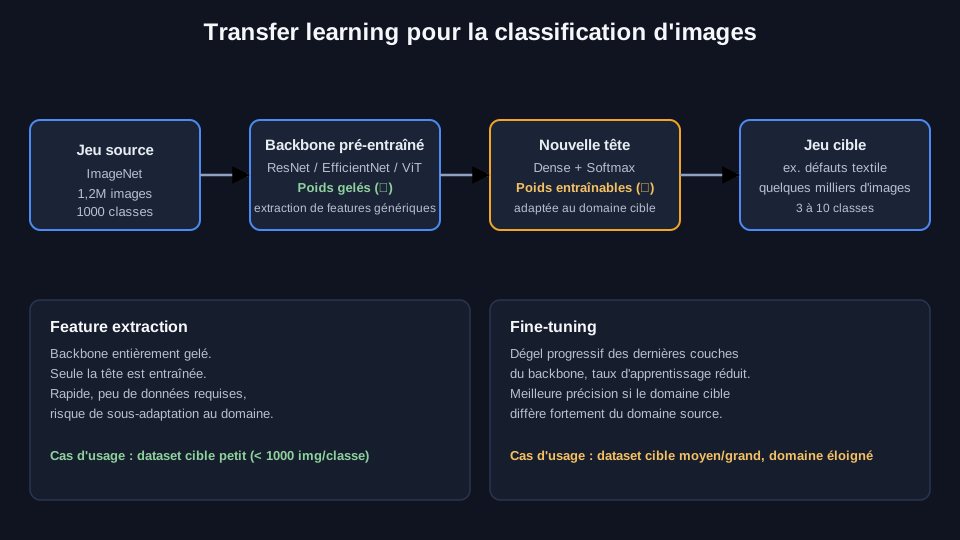
Feature extraction vs fine-tuning
Feature extraction consiste à geler entièrement les poids du backbone et à n'entraîner que la nouvelle tête. Le backbone agit comme un extracteur de descripteurs fixe. C'est rapide, peu gourmand en données et en calcul, et c'est la meilleure option quand le jeu cible est petit (quelques centaines d'images) ou proche du domaine source (des photos naturelles classiques, par exemple).
Fine-tuningFine-tuningIAAjustement des poids d'un modèle pré-entraîné sur un jeu de données spécifique pour adapter son comportement à un domaine ou une tâche cible.Voir dans le glossaire consiste à dégeler tout ou partie du backbone et à poursuivre son entraînement sur le jeu cible, généralement avec un taux d'apprentissage nettement plus faible que celui utilisé pour la tête (souvent 10 à 100 fois plus petit). Cette approche permet au réseau d'adapter ses représentations les plus spécifiques au nouveau domaine. Elle devient nécessaire quand le domaine cible s'éloigne fortement du domaine source — imagerie médicale, imagerie satellite, imagerie industrielle sous éclairage contrôlé — car les features génériques d'ImageNet ne captent pas toujours les indices discriminants pertinents dans ces contextes.
Une pratique courante et efficace consiste à combiner les deux approches en deux temps : entraîner d'abord uniquement la tête avec le backbone gelé jusqu'à convergence, puis dégeler progressivement les dernières couches du backbone avec un taux d'apprentissage réduit. Ce dégel progressif évite de détruire les représentations utiles apprises pendant le pré-entraînement, un phénomène connu sous le nom d'oubli catastrophique.
Un taux d'apprentissage trop élevé pendant le fine-tuningaffinageIAPoursuite de l'entraînement d'un modèle existant sur des données propres à un usage. Il enseigne une manière de répondre, non des connaissances fiables — d'où la préférence pour le RAG en entreprise.Voir dans le glossaire écrase rapidement les poids pré-entraînés et fait perdre le bénéfice du transfer learning — le modèle se comporte alors comme un entraînement from scratch, mais avec moins de données. Démarrer à un taux 10 à 100 fois inférieur à celui de l'entraînement initial de la tête est une règle de départ raisonnable.
Choisir une architecture de backbone
Le choix du backbone est un compromis entre précisionprécisionIAProportion des alertes émises par un modèle qui sont justifiées. Elle s'oppose au rappel : améliorer l'une dégrade l'autre.Voir dans le glossaire, taille du modèle et latence d'inférenceinférenceIAUtilisation d'un modèle déjà entraîné sur une donnée nouvelle. Peu coûteuse à l'unité mais répétée à chaque requête, elle constitue le coût récurrent d'exploitation.Voir dans le glossaire. Il n'existe pas de choix universellement optimal : le bon choix dépend des contraintes de déploiement.
| Famille | Points forts | Points de vigilance |
|---|---|---|
| ResNet (18 à 152) | Robuste, bien documenté, rapide à entraîner | Moins efficace en paramètres que les architectures récentes |
| EfficientNet | Excellent rapport précision/paramètres | Sensible aux hyperparamètreshyperparamètreIARéglage choisi avant l'entraînement — vitesse d'apprentissage, taille du modèle, nombre d'itérations. Il se distingue des paramètres, ajustés automatiquement pendant l'entraînement.Voir dans le glossaire de mise à l'échelle |
| Vision TransformerTransformerIAArchitecture introduite en 2017, fondée sur le mécanisme d'attention, qui traite une séquence entière en parallèle. Elle sert de base à tous les grands modèles de langage actuels.Voir dans le glossaire (ViT) | Très performant sur gros volumes de données | Nécessite davantage de données ou une augmentation forte pour bien généraliser sur petits jeux |
| MobileNet | Conçu pour l'embarqué et le temps réel | Précision en retrait sur tâches fines |
Pour un premier prototype avec un jeu de données de taille modeste, un ResNet-50 ou un EfficientNet-B0 en feature extraction constitue un point de départ fiable. Pour un déploiement mobile ou temps réel, MobileNet ou EfficientNet-Lite offrent un meilleur compromis latence/précision.
Préparer les données : augmentation et équilibrage
La qualité du jeu de données pèse souvent plus lourd que le choix de l'architecture. Deux problèmes reviennent systématiquement.
L'augmentation de données consiste à appliquer des transformations aléatoires aux images d'entraînement pour simuler une variabilité que le jeu réel ne couvre pas suffisamment : rotations légères, retournements horizontaux, variations de luminosité et de contraste, recadrages aléatoires, ajout de bruit. Elle réduit le risque de surapprentissagesurapprentissageIADéfaut d'un modèle qui mémorise ses exemples d'entraînement au lieu d'en dégager des régularités. Il excelle sur les données vues et échoue sur toute donnée nouvelle.Voir dans le glossaire, particulièrement utile quand les données sont limitées. Elle doit rester cohérente avec le domaine : retourner verticalement une image de texte ou de visage produit des exemples qui n'ont plus de sens métier.
Le déséquilibre de classes survient quand certaines classes sont largement sous-représentées par rapport à d'autres — cas fréquent en contrôle qualité, où les pièces défectueuses représentent une infime fraction des images collectées. Un modèle entraîné naïvement sur un jeu déséquilibré apprend à prédire systématiquement la classe majoritaire, ce qui maximise l'accuracy tout en étant inutile en pratique. Les remèdes courants incluent le sur-échantillonnage de la classe minoritaire, le sous-échantillonnage de la classe majoritaire, la pondération de la fonction de perte par classe, ou des techniques de génération synthétique comme SMOTE adaptées à l'image.
Pondérer la perte ou ré-échantillonner le jeu d'entraînement ne change rien à l'interprétation des métriques d'évaluation. Sur un jeu de test très déséquilibré, l'accuracy reste trompeuse même si le modèle a été entraîné correctement. C'est le choix des métriques de reporting, abordé ci-dessous, qui règle ce problème.
Mesurer la performance : métriques essentielles
Matrice de confusion
La matrice de confusion est le point de départ de toute évaluation sérieuse. Elle croise les classes prédites et les classes réelles, et révèle immédiatement les confusions systématiques entre classes proches — deux races de chiens visuellement similaires, deux types de défauts de surface qui se ressemblent. Une accuracy globale correcte peut masquer une confusion quasi totale entre deux classes spécifiques, invisible tant qu'on ne regarde pas la matrice en détail.
Précision, rappel, F1-score
Pour une classe donnée, quatre quantités structurent toutes les métriques dérivées :
- Vrais positifs (VP) — la classe est prédite et correcte.
- Faux positifs (FP) — la classe est prédite mais incorrecte.
- Faux négatifs (FN) — la classe n'est pas prédite alors qu'elle était correcte.
- Vrais négatifs (VN) — la classe n'est pas prédite et c'est correct.
La précision (VP / (VP + FP)) répond à la question : parmi les images classées comme appartenant à cette classe, combien le sont réellement ? Elle mesure la fiabilité des alertes positives.
Le rappelrappelIAProportion des cas positifs réels effectivement détectés par un modèle. Sur un jeu déséquilibré, c'est un indicateur bien plus parlant que l'exactitude globale.Voir dans le glossaire (VP / (VP + FN)) répond à la question : parmi les images qui appartiennent réellement à cette classe, combien ont été correctement détectées ? Il mesure la capacité à ne rien manquer.
Ces deux métriques s'opposent structurellement : augmenter le rappel (détecter plus de cas) se paie généralement en précision (plus de fausses alertes), et inversement. Le F1-score, moyenne harmonique de la précision et du rappel (2 × précision × rappel / (précision + rappel)), résume ce compromis en une seule valeur quand aucune des deux métriques n'est explicitement prioritaire.
Le choix entre privilégier précision ou rappel dépend entièrement du coût métier de chaque type d'erreur. Un contrôle qualité qui doit détecter des pièces défectueuses avant expédition privilégiera le rappel — laisser passer un défaut coûte plus cher qu'inspecter manuellement un faux positif. Un système de modération de contenu qui bloque automatiquement des publications privilégiera la précision — bloquer à tort un contenu légitime a un coût direct sur l'expérience utilisateur.
AUC-ROC et courbe precision-rappel
La courbe ROC trace le taux de vrais positifs contre le taux de faux positifs à mesure que le seuil de décision varie. L'aire sous cette courbe (AUC-ROC) résume la capacité du modèle à séparer les classes indépendamment du seuil choisi. Une AUC de 0,5 correspond à un modèle aussi bon qu'un tirage aléatoire ; une AUC de 1,0 correspond à une séparation parfaite.
Sur des jeux de données fortement déséquilibrés, l'AUC-ROC peut rester optiquement élevée alors que le modèle est peu utile sur la classe minoritaire, parce que le taux de faux positifs reste mécaniquement bas quand la classe négative est très majoritaire. Dans ce cas, la courbe precision-rappel, moins sensible au déséquilibre, donne une image plus honnête de la performance sur la classe rare.
Sur un jeu de 10 000 images dont 200 seulement montrent un défaut (2 %), un modèle qui prédit systématiquement « pas de défaut » atteint 98 % d'accuracy et une AUC-ROC de 0,50 apparemment médiocre mais pas alarmante au premier regard. La courbe precision-rappel, elle, s'effondre immédiatement et révèle un rappel nul sur la classe défaut — le seul indicateur qui compte réellement dans ce contextefenêtre de contexteIAQuantité de texte qu'un modèle peut prendre en compte simultanément : question, documents fournis et historique. Au-delà, les éléments les plus anciens sortent du champ.Voir dans le glossaire.
Pièges fréquents
Certaines erreurs reviennent avec une régularité suffisante pour justifier une vigilance systématique.
- Data leakagefuite de donnéesIAErreur consistant à laisser entrer dans l'entraînement une information qui n'existera pas au moment réel de la prédiction. Le modèle affiche des scores excellents puis s'effondre en production.Voir dans le glossaire entre entraînement et test — des images quasi identiques (même pièce photographiée sous plusieurs angles, doublons non détectés) réparties des deux côtés de la séparation train/test gonflent artificiellement les métriques. Le modèle mémorise plutôt qu'il ne généralise, et cette fuite passe souvent inaperçue tant que le split n'est pas vérifié explicitement.
- DérivedériveIADégradation progressive des performances d'un modèle après son déploiement, causée par l'évolution des comportements ou du contexte. Elle impose surveillance et réentraînement.Voir dans le glossaire de distribution (data drift) — le jeu d'entraînement provient d'un contexte (éclairage, capteur, angle de prise de vue) différent du contexte de production. Les performances mesurées en test ne se transfèrent pas.
- Overfitting masqué par la validation croisée — si le choix des hyperparamètres est lui-même optimisé sur le jeu de validation à travers de nombreuses itérations, ce jeu de validation cesse d'être vraiment indépendant. Un jeu de test final, jamais consulté pendant le développement, reste nécessaire.
- Métrique unique reportée sans contexte — publier une accuracy globale sans préciser la distribution des classes du jeu de test rend le chiffre ininterprétable pour quiconque doit en juger la pertinence opérationnelle.
Un jeu de test doit rester strictement isolé de toute décision de modélisation — pas de choix d'hyperparamètres, pas de sélection de checkpoint, pas d'ajustement de seuil basé dessus. Sa seule fonction est de produire une estimation finale non biaisée, consultée une seule fois.
Checklist avant mise en production
Avant de considérer un classifieur comme prêt pour un déploiement réel, il est utile de vérifier systématiquement :
- Le split entraînement/validation/test a été fait par entité (objet, individu, session) et non par image isolée, pour éviter le data leakage.
- La distribution des classes du jeu de test reflète la distribution réelle attendue en production, ou l'écart est explicitement documenté.
- Les métriques rapportées incluent au minimum la matrice de confusion, la précision et le rappel par classe — pas seulement une accuracy globale.
- Le seuil de décision a été choisi en fonction du coût métier réel des faux positifs et des faux négatifs, pas laissé à sa valeur par défaut de 0,5.
- Le modèle a été testé sur des images collectées dans des conditions proches de la production (même type de capteur, éclairage, résolution).
- Un plan de supervision post-déploiement existe pour détecter une dérive de performance dans le temps.
En résumé
Le transfer learning a rendu la classification d'images accessible sans nécessiter de gigantesques jeux de données propriétaires, à condition de choisir judicieusement entre feature extraction et fine-tuning selon la taille et la proximité du domaine cible. La partie la plus négligée du travail reste néanmoins l'évaluation : une accuracy élevée ne garantit rien sur un jeu déséquilibré, et seule une lecture combinée de la matrice de confusion, de la précision, du rappel et des courbes associées permet de juger si un modèle est réellement prêt pour la production.
L'essentiel à retenir
Ce chapitre explique comment construire un classifieur d'images en s'appuyant sur des réseaux pré-entraînés plutôt qu'en partant de zéro. Il détaille la différence entre feature extraction et fine-tuning, les critères de choix d'un backbone, et les techniques de préparation des données face au déséquilibre de classes. Une large partie est consacrée aux métriques d'évaluation — matrice de confusion, précision, rappel, F1-score, AUC-ROC — et aux erreurs d'interprétation qu'elles provoquent souvent. Le chapitre se termine par une checklist de mise en production destinée à éviter les pièges les plus coûteux : data leakage, accuracy trompeuse sur classes déséquilibrées, dérive de distribution entre entraînement et production.
Questions fréquentes
Combien d'images faut-il par classe pour entraîner un classifieur avec transfer learning ?
Faut-il toujours privilégier le fine-tuning plutôt que la feature extraction ?
Quelle métrique choisir si je dois n'en garder qu'une seule ?
Comment gérer un jeu de données avec des classes très déséquilibrées ?
Pourquoi mon modèle performe bien en test mais mal en production ?
Quelle architecture de backbone choisir pour un déploiement mobile ?
Le seuil de décision par défaut de 0,5 est-il toujours pertinent ?
Progression sauvegardée dans votre navigateur.
Quiz de validation
Quiz Player
Quiz de validation
Plusieurs réponses possibles — validez ensuite.
Vrai ou faux.
Quiz indisponible (données invalides).