





Vision multimodale (VLM)
Comprendre comment un modèle vision-langage relie image et texte dans un même espace de représentation, et savoir concevoir des prompts visuels qui exploitent réellement cette capacité sans se heurter à ses limites.
Table des matières
Pourquoi un modèle de langage peut-il « voir »
Un modèle de langagegrand modèle de langageIAModèle entraîné à prédire le token suivant d'une séquence de texte. Toutes ses capacités apparentes — résumer, traduire, coder — découlent de cette unique tâche.Voir dans le glossaire classique manipule des tokenstokenIAFragment de texte manipulé par un modèle de langage, généralement plus court qu'un mot — trois à quatre caractères en français. La tarification et la limite de contexte se comptent en tokens.Voir dans le glossaire de texte : des fragments de mots convertis en vecteurs, puis traités par un empilement de couches d'attentionattentionIAMécanisme par lequel un modèle pondère l'importance de chaque token du contexte lorsqu'il en traite un autre, quelle que soit la distance qui les sépare.Voir dans le glossaire. Un modèle vision-langage (VLM) applique le même principe à l'image, à condition de la transformerTransformerIAArchitecture introduite en 2017, fondée sur le mécanisme d'attention, qui traite une séquence entière en parallèle. Elle sert de base à tous les grands modèles de langage actuels.Voir dans le glossaire d'abord en quelque chose qui ressemble à des tokens.
La mécanique tient en trois étapes. D'abord, l'image est découpée en patches — des carrés de pixels de taille fixe, souvent 14 ou 16 pixels de côté, disposés en grille régulière sur toute la surface de l'image. Ensuite, un encodeur visuel, généralement un Vision Transformer (ViT), transforme chaque patch en un vecteur qui capture ce qu'il contient et sa relation avec les patches voisins. Enfin, une couche de projection linéaire convertit ces vecteurs visuels dans le même espace numérique que les tokens de texte, pour qu'ils puissent être mélangés dans une seule et même séquence, traitée par le transformeur du modèle de langage.
À partir de ce moment, le modèle ne distingue plus vraiment « image » et « texte » : il traite une suite de tokens, certains issus de patches, d'autres issus de mots, tous soumis au même mécanisme d'attention. C'est ce qui permet à un promptpromptIAConsigne ou contexte fourni à un modèle de langage pour orienter sa réponse. La qualité du prompt conditionne souvent la qualité du résultat.Voir dans le glossaire du type « décris la zone en haut à droite de cette image » de fonctionner : le mot « zone » et les tokens visuels correspondant à cette portion du visuel peuvent s'attirer mutuellement dans le calcul d'attention.
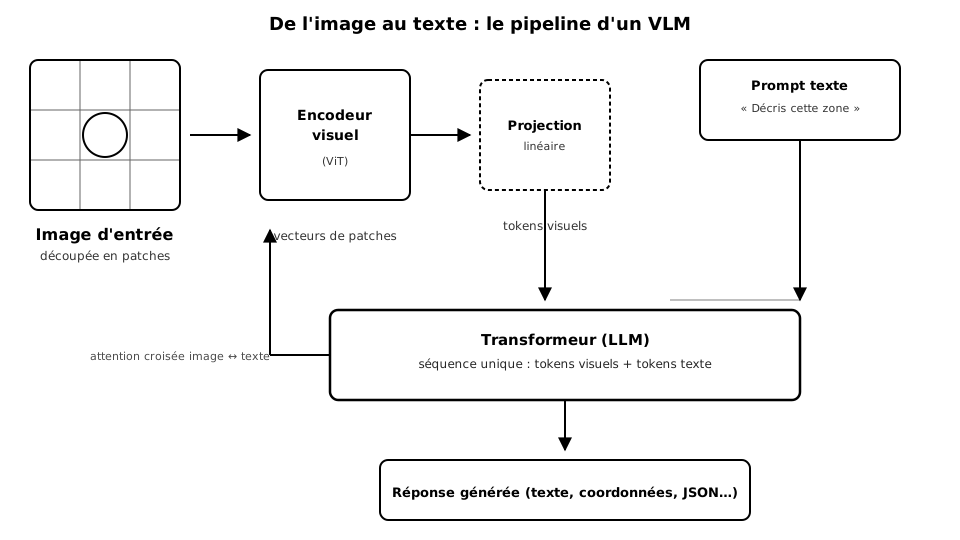
Un détecteur d'objets (vu au chapitre précédent) produit des boîtes et des classes issues d'un vocabulaire fermé, fixé à l'entraînement. Un VLM produit du texte libre, ouvert, capable de décrire n'importe quelle scène avec n'importe quel vocabulaire — au prix d'une garantie de justesse nettement plus faible.
Ce qu'un VLM sait faire concrètement
Une fois l'image convertie en tokens, les usages se répartissent en quelques familles bien identifiées.
Description libre. Demander un résumé du contenu visuel, avec un niveau de détail réglable par le prompt : « décris cette image en une phrase » donne un résultat très différent de « liste tous les objets visibles avec leur position approximative ».
Question-réponse visuelle (VQA). Poser une question précise sur le contenu : « combien de personnes portent un casque ? », « quelle est la couleur du panneau au fond ? ». Le modèle combine sa compréhension de l'image et du langage pour produire une réponse ciblée, sans description exhaustive préalable.
Extraction de texte et de structure (OCR sémantique). Contrairement à un OCR classique qui retourne du texte brut sans comprendre sa fonction, un VLM peut lire une facture et répondre directement « quel est le montant total TTC ? », en distinguant ce champ d'un sous-total ou d'une TVA affichée juste à côté.
Comparaison et détection de différences. Fournir deux images et demander ce qui a changé entre les deux — utile pour du contrôle qualité visuel ou du suivi de maquette.
Repérage approximatif (grounding). Demander la position d'un élément dans l'image, en langage naturel ou sous forme de coordonnées. Cette capacité existe mais reste la moins fiable de la liste, pour des raisons développées plus loin.
Raisonnement sur diagramme. Lire un graphique, un schéma d'architecture, une capture d'écran d'interface, et en tirer une explication ou une action — un usage en forte croissance pour l'automatisation d'interfaces.
Concevoir un prompt visuel efficace
La qualité d'une réponse dépend autant de la formulation du prompt que du modèle lui-même. Quelques règles se dégagent de la pratique.
Nommer précisément la tâche. « Que vois-tu ? » produit une description générique et souvent superficielle. « Liste les défauts visibles sur cette pièce mécanique, un par ligne, avec leur position sur un plan horaire (comme les aiguilles d'une montre) » cadre la réponse et réduit la marge d'interprétation.
Découper les tâches complexes. Un prompt qui demande simultanément de compter, de décrire les couleurs et de juger la qualité d'une image produit souvent une réponse qui néglige une des trois dimensions. Mieux vaut enchaîner plusieurs appels ciblés, ou demander une sortie structurée qui force le modèle à traiter chaque point.
Imposer un format de sortie. Demander une réponse en JSON avec des clés nommées ({"objet": ..., "position": ..., "confiance": ...}) réduit l'ambiguïté et facilite le traitement automatisé en aval. Le modèle reste plus discipliné quand la structure attendue est explicite.
Fournir un référentiel spatial. Le langage naturel décrit mal les positions (« un peu à gauche », « vers le centre »). Superposer une grille numérotée sur l'image avant de l'envoyer, ou demander des coordonnées normalisées entre 0 et 1, donne des réponses beaucoup plus exploitables qu'une description purement verbale.
Recadrer avant d'interroger. Si la zone d'intérêt est petite par rapport à l'image entière, un rognage (crop) préalable améliore nettement la fiabilité — voir la section suivante sur la résolution.
Plutôt que d'écrire « regarde en haut à droite », dessinez un rectangle ou une flèche directement sur l'image avant de l'envoyer, puis demandez « décris ce qui se trouve dans le rectangle rouge ». Cette forme de prompt visuel guide le modèle bien plus efficacement qu'une indication purement textuelle, car elle exploite l'attention croisée entre tokens visuels et texte sur un signal net et localisé.
Les limites structurelles à connaître
Certaines limites d'un VLM ne sont pas des bugs temporaires promis à disparaître avec la prochaine version : elles découlent directement de la façon dont l'image est encodée.
La résolution effective est limitée. Une image haute définition est redimensionnée avant d'être découpée en patches, souvent vers une résolution bien plus basse que l'original (parfois de l'ordre de 500 à 1000 pixels de côté selon le modèle). Un détail fin — un petit texte, une fissure millimétrique, une plaque d'immatriculation lointaine — peut tout simplement disparaître avant même d'atteindre l'encodeur visuel. Ce n'est pas un défaut de raisonnement du modèle : l'information n'existe plus dans les tokens qu'il reçoit.
Le comptage est peu fiable au-delà d'un petit nombre. Compter des objets suppose de traiter chaque instance individuellement et d'en garder la trace, ce qu'un mécanisme d'attention global fait mal au-delà d'une dizaine d'éléments, surtout s'ils se chevauchent. Un VLM interrogé sur « combien de personnes sur cette photo de foule » donnera un ordre de grandeur, pas un chiffre fiable.
Le repérage spatial précis est approximatif. Demander des coordonnées de boîte englobante à un VLM généraliste donne des résultats plausibles mais souvent décalés de plusieurs dizaines de pixels par rapport à la réalité, car le modèle n'a jamais été entraîné avec la même rigueur géométrique qu'un détecteur d'objets dédié (voir le chapitre sur la détection). Pour une tâche qui exige une localisation exacte — guidage robotique, contrôle qualité au pixel près — un détecteur spécialisé reste préférable.
L'hallucinationhallucinationIAProduction par un modèle d'un énoncé faux formulé avec la même assurance qu'un fait établi. Le phénomène est structurel : le modèle optimise la vraisemblance, pas la vérité.Voir dans le glossaire visuelle existe et prend une forme spécifique. Le modèle peut décrire un objet absent de l'image, parce que cet objet est statistiquement probable dans ce type de scène. Une cuisine génère souvent la mention d'un four alors qu'il n'y en a pas ; une rue urbaine peut « acquérir » un panneau de signalisation inventé. Ce biaisbiaisIARégularité correctement apprise dans des données qui ne représentent pas la réalité visée, ou qui enregistrent des décisions passées avec leurs préjugés. Changer d'algorithme ne le corrige pas.Voir dans le glossaire provient des associations apprises sur des millions d'images similaires, pas d'une observation réelle du pixel.
L'orientation et le miroir perturbent la lecture. Un texte à l'envers, une image tournée de 90 degrés ou inversée horizontalement dégradent fortement la qualité de l'OCR sémantique et de la description, alors qu'un humain s'adapte instantanément à ces variations.
Un VLM formule ses hallucinations visuelles avec la même fluidité que ses observations correctes. Aucun signal de confiance fiable n'accompagne spontanément la réponse : un ton assuré ne garantit rien sur l'exactitude du contenu.
Une entreprise automatise la lecture de compteurs électriques à partir de photos prises par des techniciens sur le terrain. Sur les premiers tests, le VLM lit correctement l'affichage dans 95 % des cas — mais les 5 % d'erreurs concernent presque toujours des photos prises en angle serré ou avec un reflet sur le cadran, cas où le modèle invente un chiffre plausible plutôt que de signaler une lecture impossible. La solution retenue combine un contrôle de qualité de la prise de vue en amont (angle, luminosité, netteté) et une double lecture automatique avec comparaison, plutôt qu'une confiance aveugle dans la première réponse.
Vérifier et fiabiliser une sortie de VLM
Puisque l'exactitude n'est jamais garantie, la fiabilisation passe par des mécanismes externes au modèle, pas par un réglage de prompt supplémentaire.
- Recouper avec une source structurée quand elle existe : un OCR classique en complément pour valider un montant extrait, une base de référence pour valider une correspondance produit.
- Demander une citation de preuve : forcer le modèle à indiquer la zone précise (coordonnées ou description) qui justifie sa réponse rend les hallucinations plus détectables, car une preuve inventée est souvent incohérente avec le reste de la réponse.
- Faire relire par un second appel indépendant : soumettre la même image et une reformulation de la question dans un appel séparé ; une réponse qui varie fortement d'un appel à l'autre signale une zone d'incertitude du modèle.
- Fixer des seuils de rejet : sur une tâche critique, prévoir explicitement une réponse « je ne sais pas » ou « qualité d'image insuffisante » plutôt que de forcer une réponse dans tous les cas — beaucoup d'erreurs proviennent d'un prompt qui, implicitement, interdit au modèle de refuser de répondre.
- Échantillonner un contrôle humain sur une proportion fixe des sorties en production, en particulier lors du déploiement initial, pour mesurer un taux d'erreur réel avant d'automatiser sans supervision.
| Tâche | Fiabilité typique | Vérification recommandée |
|---|---|---|
| Description générale de scène | Bonne | Relecture humaine ponctuelle |
| Extraction de champ structuré (facture, formulaire) | Bonne à très bonne si mise en page standard | Recoupement avec OCR classique |
| Comptage d'objets nombreux | Faible au-delà de 10-15 éléments | Détecteur spécialisé, pas de VLM seul |
| Localisation précise (coordonnées) | Faible à moyenne | Détecteur d'objets dédié |
| Lecture de texte manuscrit ou dégradé | Variable, dépend fortement de la qualité image | Double lecture + seuil de rejet |
| Comparaison de deux images | Moyenne à bonne sur différences franches | Vérification humaine sur écarts fins |
Pour toute tâche où la position exacte, le comptage exhaustif ou la mesure sont critiques, un détecteur ou un segmenteur entraîné spécifiquement reste plus fiable qu'un VLM généraliste. Le VLM excelle sur la compréhension contextuelle et la flexibilité du langage, pas sur la précisionprécisionIAProportion des alertes émises par un modèle qui sont justifiées. Elle s'oppose au rappel : améliorer l'une dégrade l'autre.Voir dans le glossaire géométrique.
Prompts visuels annotés : une technique à part
Au-delà du texte pur, une famille de techniques consiste à modifier l'image elle-même avant de l'envoyer, pour transmettre une intention au modèle sans dépendre uniquement du langage.
- Marquage par grille : superposer une grille avec des repères numérotés ou des coordonnées, pour obtenir des réponses de type « l'anomalie se trouve dans la case C4 » plutôt qu'une description spatiale approximative.
- Flèches et cercles : entourer ou pointer un élément pour lever toute ambiguïté sur l'objet visé quand la scène contient plusieurs candidats similaires.
- Zoom et recadrage successifs : sur une image haute résolution, interroger d'abord le modèle sur une version large pour identifier une zone d'intérêt, puis renvoyer un recadrage serré de cette zone pour obtenir un niveau de détail que la résolution effective du modèle aurait sinon supprimé.
- Superposition de deux images côte à côte : pour une comparaison, assembler les deux visuels dans une seule image avec une séparation nette, plutôt que d'envoyer deux fichiers distincts — cela réduit le risque que le modèle traite les deux scènes de façon indépendante sans les mettre réellement en relation.
Ces techniques demandent un prétraitement applicatif (dessiner sur l'image, découper, assembler) avant l'appel au modèle, mais elles compensent une bonne partie des limites de résolution et de repérage spatial évoquées plus haut, à un coût d'ingénierie raisonnable.
Checklist avant un déploiement en production
- La résolution des images source est-elle suffisante pour les détails que la tâche exige, une fois passée par le redimensionnement du modèle ?
- Le prompt impose-t-il un format de sortie structuré et exploitable automatiquement ?
- Une option de refus (« information non identifiable ») est-elle explicitement autorisée dans le prompt ?
- Existe-t-il une source de recoupement (OCR, base de donnéesdonnéesIAEnsemble d'informations structurées ou non utilisées pour entraîner, évaluer ou alimenter un modèle. La qualité, la quantité et la représentativité des données sont les facteurs décisifs pour les performances en apprentissage automatique.Voir dans le glossaire, second modèle) pour les champs critiques ?
- Le comptage ou le repérage précis, si nécessaire, passe-t-il par un modèle spécialisé plutôt que par le VLM seul ?
- Un échantillon de sorties est-il vérifié manuellement avant et après la mise en production ?
- Les cas d'image dégradée, mal orientée ou de mauvaise qualité sont-ils testés spécifiquement, et pas seulement les cas favorables ?
Cette liste ne garantit pas l'absence d'erreur — aucune ne le peut avec ce type de système — mais elle réduit la probabilité qu'une hallucination visuelle passe inaperçue jusqu'à un client ou une décision opérationnelle.
L'essentiel à retenir
Ce chapitre explique le fonctionnement interne d'un modèle vision-langage (VLM) : découpage de l'image en patches, encodage visuel, projection dans l'espace des tokens texte, puis traitement conjoint par un transformeur. Il détaille les usages concrets — description, extraction d'information, réponse à des questions visuelles, repérage d'éléments — et la manière de formuler des prompts visuels précis, avec ou sans annotations sur l'image. Il aborde aussi les limites structurelles de ces systèmes : hallucination visuelle, comptage peu fiable, faible précision spatiale, sensibilité à la résolution et à l'orientation. Le chapitre se termine par une méthode de vérification et une checklist pour fiabiliser un usage en production.
Questions fréquentes
Quelle différence entre un VLM et un modèle de détection d'objets ?
Pourquoi mon VLM invente-t-il des objets qui ne sont pas sur la photo ?
Comment améliorer la précision d'un VLM sur une petite zone d'une grande image ?
Peut-on faire confiance à un VLM pour compter des objets sur une image ?
Qu'est-ce qu'un prompt visuel, concrètement ?
Faut-il toujours vérifier manuellement les réponses d'un VLM en production ?
Un VLM peut-il lire du texte manuscrit ou une image floue de façon fiable ?
Progression sauvegardée dans votre navigateur.
Quiz de validation
Quiz Player
Quiz de validation
Plusieurs réponses possibles — validez ensuite.
Vrai ou faux.
Quiz indisponible (données invalides).