





Pipeline image de bout en bout
Construire un pipeline de données image reproductible : acquisition, prétraitement, augmentation, annotation et versioning, avant même de choisir un modèle.
Table des matières
Pourquoi le pipeline compte plus que le modèle
En vision par ordinateur, la qualité d'un modèle est plafonnée par la qualité du pipeline qui l'alimente. Un praticien qui change d'architecture sans avoir stabilisé son pipeline de donnéesdonnéesIAEnsemble d'informations structurées ou non utilisées pour entraîner, évaluer ou alimenter un modèle. La qualité, la quantité et la représentativité des données sont les facteurs décisifs pour les performances en apprentissage automatique.Voir dans le glossaire obtient des gains marginaux et difficiles à reproduire. À l'inverse, corriger une fuite de donnéesfuite de donnéesIAErreur consistant à laisser entrer dans l'entraînement une information qui n'existera pas au moment réel de la prédiction. Le modèle affiche des scores excellents puis s'effondre en production.Voir dans le glossaire, homogénéiser une annotationannotationIAProcessus d'étiquetage manuel des données d'entraînement par des experts humains. La qualité de l'annotation conditionne directement les performances du modèle d'apprentissage supervisé.Voir dans le glossaire ou fiabiliser l'acquisition produit souvent un gain de performance supérieur à celui d'un changement de modèle.
Ce chapitre découpe le pipeline en cinq étapes : acquisition, prétraitement, augmentation, annotationétiquetageIATravail consistant à associer à chaque exemple la réponse attendue. C'est presque toujours le poste le plus coûteux d'un projet d'apprentissage supervisé.Voir dans le glossaire, puis split et versioning. Chaque étape produit un artefact traçable — un fichier, un log, un hash — que l'étape suivante consomme. C'est cette traçabilité, plus que la sophistication de chaque brique, qui distingue un pipeline industrialisable d'un notebook de démonstration.
Un modèle entraîné sur un pipeline non reproductible est un modèle qu'on ne pourra ni auditer, ni corriger, ni faire évoluer sereinement. La reproductibilité du pipeline n'est pas une option de confort, c'est une condition de mise en production.
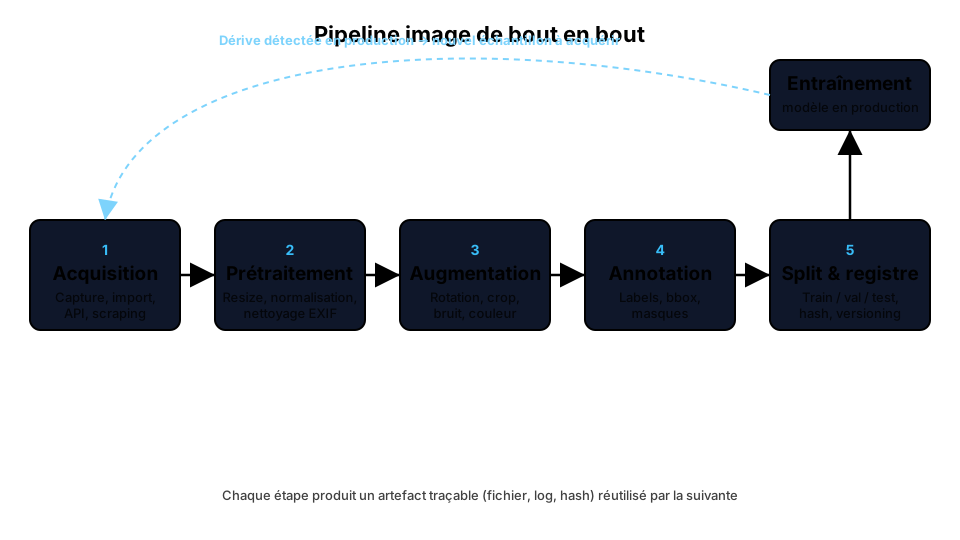
Étape 1 — Acquisition
L'acquisition détermine le plafond de performance atteignable : aucun prétraitement ni aucune architecture ne compense un jeu d'images non représentatif du contextefenêtre de contexteIAQuantité de texte qu'un modèle peut prendre en compte simultanément : question, documents fournis et historique. Au-delà, les éléments les plus anciens sortent du champ.Voir dans le glossaire de déploiement.
Trois sources dominent en pratique :
- Capture dédiée — caméras, capteurs industriels, drones. Offre le meilleur contrôle sur les conditions (angle, lumière, résolution) mais coûte cher à grande échelle.
- Import depuis des systèmes existants — DAM, ERP, applications métier. Rapide à mobiliser, mais souvent hétérogène en résolution, format et qualité.
- Scraping ou API tierces — utile pour amorcer un dataset, mais pose des questions de droit d'usage, de licence et de représentativité du domaine cible.
La question centrale à ce stade n'est pas « combien d'images ? » mais « ces images couvrent-elles la distribution réelle que le modèle rencontrera en production ? ». Un modèle de contrôle qualité entraîné uniquement sur des pièces photographiées en lumière de laboratoire échouera sur une ligne de production éclairée au néon industriel.
Un dataset de classification de défauts textiles constitué à 90 % de photos prises un jour ensoleillé donnait d'excellents résultats en validation interne, puis chutait de 15 points de précisionprécisionIAProportion des alertes émises par un modèle qui sont justifiées. Elle s'oppose au rappel : améliorer l'une dégrade l'autre.Voir dans le glossaire une fois déployé en usine, où l'éclairage artificiel changeait la teinte des tissus. Le problème n'était pas le modèle : c'était la distribution d'acquisition, jamais confrontée aux conditions réelles.
À documenter systématiquement dès l'acquisition : la source, la date, le matériel utilisé, la licence ou le consentement associé, et — pour des images contenant des personnes ou des données identifiables — la base légale de traitement au sens du RGPDRGPDConformitéRèglement européen sur la protection des données personnelles. Il s'applique dès qu'un système d'IA traite de telles données, et se cumule avec l'AI Act.Voir dans le glossaire. Cette documentation devient le premier maillon de la traçabilité du dataset.
Étape 2 — Prétraitement
Le prétraitement uniformise des images hétérogènes en entrées exploitables par un pipeline d'entraînement. Il se décompose en plusieurs opérations, pas toutes systématiques.
| Opération | Objectif | Piège fréquent |
|---|---|---|
| Redimensionnement | Uniformiser les dimensions attendues par le modèle | Déformer le ratio d'aspect au lieu de recadrer ou de remplir (padding) |
| Normalisation des pixels | Ramener les valeurs dans une plage stable (ex. [0,1] ou centrée-réduite) | Utiliser des statistiques (moyenne, écart-type) calculées sur un autre dataset que le sien |
| Correction colorimétrie | Harmoniser balance des blancs, contraste | Sur-corriger et effacer des signaux utiles (ex. légère décoloration = signe de défaut) |
| Nettoyage des métadonnées EXIF | Retirer GPS, identifiants d'appareil | Oublier de le faire avant publication ou partage du dataset |
| Débruitage | Réduire le bruit capteur sans lisser les détails utiles | Flouter des textures qui sont justement la variable d'intérêt |
| Déduplication | Éliminer quasi-doublons (rafales, recadrages) | Ne comparer que les hashs exacts, qui ratent les quasi-doublons |
Le choix du format de fichier n'est pas neutre non plus. Le JPEG applique une compression avec perte qui introduit des artefacts en bloc, gênants pour des tâches fines comme la détection de micro-fissures. Le PNG conserve l'information sans perte mais alourdit le stockage. Le TIFF ou les formats RAW conviennent aux contextes industriels ou médicaux où chaque pixel compte, au prix d'un pipeline de stockage et de transfert plus coûteux. Mélanger les formats au sein d'un même dataset sans homogénéisation en amont peut introduire un biaisbiaisIARégularité correctement apprise dans des données qui ne représentent pas la réalité visée, ou qui enregistrent des décisions passées avec leurs préjugés. Changer d'algorithme ne le corrige pas.Voir dans le glossaire que le modèle apprend malgré lui : si toutes les images « défectueuses » proviennent d'un lot exporté en JPEG fortement compressé et les images « conformes » d'un lot en PNG, le modèle risque d'apprendre à détecter la compression plutôt que le défaut.
Calculer la moyenne et l'écart-type de normalisation sur l'ensemble complet (train + validation + test) introduit une fuite d'information : le modèle est indirectement informé de statistiques issues de données qu'il ne devrait pas avoir vues. Ces statistiques doivent être calculées uniquement sur le sous-ensemble d'entraînement, puis appliquées telles quelles aux autres sous-ensembles.
Le nettoyage EXIF mérite une attentionattentionIAMécanisme par lequel un modèle pondère l'importance de chaque token du contexte lorsqu'il en traite un autre, quelle que soit la distance qui les sépare.Voir dans le glossaire particulière : les métadonnées d'un fichier image contiennent parfois des coordonnées GPS précises, l'identifiant du téléphone ayant pris la photo, voire l'heure exacte de capture. Ces informations doivent être supprimées avant tout partage ou publication du dataset, indépendamment de leur utilité pour l'entraînement.
Étape 3 — Augmentation
L'augmentation de données génère des variantes synthétiques d'une image existante — rotation, recadrage aléatoire, changement de luminosité, bruit gaussien, retournement horizontal — pour exposer le modèle à une variabilité plus large que celle du dataset brut. Elle réduit le surapprentissagesurapprentissageIADéfaut d'un modèle qui mémorise ses exemples d'entraînement au lieu d'en dégager des régularités. Il excelle sur les données vues et échoue sur toute donnée nouvelle.Voir dans le glossaire et améliore la robustesse, à condition de rester cohérente avec le domaine.
Quelques repères pratiques :
- Le retournement horizontal est pertinent pour de la reconnaissance d'objets génériques, mais faux sens pour de la lecture de texte ou de la détection de panneaux directionnels.
- La rotation à 180° a du sens pour de l'imagerie satellite, aucun pour de la reconnaissance faciale.
- L'augmentation colorimétrique doit rester dans une plage réaliste : une teinte trop éloignée du spectre observable en production entraîne le modèle sur un signal qu'il ne rencontrera jamais.
- L'augmentation ne doit jamais être appliquée à l'ensemble de test, qui doit rester représentatif des conditions réelles non manipulées.
Avant de lancer une augmentation à grande échelle, affichez visuellement un échantillon de 20 à 30 images augmentées. Un œil humain repère en quelques secondes des artefacts absurdes (texte retourné, couleurs impossibles) qu'un pipeline automatisé laisserait filer silencieusement dans des milliers d'images.
Étape 4 — Annotation et labels
L'annotation transforme une image brute en exemple exploitable par un algorithme superviséapprentissage superviséIAMéthode où chaque exemple d'entraînement est accompagné de la réponse attendue. C'est la famille la plus employée en entreprise, mais elle exige des données étiquetées — souvent le poste de coût principal.Voir dans le glossaire. Le type de tâche détermine le type de label :
- Classification — un label global par image (« défectueux » / « conforme »).
- Détection d'objets — des boîtes englobantes (bounding boxes) avec une classe par boîte.
- SegmentationChunkingIADécoupage d'un document en segments de taille fixe ou sémantique avant indexation vectorielle, pour optimiser la récupération RAG.Voir dans le glossaire sémantique — un label par pixel, regroupant les pixels d'une même classe.
- Segmentation d'instances — comme la segmentation sémantique, mais en distinguant chaque occurrence individuelle d'un objet.
Des outilstool callingIACapacité d'un agent ou d'un LLM à invoquer des outils externes (API, calcul, recherche) pendant le raisonnement.Voir dans le glossaire comme CVAT, Label Studio ou Labelbox structurent ce travail, mais l'outil ne remplace pas un guide d'annotation écrit. Ce guide doit trancher les cas ambigus à l'avance : où passe la frontière entre une rayure « mineure » et une rayure « majeure » ? Un objet partiellement masqué doit-il être annoté malgré tout ? Sans réponse écrite à ces questions, deux annotateurs traiteront le même cas différemment, et le bruit d'étiquetage qui en résulte plafonnera la performance du modèle bien avant que l'architecture ne devienne le facteur limitant.
L'accord inter-annotateur (par exemple via le coefficient kappa de Cohen pour de la classification, ou l'IoU moyen pour des boîtes englobantes) est la métrique de référence pour objectiver la cohérence d'un jeu annoté. Un accord inter-annotateur faible signale un guide d'annotation à réviser avant de poursuivre l'étiquetage, pas après le rendu du lot complet.
Le désaccord porte le plus souvent sur les cas limites, pas sur les cas évidents : c'est précisément pour cela qu'un guide d'annotation doit être écrit à partir d'exemples ambigus réels tirés du dataset, plutôt que rédigé abstraitement avant toute observation des données. Un guide rédigé en salle de réunion, sans confrontation aux images du projet, laisse systématiquement de côté les cas qui posent effectivement problème sur le terrain.
En pratique, un cycle d'annotation robuste suit ces phases : rédaction du guide, annotation d'un petit lot pilote par plusieurs annotateurs, mesure de l'accord, révision du guide si nécessaire, puis annotation en volume avec un échantillon régulièrement re-vérifié par un référent qualité. Ce cycle coûte du temps en amont, mais il évite de découvrir, après plusieurs milliers d'images annotées, que deux annotateurs ont interprété différemment la consignepromptIAConsigne ou contexte fourni à un modèle de langage pour orienter sa réponse. La qualité du prompt conditionne souvent la qualité du résultat.Voir dans le glossaire sur les objets partiellement masqués — un écart qui obligerait à tout reprendre.
La sous-traitance de l'annotation à un prestataire externe ne dispense pas de ce travail : le guide doit être transmis avant le début de la prestation, un lot pilote doit être validé conjointement, et un échantillon de contrôle qualité doit être revu régulièrement pendant toute la durée du contrat, pas seulement à la livraison finale.
Étape 5 — Split et versioning
Le découpage du dataset en ensembles d'entraînement, de validation et de test conditionne la fiabilité de toute mesure de performance ultérieure. Les répartitions usuelles tournent autour de 70/15/15 ou 80/10/10, mais le ratio compte moins que l'absence de contamination entre ensembles.
La fuite de données (data leakage) la plus fréquente en vision par ordinateur : plusieurs photos d'un même objet, prises sous des angles différents dans une même série, se retrouvent réparties entre train et test. Le modèle reconnaît alors l'objet spécifique plutôt que d'apprendre la caractéristique visuelle générale — la métrique de validation devient trompeusement élevée, sans rapport avec la performance réelle en production.
Un modèle victime de fuite de données affiche souvent une excellente précision de validation. C'est justement ce qui la rend dangereuse : rien dans les chiffres n'alerte, seule une vérification de la constitution des splits — par source, par session de capture, par identifiant d'objet — permet de la détecter avant le déploiement.
Une fois les splits fixés, chaque version du dataset doit être versionnée : hash de chaque fichier, date de constitution, liste des transformations appliquées, statistiques descriptives (nombre d'images par classe, résolution moyenne). Des outils comme DVC ou un simple registre structuré (fichier manifeste + stockage objet) suffisent pour la plupart des projets. L'objectif : pouvoir répondre avec certitude à la question « quel dataset exact a produit ce modèle ? », y compris plusieurs mois après l'entraînement.
Pièges fréquents
- Biais d'acquisition non documenté — dataset collecté dans des conditions qui ne représentent pas la production.
- Fuite de données entre splits — images liées (même objet, même session) réparties des deux côtés.
- Normalisation calculée sur l'ensemble complet au lieu du seul ensemble d'entraînement.
- Guide d'annotation absent ou tacite, transmis oralement et jamais mesuré.
- Métadonnées sensibles non nettoyées avant partage ou publication du dataset.
- Absence de versioning, rendant impossible la reproduction d'un résultat après une modification du pipeline.
- Augmentation appliquée à l'ensemble de test, faussant l'évaluation finale.
Checklist opérationnelle
- La source, la date et la licence de chaque lot d'images sont documentées.
- Les statistiques de normalisation sont calculées uniquement sur l'ensemble d'entraînement.
- Les métadonnées EXIF sensibles sont supprimées avant tout partage.
- Les transformations d'augmentation sont cohérentes avec le domaine métier (pas de retournement sur du texte, par exemple).
- Un guide d'annotation écrit existe et un accord inter-annotateur a été mesuré sur un lot pilote.
- Les splits train/val/test sont constitués par source ou par objet, jamais par tirage aléatoire pur sur des images liées.
- Chaque version du dataset est hashée et accompagnée d'un manifeste listant les transformations appliquées.
- Un échantillon du dataset final est revu visuellement avant le lancement de l'entraînement.
Un pipeline qui coche ces huit points n'élimine pas tout risque de dérivedériveIADégradation progressive des performances d'un modèle après son déploiement, causée par l'évolution des comportements ou du contexte. Elle impose surveillance et réentraînement.Voir dans le glossaire, mais il élimine les causes d'échec les plus fréquentes et les plus coûteuses à diagnostiquer après coup — celles qui se manifestent des semaines après la mise en production, quand le modèle a déjà été jugé fiable sur la base de métriques faussées.
L'essentiel à retenir
Ce chapitre détaille les cinq étapes d'un pipeline image professionnel : acquisition des sources, prétraitement (redimensionnement, normalisation, nettoyage), augmentation, annotation et split/versioning du dataset. Il insiste sur les points de rupture les plus fréquents en production : fuite de données entre les ensembles d'entraînement et de test, biais d'acquisition, incohérence des guides d'annotation et absence de traçabilité. Des exemples concrets, un tableau comparatif des techniques de prétraitement et une checklist opérationnelle permettent de fiabiliser chaque étape avant l'entraînement d'un modèle de vision.
Questions fréquentes
Faut-il toujours viser un split 70/15/15 pour train/val/test ?
Combien d'images faut-il pour démarrer un projet de vision par ordinateur ?
Dois-je appliquer l'augmentation de données sur l'ensemble de test ?
Quel outil choisir pour l'annotation d'images ?
Comment détecter une fuite de données dans un dataset déjà constitué ?
Le nettoyage des métadonnées EXIF est-il vraiment nécessaire si le dataset reste interne ?
Peut-on réutiliser un dataset annoté pour une tâche différente de celle prévue initialement ?
Progression sauvegardée dans votre navigateur.
Quiz de validation
Quiz Player
Quiz de validation
Plusieurs réponses possibles — validez ensuite.
Vrai ou faux.
Quiz indisponible (données invalides).