





Obligations des systèmes à haut risque
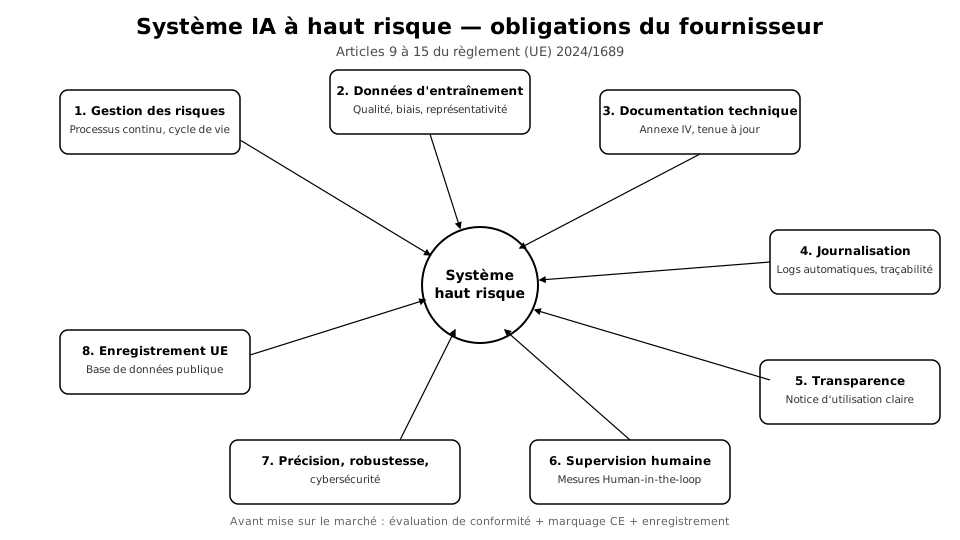
Le détail des huit obligations imposées par l'AI Act aux fournisseurs de systèmes IA à haut risque : gestion des risques, données, documentation, journalisation, transparence, supervision humaine, précision et robustesse.
Table des matières
Pourquoi ce chapitre est le plus dense de la formation
Les chapitres précédents ont établi la classification : un système entre dans la catégorie « haut risquehaut risqueConformitéCatégorie de l'AI Act regroupant les usages soumis à conditions strictes : recrutement, crédit, éducation, infrastructures critiques. Elle impose documentation, examen des biais et contrôle humain effectif.Voir dans le glossaire » soit parce qu'il figure à l'Annexe I (produit couvert par une législation d'harmonisation), soit parce qu'il relève d'un des huit domaines listés à l'Annexe III — recrutement, notation de crédit, éducation, justice, gestion des frontières, etc. Une fois cette classification posée, une question opérationnelle se pose immédiatement : que doit concrètement livrer une équipe produit pour pouvoir commercialiser ce système en Europe ?
La réponse tient dans les articles 9 à 15 du règlement. Ce ne sont pas des principes généraux mais des obligations documentaires et techniques précises, assorties d'annexes détaillées. Les sous-estimer expose à des sanctions administratives pouvant atteindre 15 millions d'euros ou 3 % du chiffre d'affaires mondial — un niveau comparable au RGPDRGPDConformitéRèglement européen sur la protection des données personnelles. Il s'applique dès qu'un système d'IA traite de telles données, et se cumule avec l'AI Act.Voir dans le glossaire, mais avec un périmètre technique plus large puisqu'il touche à la conception même du système, pas seulement au traitement des donnéesdonnéesIAEnsemble d'informations structurées ou non utilisées pour entraîner, évaluer ou alimenter un modèle. La qualité, la quantité et la représentativité des données sont les facteurs décisifs pour les performances en apprentissage automatique.Voir dans le glossaire personnelles.
Ces obligations pèsent en premier lieu sur le fournisseur (provider) — l'entité qui développe le système ou le fait développer sous sa marque. L'opérateur déployeur (deployer) — l'entreprise qui utilise le système dans son activité — hérite d'obligations plus légères mais réelles, notamment en matière de supervision humaine et de tenue des logs. Un cabinet RH qui achète un outil de tri de CV n'est pas fournisseur, mais reste responsable de son usage.
Le système de gestion des risques (Article 9)
Ce n'est pas un document ponctuel produit avant la mise sur le marché, mais un processus itératif qui court sur tout le cycle de vie du système : conception, entraînement, validation, déploiement, surveillance post-commercialisation. Le règlement exige quatre étapes récurrentes :
- Identification des risques connus et raisonnablement prévisibles pour la santé, la sécurité et les droits fondamentaux.
- Estimation et évaluation de ces risques dans des conditions d'usage prévisibles, y compris le mésusage raisonnablement prévisible.
- Adoption de mesures de gestion appropriées — conception, information, formation.
- Tests dans des conditions représentatives de l'usage réel, avec des métriques prédéfinies et des seuils d'acceptabilité.
Un système de tri de CV entraîné majoritairement sur des profils issus d'un même bassin d'emploi présente un risque prévisible de discrimination indirecte à l'embauche. Le processus de gestion des risques doit documenter ce risque, tester le système sur des sous-groupes démographiques représentatifs, et fixer un seuil d'écart de taux de sélection au-delà duquel le modèle est rejeté — pas seulement le mentionner dans une clause de responsabilité.
Ce processus doit être documenté et mis à jour à chaque changement substantiel du système — y compris un réentraînement sur de nouvelles données ou un changement de fournisseur de modèle sous-jacent. En pratique, les équipes matures intègrent ce processus dans leur cycle de développement logiciel habituel : chaque nouvelle version majeure du modèle déclenche automatiquement une revue de risques, au même titre qu'une revue de sécurité ou une revue de performance. Cette intégration évite l'écueil classique du document de gestion des risques rédigé une seule fois, au lancement, puis jamais mis à jour malgré des changements substantiels ultérieurs — un manquement que les autorités de surveillance du marché identifient en priorité lors d'un contrôle, car il révèle une absence de gouvernance continue plutôt qu'un simple oubli ponctuel.
Gouvernance des données d'entraînement (Article 10)
Les jeux de données utilisés pour l'entraînement, la validation et le test doivent répondre à des critères de qualité vérifiables :
- Pertinence et représentativité au regard des personnes ou groupes concernés par l'usage prévu.
- Exhaustivité dans la mesure du raisonnable, et absence d'erreurs.
- Prise en compte des caractéristiques propres au contextefenêtre de contexteIAQuantité de texte qu'un modèle peut prendre en compte simultanément : question, documents fournis et historique. Au-delà, les éléments les plus anciens sortent du champ.Voir dans le glossaire géographique, comportemental ou fonctionnel dans lequel le système sera utilisé.
- Examen des biaisbiaisIARégularité correctement apprise dans des données qui ne représentent pas la réalité visée, ou qui enregistrent des décisions passées avec leurs préjugés. Changer d'algorithme ne le corrige pas.Voir dans le glossaire susceptibles d'affecter la santé, la sécurité ou les droits fondamentaux, avec mesures d'atténuation appropriées.
L'article 10 autorise, sous conditions strictes, le traitement de catégories particulières de données personnelles (origine ethnique, santé, orientation sexuelle) dans le seul but de détecter et corriger des biais — jamais pour entraîner le modèle sur ces variables comme facteurs prédictifs. Cette dérogation au RGPD est étroite : minimisation, pseudonymisation, sécurité renforcée et suppression après usage sont obligatoires. Confondre « traiter pour auditer les biais » et « utiliser comme variable du modèle » est l'erreur la plus fréquemment relevée par les autorités de contrôle.
Un fournisseur qui s'appuie sur un modèle fondation tiers (GPT, Llama, Mistral, etc.) n'a généralement pas accès aux données d'entraînement d'origine. Le règlement en tient compte via le régime spécifique des modèles à usage général (voir chapitre 8), mais le fournisseur du système à haut risque reste responsable de documenter les données de son propre fine-tuningFine-tuningIAAjustement des poids d'un modèle pré-entraîné sur un jeu de données spécifique pour adapter son comportement à un domaine ou une tâche cible.Voir dans le glossaire ou de son propre pipeline de récupération (RAGRAGIATechnique consistant à rechercher les documents pertinents et à les fournir au modèle dans son contexte. Elle permet des réponses à jour et citables, ce que l'affinage ne permet pas.Voir dans le glossaire). Cette responsabilité résiduelle surprend souvent les équipes qui pensaient déléguer entièrement la question de la qualité des données au fournisseur du modèle sous-jacent : dès que vos propres documents, exemples d'entraînement ou index vectoriels influencent les sorties du système, ils entrent dans le périmètre de l'article 10 et doivent être tracés au même titre que n'importe quel jeu de données classique.
Documentation technique et Annexe IV
La documentation technique doit exister avant la mise sur le marché et rester à jour pendant toute la période d'exploitation. L'Annexe IV en détaille le contenu minimal :
| Section | Contenu attendu |
|---|---|
| Description générale | Finalité, version, interactions avec matériel/logiciel tiers |
| Éléments de conception | Architecture, choix algorithmiques, logique de décision |
| Données | Provenance, étiquetageétiquetageIATravail consistant à associer à chaque exemple la réponse attendue. C'est presque toujours le poste le plus coûteux d'un projet d'apprentissage supervisé.Voir dans le glossaire, méthodes de collecte, prétraitement |
| Supervision humaine | Mesures techniques permettant l'intervention humaine |
| Métriques de performance | PrécisionprécisionIAProportion des alertes émises par un modèle qui sont justifiées. Elle s'oppose au rappel : améliorer l'une dégrade l'autre.Voir dans le glossaire, robustesse, comportement face aux cas limites |
| Gestion des risques | Synthèse du processus de l'article 9 |
| Changements | Journal des modifications substantielles |
Traitez cette documentation comme un artefact d'ingénierie versionné — dans le même dépôt que le code, générée en partie automatiquement (hyperparamètreshyperparamètreIARéglage choisi avant l'entraînement — vitesse d'apprentissage, taille du modèle, nombre d'itérations. Il se distingue des paramètres, ajustés automatiquement pendant l'entraînement.Voir dans le glossaire, métriques de test, jeux de données référencés par hash). Une documentation rédigée après coup par une équipe juridique séparée de l'équipe technique est presque toujours incomplète sur les aspects algorithmiques et coûte beaucoup plus cher à produire dans l'urgence, au moment d'un audit ou d'une mise en demeure.
Journalisation automatique
Le système doit permettre l'enregistrement automatique d'événements (« logs ») pendant toute la durée de son fonctionnement, dans une mesure appropriée à sa finalité. Ces journaux doivent permettre :
- d'identifier les situations pouvant présenter un risque ;
- de faciliter la surveillance post-commercialisation ;
- de surveiller le fonctionnement du système par l'opérateur déployeur.
Pour les systèmes de reconnaissance biométrique à distance, des exigences renforcées s'appliquent : conservation minimale de six mois, horodatage précis, identification de la personne ayant superviséapprentissage superviséIAMéthode où chaque exemple d'entraînement est accompagné de la réponse attendue. C'est la famille la plus employée en entreprise, mais elle exige des données étiquetées — souvent le poste de coût principal.Voir dans le glossaire chaque vérification.
La durée de conservation n'est pas fixée uniformément par le règlement pour tous les systèmes — elle doit être définie en cohérence avec les obligations sectorielles applicables (droit du travail, RGPD, droit bancaire). En pratique, alignez-la sur la durée de prescription des recours possibles liés à l'usage du système, généralement plusieurs années.
Transparence envers l'opérateur déployeur
Le fournisseur doit accompagner le système d'une notice d'utilisation claire, complète et accessible, incluant :
- l'identité et les coordonnées du fournisseur ;
- les caractéristiques, capacités et limites de performance du système, y compris les groupes de personnes ou situations pour lesquels les performances peuvent être dégradées ;
- les mesures de supervision humaine, y compris les mesures techniques permettant à l'opérateur d'interpréter les sorties ;
- les ressources de calcul et matérielles nécessaires, la durée de vie prévue, les mesures de maintenance.
Cette obligation vise à éviter un déséquilibre d'information structurel : l'opérateur déployeur, qui porte une part de la responsabilité d'usage, doit disposer des éléments techniques nécessaires pour l'exercer réellement — pas d'une notice commerciale édulcorée. Dans les faits, une notice conforme ressemble davantage à une documentation d'ingénieur qu'à une plaquette commerciale : elle doit permettre à un opérateur non spécialiste de comprendre dans quelles circonstances le système est susceptible de se tromper, et quelles actions correctives il peut engager. Une notice qui se contente d'annoncer un taux de précision global, sans détailler les sous-populations ou situations où ce taux chute significativement, ne remplit pas cette fonction.
Supervision humaine effective
L'article 14 exige que le système soit conçu de façon à pouvoir être supervisé efficacement par des personnes physiques pendant la période d'utilisation. Concrètement, cela implique une ou plusieurs des mesures suivantes, intégrées dès la conception :
- comprendre les capacités et limites du système, et surveiller son fonctionnement pour détecter les anomalies ;
- rester conscient du biais d'automatisation — la tendance à valider mécaniquement une sortie du système sans esprit critique ;
- interpréter correctement la sortie, disposant d'outilstool callingIACapacité d'un agent ou d'un LLM à invoquer des outils externes (API, calcul, recherche) pendant le raisonnement.Voir dans le glossaire d'interprétation adaptés ;
- décider, dans une situation donnée, de ne pas utiliser le système ou d'écarter, annuler ou inverser sa sortie ;
- interrompre le système via un dispositif d'arrêt d'urgence (« stop » ou équivalent).
Une simple case à cocher « validé par un humain » dans une interface ne satisfait pas cette exigence si le volume de décisions à traiter rend l'examen individuel matériellement impossible. Les autorités examinent le temps moyen de traitement par dossier au regard de la complexité de la tâche : un superviseur qui valide 400 décisions de crédit par heure ne supervise rien.
Précision, robustesse et cybersécurité (Article 15)
Le système doit atteindre un niveau approprié de précision, de robustesse et de cybersécurité, et maintenir ce niveau tout au long de son cycle de vie. Trois points d'attentionattentionIAMécanisme par lequel un modèle pondère l'importance de chaque token du contexte lorsqu'il en traite un autre, quelle que soit la distance qui les sépare.Voir dans le glossaire :
- Les métriques de précision doivent être déclarées dans la notice d'utilisation, avec leurs conditions de mesure — un taux de précision de 95 % mesuré sur un jeu de testjeu de testIAPartie des données réservée à l'évaluation finale, à n'utiliser qu'une seule fois. Ajuster le modèle d'après ses résultats sur ce jeu lui ôte toute valeur de mesure indépendante.Voir dans le glossaire non représentatif n'a pas de valeur probante.
- La robustesse couvre la résilience aux erreurs, pannes et incohérences, ainsi qu'aux tentatives de manipulation des données d'entrée (empoisonnementempoisonnementCybersécuritéIntroduction délibérée d'exemples corrompus dans un jeu d'entraînement, afin d'altérer durablement le comportement du modèle.Voir dans le glossaire, exemples adversesexemple adverseCybersécuritéEntrée modifiée de façon imperceptible pour un humain, mais suffisante pour faire basculer la décision d'un modèle. Cette fragilité découle de l'absence de sens commun.Voir dans le glossaire) pour les systèmes qui continuent d'apprendre après mise en service.
- La cybersécurité exige des mesures contre les vulnérabilités spécifiques à l'IAintelligence artificielleIAEnsemble des techniques permettant à un programme d'accomplir une tâche qui demanderait de l'intelligence humaine. Le terme couvre aussi bien les systèmes à règles écrites que ceux qui apprennent de données.Voir dans le glossaire : extraction de modèle, inférenceinférenceIAUtilisation d'un modèle déjà entraîné sur une donnée nouvelle. Peu coûteuse à l'unité mais répétée à chaque requête, elle constitue le coût récurrent d'exploitation.Voir dans le glossaire d'appartenance (membership inference), corruption de données d'entraînement.
Enregistrement dans la base de données UE
Avant la mise sur le marché, les systèmes à haut risque relevant de l'Annexe III doivent être enregistrés dans la base de données publique tenue par la Commission européenne. Cet enregistrement inclut l'identité du fournisseur, une description du système, son statut de conformité et, le cas échéant, les résultats de l'évaluation de conformité. Les systèmes utilisés dans le domaine répressif ou migratoire bénéficient d'un accès restreint à cette base pour des raisons de sécurité publique, mais l'obligation d'enregistrement demeure.
Sanctions et surveillance du marché
Le respect de ces huit obligations n'est pas laissé à la seule bonne foi des fournisseurs : chaque État membre désigne une autorité de surveillance du marché chargée de contrôler les systèmes à haut risque effectivement déployés sur son territoire, avec des pouvoirs d'audit, de demande de documentation et de retrait du marché en cas de non-conformité grave. Le non-respect des obligations relatives aux données (article 10) ou à la transparence peut donner lieu à des amendes allant jusqu'à 15 millions d'euros ou 3 % du chiffre d'affaires mondial annuel, le montant le plus élevé étant retenu — un niveau volontairement calqué sur celui du RGPD pour éviter qu'une entreprise n'arbitre en faveur du risque financier. Les PME et jeunes entreprises bénéficient de plafonds proportionnellement réduits, mais restent soumises aux mêmes obligations de fond. Dans la pratique, les premiers contrôles se concentrent sur les secteurs les plus sensibles de l'Annexe III — recrutement, crédit, éducation — où l'écart entre les obligations documentaires et la réalité opérationnelle est le plus fréquemment constaté.
Checklist de mise en conformité
Avant toute mise sur le marché d'un système à haut risque, vérifiez que chacun des éléments suivants existe, est daté et est attribuable à un responsable identifié :
- Processus de gestion des risques documenté et daté, avec revue prévue à échéance régulière.
- Rapport de gouvernance des données couvrant provenance, biais examinés, mesures correctives.
- Documentation technique conforme à l'Annexe IV, versionnée avec le code.
- Mécanisme de journalisation actif en production, durée de conservation définie.
- Notice d'utilisation remise à l'opérateur déployeur, incluant limites de performance.
- Dispositif de supervision humaine testé en conditions réelles de charge.
- Métriques de précision et de robustesse mesurées et déclarées.
- Enregistrement effectué dans la base de données UE avant commercialisation.
Cette liste ne remplace pas l'évaluation de conformité elle-même (traitée au chapitre suivant), mais elle en constitue le socle documentaire indispensable. Un dossier incomplet sur l'un de ces huit points bloque généralement l'ensemble du processus de certification, quel que soit l'organisme notifié sollicité.
L'essentiel à retenir
Ce chapitre détaille les obligations concrètes que doit remplir le fournisseur d'un système IA classé à haut risque avant sa mise sur le marché européen. Il couvre le système de gestion des risques, la gouvernance des données d'entraînement, la documentation technique, la journalisation automatique, les exigences de transparence et de supervision humaine, ainsi que les seuils de précision et de robustesse, ainsi que les sanctions encourues en cas de manquement. L'accent est mis sur les pièges pratiques : documentation rédigée trop tard, logs non conservés, notice d'utilisation absente de garde-fous exploitables par l'opérateur.
- Système de gestion des risques (Article 9)
- Gouvernance des données d'entraînement (Article 10)
- Documentation technique et Annexe IV
- Journalisation automatique (logging)
- Transparence envers l'opérateur déployeur
- Supervision humaine effective (human oversight)
- Précision, robustesse et cybersécurité
- Enregistrement dans la base de données UE
- Sanctions et surveillance du marché
Questions fréquentes
Notre système utilise un modèle fondation tiers (GPT, Mistral, Llama) que nous ne pouvons pas réentraîner entièrement. Sommes-nous quand même responsables de la gouvernance des données au titre de l'article 10 ?
Combien de temps devons-nous conserver les logs générés automatiquement par le système ?
La documentation technique doit-elle être rédigée en français si notre entreprise est basée en France ?
Un changement de version du modèle sous-jacent (par exemple passer de GPT-4 à une version plus récente) déclenche-t-il de nouvelles obligations ?
Quelle est la différence entre les obligations de ce chapitre et celles liées au RGPD ?
Qu'entend le règlement par « biais d'automatisation » dans le contexte de la supervision humaine ?
Faut-il refaire l'enregistrement dans la base de données UE à chaque mise à jour du système ?
Qui contrôle réellement le respect de ces obligations une fois le système commercialisé ?
Progression sauvegardée dans votre navigateur.
Quiz de validation
Quiz Player
Quiz de validation
Plusieurs réponses possibles — validez ensuite.
Vrai ou faux.
Quiz indisponible (données invalides).