





Transparence et risque limité
Les obligations de l'article 50 de l'AI Act pour les chatbots, les deepfakes, le contenu généré par IA et la reconnaissance d'émotions : qui doit informer qui, quand, et sous quelle forme.
Table des matières
Pourquoi ce chapitre change la donne opérationnelle
Les chapitres précédents ont posé la classification par niveau de risque de l'AI ActAI ActConformitéRèglement européen sur l'intelligence artificielle, adopté en 2024. Il classe les systèmes en quatre niveaux de risque selon leur usage — jamais selon leur technologie.Voir dans le glossaire : inacceptable, élevé, limité, minimal. La tentation, à ce stade, est de considérer que « risque limité » signifie « pas grand-chose à faire ». C'est une erreur de lecture qui coûte cher en conformité tardive.
Le risque limité ne dispense pas d'obligations : il change leur nature. Là où le risque élevéhaut risqueConformitéCatégorie de l'AI Act regroupant les usages soumis à conditions strictes : recrutement, crédit, éducation, infrastructures critiques. Elle impose documentation, examen des biais et contrôle humain effectif.Voir dans le glossaire impose une gestion de risque documentée, une évaluation de conformité et un enregistrement dans une base de donnéesdonnéesIAEnsemble d'informations structurées ou non utilisées pour entraîner, évaluer ou alimenter un modèle. La qualité, la quantité et la représentativité des données sont les facteurs décisifs pour les performances en apprentissage automatique.Voir dans le glossaire publique, le risque limité impose des obligations de transparence — informer une personne qu'elle interagit avec une machine, ou qu'un contenu qu'elle consulte a été généré ou modifié par une IAintelligence artificielleIAEnsemble des techniques permettant à un programme d'accomplir une tâche qui demanderait de l'intelligence humaine. Le terme couvre aussi bien les systèmes à règles écrites que ceux qui apprennent de données.Voir dans le glossaire. Ces obligations concernent un volume de systèmes bien plus large que le risque élevé : chatbots de service client, générateurs d'images, outilstool callingIACapacité d'un agent ou d'un LLM à invoquer des outils externes (API, calcul, recherche) pendant le raisonnement.Voir dans le glossaire de retouche vidéo, assistants vocaux. Si votre organisation utilise un LLMLLMIAGrand modèle de langage (Large Language Model) entraîné sur d'énormes corpus pour prédire et générer du texte.Voir dans le glossaire en production, ce chapitre s'applique presque certainement.
Ce qui distingue fondamentalement cette couche du régime applicable au risque élevé, c'est le destinataire de l'obligation. Le risque élevé s'adresse d'abord au régulateur et à l'auditeur : documentation technique, journalisation, marquage CE. Le risque limité s'adresse d'abord à l'utilisateur final, au citoyen exposé au système, à la personne qui lit un article ou regarde une vidéo. C'est une transparence tournée vers le grand public, pas vers l'administration — ce qui change profondément la manière de la concevoir : elle doit être compréhensible sans expertise juridique ni technique.
L'article 50 de l'AI Act entre en application le 2 août 2026, en même temps que la majorité des obligations relatives aux systèmes à risque élevé. Contrairement aux pratiques interdites (applicables depuis février 2025), il reste une marge pour se préparer — mais elle se réduit.
Les quatre situations couvertes par l'article 50
L'article 50 identifie quatre scénarios distincts, chacun avec son propre débiteur d'obligation (fournisseur ou déployeur) et son propre moment d'exécution. Cette répartition n'est pas un détail juridique secondaire : elle détermine qui, dans votre organisation, doit porter le sujet — l'équipe produit qui intègre un modèle tiers n'a pas les mêmes leviers que l'éditeur qui entraîne ce modèle.
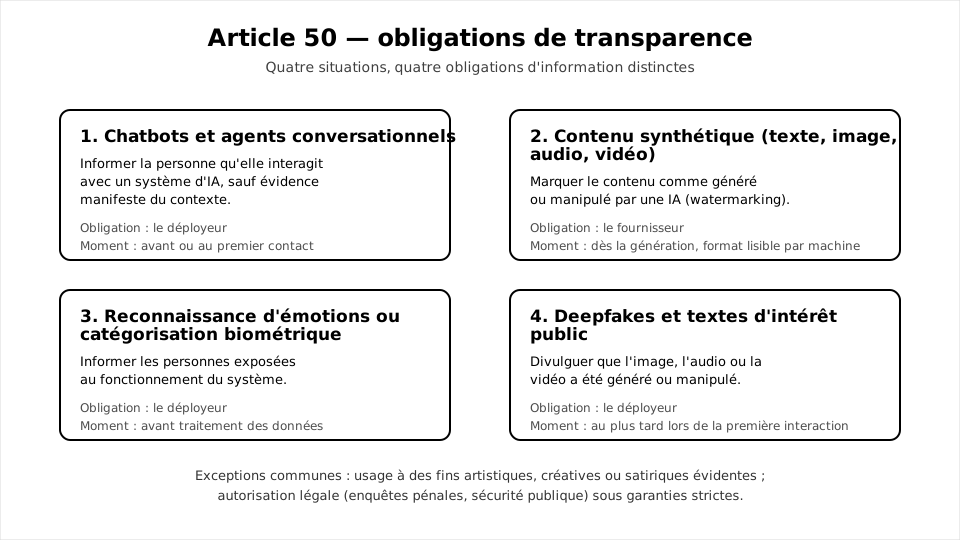
1. Interaction avec un système d'IA (chatbots)
Toute personne interagissant avec un système d'IA — chatbot de support, assistant vocal, agentagentIASystème qui enchaîne des appels d'outils de façon autonome pour atteindre un objectif : il planifie, agit, observe, recommence. Sa fiabilité décroît exponentiellement avec le nombre d'étapes.Voir dans le glossaire conversationnel intégré à une application — doit être informée qu'elle s'adresse à une machine, sauf si cela est évident du point de vue d'une personne raisonnablement informée, compte tenu des circonstances et du contextefenêtre de contexteIAQuantité de texte qu'un modèle peut prendre en compte simultanément : question, documents fournis et historique. Au-delà, les éléments les plus anciens sortent du champ.Voir dans le glossaire d'utilisation.
Cette clause d'évidence est plus étroite qu'elle n'y paraît. Un bandeau « vous discutez avec un assistant automatisé » en bas de page ne suffit pas si l'interface imite délibérément une conversation humaine (avatar photoréaliste, temps de réponse simulé, formulations à la première personne sans nuance). L'obligation porte sur le déployeur — l'entité qui met le système à disposition des utilisateurs finaux — pas sur l'éditeur du modèle sous-jacent.
Une banque en ligne déploie un chatbot fondé sur un LLMgrand modèle de langageIAModèle entraîné à prédire le token suivant d'une séquence de texte. Toutes ses capacités apparentes — résumer, traduire, coder — découlent de cette unique tâche.Voir dans le glossaire pour répondre aux questions sur les comptes. Elle doit afficher une mention claire (« Vous échangez avec un assistant virtuel ») dès le début de la conversation, et non seulement dans les conditions d'utilisation accessibles via un lien en petits caractères.
En pratique, les équipes produit ont tendance à traiter cette mention comme un élément cosmétique, négociable au même titre qu'une couleur de bouton. C'est une erreur d'appréciation : la mention doit rester visible pendant toute la durée de l'interaction, pas seulement au premier message, en particulier dans les conversations longues où l'utilisateur peut oublier le contexte initial ou rejoindre une session déjà entamée par un autre canal (transfert depuis un email, reprise d'un ticket).
2. Contenu généré ou manipulé par IA (marquage machine-readable)
Le fournisseur d'un système d'IA générant du contenu de synthèse — texte, image, audio, vidéo — doit s'assurer que les sorties sont marquées dans un format lisible par machine et détectable comme générées ou manipulées artificiellement. C'est l'obligation qui a le plus fait parler d'elle, sous le terme générique de watermarking.
Plusieurs approches techniques coexistent : métadonnées C2PA intégrées au fichier, filigrane statistique dans les pixels ou les échantillons audio, signature cryptographique du pipeline de génération. L'AI Act n'impose pas de technologie précise — il impose un résultat : que la génération artificielle reste détectable, y compris après des transformations raisonnables (compression, recadrage).
Un marquage visuel superficiel (filigrane texte « généré par IA » en coin d'image) ne satisfait pas l'exigence de format lisible par machine si le contenu peut être recadré ou recompressé pour le faire disparaître. Les autorités attendent un marquage technique robuste, pas seulement une mention affichée.
Cette exigence pose un problème concret aux organisations qui combinent plusieurs outils dans une même chaîne de production de contenu : un texte généré par un LLM, illustré par un générateur d'images tiers, monté avec une voix de synthèse. Chaque maillon peut appliquer son propre schéma de marquage, sans garantie d'interopérabilité entre eux. À ce stade de maturité du marché, il est prudent de documenter, outil par outil, la méthode de marquage utilisée et sa résistance connue aux transformations courantes, plutôt que de présumer une conformité uniforme sur toute la chaîne.
3. Reconnaissance d'émotions et catégorisation biométrique
Le déployeur d'un système de reconnaissance des émotions ou de catégorisation biométrique (déduire des caractéristiques comme l'origine ethnique supposée, les opinions ou l'orientation à partir de données biométriques) doit informer les personnes exposées à son fonctionnement. Cette obligation vaut pour les cas d'usage qui ne tombent pas déjà dans les pratiques interdites du chapitre précédent — par exemple, un logiciel de centre d'appel qui analyse le ton de voix pour adapter un script, sans viser une décision individuelle automatisée à conséquence juridique.
Le traitement des données biométriques concernées reste par ailleurs soumis au RGPDRGPDConformitéRèglement européen sur la protection des données personnelles. Il s'applique dès qu'un système d'IA traite de telles données, et se cumule avec l'AI Act.Voir dans le glossaire en tant que catégorie particulière de données ; l'AI Act ajoute une couche d'information spécifique, il ne remplace pas l'analyse d'impactAIPDConformitéAnalyse d'impact relative à la protection des données, obligatoire dès qu'un traitement est susceptible d'engendrer un risque élevé — ce qui couvre la plupart des systèmes de profilage.Voir dans le glossaire RGPD déjà requise pour ce type de traitement. Dans les organisations qui ont déjà mené une AIPD (analyse d'impact relative à la protection des données) sur ce traitement, le réflexe le plus efficace consiste à ajouter la mention d'information IA comme une extension du registre existant, plutôt que de créer un processus de conformité parallèle et déconnecté.
4. Deepfakes et textes générés sur des sujets d'intérêt public
Le déployeur d'un système générant ou manipulant une image, un contenu audio ou vidéo constituant un deepfake doit divulguer que ce contenu a été généré ou manipulé artificiellement. La même logique s'applique à un texte généré par IA et publié pour informer le public sur des sujets d'intérêt général (actualité, débat public), sauf lorsque le contenu a fait l'objet d'une révision éditoriale humaine et qu'une personne physique ou morale assume la responsabilité éditoriale de sa publication.
Cette dernière réserve est cruciale pour les rédactions et les services de communication : un article généré par IA puis relufonction d'activationIAOpération non linéaire appliquée en sortie d'un neurone. Sans elle, empiler des couches serait inutile : une succession d'opérations linéaires reste équivalente à une seule.Voir dans le glossaire, corrigé et validé par un journaliste identifié échappe à l'obligation de divulgation systématique — mais l'organisation doit être en mesure de démontrer cette supervision éditoriale effective.
Tableau de synthèse
| Situation | Débiteur | Moment de l'obligation | Support attendu |
|---|---|---|---|
| Chatbot / agent conversationnel | Déployeur | Avant ou au début de l'interaction | Mention claire dans l'interface |
| Contenu de synthèse (image, audio, vidéo, texte) | Fournisseur | Dès la génération | Marquage technique lisible par machine |
| Reconnaissance d'émotions / catégorisation biométrique | Déployeur | Avant le traitement | Information préalable des personnes exposées |
| Deepfake / texte d'intérêt public | Déployeur | Au plus tard à la première exposition | Divulgation explicite, sauf supervision éditoriale documentée |
Les exceptions : ne pas les sur-appliquer
Deux familles d'exceptions traversent l'article 50 :
- Usage artistique, créatif, satirique ou fictionnel manifeste — un deepfake utilisé dans une œuvre de fiction clairement identifiée comme telle n'a pas à porter la même divulgation qu'un contenu présenté comme authentique. L'obligation de transparence est alors adaptée : elle ne doit pas nuire à la présentation ou à la jouissance de l'œuvre, mais une information appropriée reste due.
- Autorisation légale — détection, prévention, enquête ou poursuite d'infractions pénales, sous réserve des garanties prévues par le droit de l'Union ou national et dans le respect des droits fondamentaux.
Ces exceptions sont d'interprétation stricte. Elles ne couvrent pas un usage commercial « à visée créative » invoqué a posteriori pour justifier l'absence de marquage sur un contenu que le public perçoit comme réel.
Sanctions et niveau de risque réel pour l'organisation
Le non-respect des obligations de transparence de l'article 50 relève d'un régime de sanctions distinct de celui des pratiques interdites, mais loin d'être symbolique : les amendes administratives prévues par l'AI Act pour ce type de manquement peuvent atteindre plusieurs millions d'euros ou un pourcentage du chiffre d'affaires mondial annuel, selon le barème applicable aux violations autres que celles concernant les pratiques interdites ou les obligations les plus lourdes du risque élevé. À cela s'ajoute un risque souvent sous-estimé par les directions juridiques : le risque réputationnel. Un deepfake non signalé qui circule largement avant d'être identifié comme tel expose l'organisation déployeuse à une perte de confiance difficile à réparer, indépendamment du montant de la sanction administrative éventuelle.
Il faut aussi noter que les autorités de surveillance du marché, désignées par chaque État membre, pourront s'appuyer sur des signalements d'utilisateurs autant que sur des contrôles proactifs. Un mécanisme de signalement mal géré en interne — sans procédure claire pour recevoir et traiter une alerte sur un contenu non marqué — expose l'organisation à un délai de correction qui aggrave sa responsabilité.
Articulation avec RGPD, ISO 42001 et NIS2
L'article 50 ne se substitue à aucun autre cadre :
- Le RGPD continue de régir la licéité du traitement des données personnelles utilisées par ces systèmes (base légale, minimisation, durée de conservation). Informer qu'on interagit avec une IA ne dispense pas d'informer sur le traitement des données au sens des articles 13 et 14 du RGPD.
- La norme ISO 42001 (système de management de l'IA) fournit un cadre organisationnel pour documenter et auditer ces obligations de transparence dans la durée — utile pour prouver, en cas de contrôle, que le marquage et l'information ne sont pas un geste ponctuel mais un processus maintenu.
- NIS2 reste hors périmètre : cette directive concerne la cybersécurité des réseaux et systèmes d'information critiques, pas l'information des utilisateurs sur la nature générée d'un contenu. Les deux textes peuvent s'appliquer simultanément à un même opérateur sans se recouvrir.
Checklist de mise en conformité
- Recenser tous les points de contact utilisateur impliquant un système conversationnel automatisé.
- Vérifier que chaque interface concernée affiche une mention explicite et non dissimulée dès le premier échange, et qu'elle reste accessible tout au long de la session.
- Identifier les pipelines de génération de contenu (texte, image, audio, vidéo) et évaluer leur capacité de marquage technique, y compris lorsque plusieurs outils sont chaînés.
- Documenter, pour chaque contenu généré publié sur un sujet d'intérêt public, le niveau de supervision éditoriale humaine effective.
- Croiser les traitements de reconnaissance d'émotions ou de catégorisation biométrique avec l'analyse d'impact RGPD déjà réalisée, le cas échéant.
- Former les équipes marketing et communication aux exceptions artistiques : leur portée réelle, pas leur interprétation commode.
- Mettre en place une procédure de traitement des signalements externes concernant un contenu potentiellement non marqué.
- Prévoir un point de contrôle récurrent — pas seulement au lancement d'un produit — pour suivre les évolutions du système et de ses sorties.
Traitez l'article 50 comme une exigence de design produit, pas comme une case à cocher juridique en fin de projet. Intégrer la mention « vous parlez à une IA » dans les maquettes dès la phase de conception coûte une ligne de code ; la retrofitter sur un produit déjà déployé auprès de millions d'utilisateurs coûte un cycle de communication de crise.
Ce qu'il faut retenir avant le chapitre suivant
Le risque limité n'est pas un risque négligeable : c'est un risque dont le traitement passe par l'information plutôt que par le contrôle technique renforcé. Il touche un périmètre de systèmes bien plus large que le risque élevé, avec des obligations réparties entre fournisseur et déployeur qu'il faut cartographier précisément dans chaque chaîne d'intégration. Le prochain chapitre aborde les obligations documentaires attendues pour les systèmes à usage général (modèles de fondation), qui recoupent partiellement cette logique de transparence mais avec un périmètre et des destinataires différents — régulateurs et fournisseurs en aval plutôt qu'utilisateurs finaux.
L'essentiel à retenir
Ce chapitre détaille l'article 50 de l'AI Act, qui impose des obligations d'information et de marquage pour les systèmes dits à risque limité : chatbots, générateurs de contenu synthétique, systèmes de reconnaissance d'émotions et deepfakes. Il distingue les obligations qui pèsent sur le fournisseur de celles qui pèsent sur le déployeur, avec des exemples concrets, un point sur les sanctions applicables et les exceptions prévues par le texte. Il montre aussi comment cette couche de transparence s'articule avec le RGPD et la norme ISO 42001, sans se confondre avec les obligations de cybersécurité de NIS2.
Questions fréquentes
Est-ce que tous les chatbots doivent afficher une mention obligatoire, même les plus simples ?
Le marquage des contenus générés par IA doit-il être visible à l'œil nu ?
Une entreprise qui utilise un LLM tiers (via API) est-elle fournisseur ou déployeur au sens de l'article 50 ?
Que se passe-t-il si un deepfake est publié sans divulgation ?
Cette obligation de transparence s'applique-t-elle en dehors de l'Union européenne ?
Comment prouver, en cas de contrôle, qu'un texte généré par IA a fait l'objet d'une supervision éditoriale ?
L'article 50 concerne-t-il aussi les images publicitaires générées par IA ?
Progression sauvegardée dans votre navigateur.
Quiz de validation
Quiz Player
Quiz de validation
Plusieurs réponses possibles — validez ensuite.
Vrai ou faux.
Quiz indisponible (données invalides).