





L'IA au service de la cybersécurité
Positionnement clair entre IA appliquée à la cybersécurité et sécurisation des systèmes d'IA, panorama des cas d'usage SOC et bilan lucide entre promesses commerciales et réalité opérationnelle.
Table des matières
Pourquoi ce chapitre est le plus utile
Le terme « IAintelligence artificielleIAEnsemble des techniques permettant à un programme d'accomplir une tâche qui demanderait de l'intelligence humaine. Le terme couvre aussi bien les systèmes à règles écrites que ceux qui apprennent de données.Voir dans le glossaire et cybersécurité » recouvre deux sujets distincts, et la confusion entre les deux coûte cher en projets mal cadrés. D'un côté, l'IA comme outil au service des équipes de sécurité : détecter des intrusions, trier des alertes, accélérer une investigation. De l'autre, la sécurisation des systèmes d'IA eux-mêmes — protéger un modèle contre le vol, l'empoisonnementempoisonnementCybersécuritéIntroduction délibérée d'exemples corrompus dans un jeu d'entraînement, afin d'altérer durablement le comportement du modèle.Voir dans le glossaire ou le détournement. Ce chapitre traite exclusivement du premier sujet. Le second sera abordé plus loin dans cette formation, dans un chapitre dédié à la sécurité des systèmes d'IA.
Cette distinction n'est pas académique. Une équipe qui achète une solution « IA de détection » sans comprendre son mécanisme sous-jacent prend le risque d'hériter d'un outil dont elle ne pourra jamais auditer les décisions. Et une équipe qui pense « sécurité de l'IA » quand son besoin réel est « IA pour la sécurité » finit par lire une documentation qui ne répond à aucune de ses questions opérationnelles.
Dans toute cette formation, « IA pour la cybersécurité » désigne l'IA comme moyen de défense (SOC, détection, réponse). « Sécurité des systèmes d'IA » désigne la protection des modèles eux-mêmes contre les attaques. Les deux sujets partagent du vocabulaire mais pas les mêmes enjeux ni les mêmes métiers.
Ce que fait réellement l'IA dans un SOC
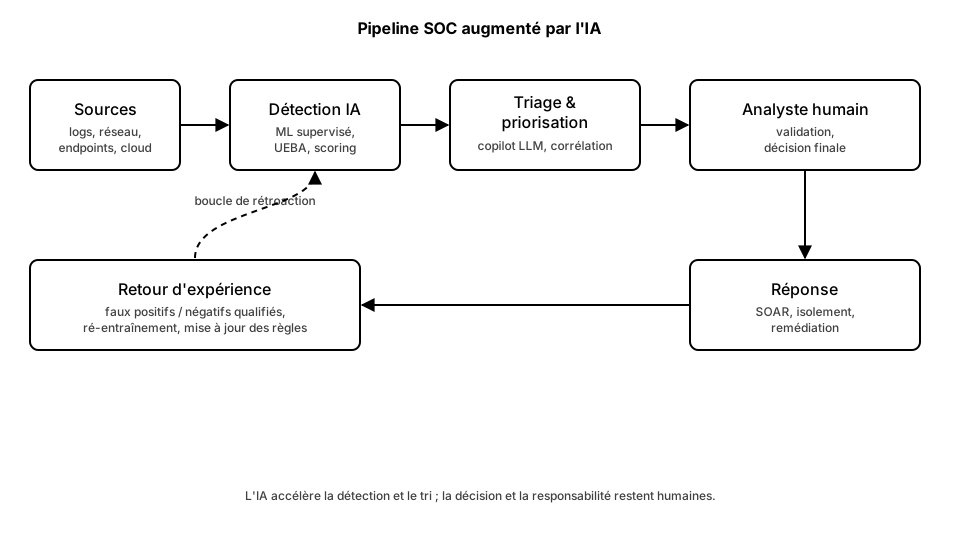
Un centre opérationnel de sécurité (SOC) reçoit un volume de télémétrie que l'humain seul ne peut plus traiter : logs réseau, événements EDR, alertes cloud, flux de threat intelligence. L'IA y intervient à plusieurs étages, avec des techniques différentes selon l'étage.
Détection d'anomalies et UEBA. Le User and Entity Behavior Analytics construit un profil statistique du comportement normal d'un compte, d'une machine ou d'une application, puis signale les écarts significatifns. Techniquement, il s'agit le plus souvent de modèles de classification supervisée entraînés sur des jeux de donnéesdonnéesIAEnsemble d'informations structurées ou non utilisées pour entraîner, évaluer ou alimenter un modèle. La qualité, la quantité et la représentativité des données sont les facteurs décisifs pour les performances en apprentissage automatique.Voir dans le glossaire étiquetés (trafic légitime vs malveillant), ou de méthodes non supervisées (clustering, détection d'outliers) quand les étiquettes manquent. Un compte qui se connecte soudain à 3h du matin depuis un pays inhabituel, ou qui exfiltre un volume de données dix fois supérieur à sa moyenne, déclenche un score de risque.
Triage et priorisation. Un SOC de taille moyenne génère des milliers d'alertes par jour, dont la grande majorité sont des faux positifs ou des doublons. Des modèles de scoring corrèlent les alertes entre elles, éliminent les doublons et proposent un ordre de traitement fondé sur la criticité estimée. C'est souvent l'usage le plus rentable de l'IA en SOC, car il attaque directement le problème numéro un des équipes : la fatigue d'alerte.
Copilotes d'analyste. Les modèles de langage (LLMLLMIAGrand modèle de langage (Large Language Model) entraîné sur d'énormes corpus pour prédire et générer du texte.Voir dans le glossaire) commencent à être intégrés comme assistants de rédaction et de synthèse : résumer un incident, proposer une chronologie à partir de logs bruts, rédiger un premier brouillon de rapport, traduire une requête en langage naturel vers une requête SIEM. Ce n'est pas un moteur de détection : c'est un accélérateur de traitement de l'information déjà détectée.
Threat intelligence. Des modèles de traitement du langage analysent des flux ouverts (forums, dépôts de code, rapports de vulnérabilités) pour repérer des mentions d'une organisation, d'une technologie ou d'un indicateur de compromission, et alimenter automatiquement les bases de connaissance.
Exemple concret Une alerte EDR signale un processus PowerShell inhabituel sur un poste. Le moteur de corrélation associe cet événement à une connexion réseau sortante vers une IP jamais vue et à une élévation de privilège récente sur le même compte. Le score de risque combiné place l'alerte en tête de file. Un copilote LLMgrand modèle de langageIAModèle entraîné à prédire le token suivant d'une séquence de texte. Toutes ses capacités apparentes — résumer, traduire, coder — découlent de cette unique tâche.Voir dans le glossaire génère un résumé en trois lignes et une chronologie horodatée pour l'analyste, qui valide ou écarte en quelques minutes au lieu de reconstituer l'historique à la main.
Panorama des cas d'usage par famille
| Cas d'usage | Technique dominante | Gain principal | Limite principale |
|---|---|---|---|
| Détection d'intrusion réseau | MLapprentissage automatiqueIABranche de l'IA où le programme dégage lui-même ses règles à partir d'exemples, au lieu de les recevoir d'un développeur. C'est ce déplacement des règles écrites vers les régularités apprises qui définit l'IA moderne.Voir dans le glossaire superviséapprentissage superviséIAMéthode où chaque exemple d'entraînement est accompagné de la réponse attendue. C'est la famille la plus employée en entreprise, mais elle exige des données étiquetées — souvent le poste de coût principal.Voir dans le glossaire sur flux | Détecte des signatures inconnues | Faux positifs en environnement bruité |
| UEBA (comportement utilisateur) | Clustering, scoring statistique | Repère l'usage détourné de comptes légitimes | Période d'apprentissage longue, sensible au changement d'usage |
| Triage d'alertes | Corrélation, scoring de risque | Réduit la fatigue d'alerte | Dépend de la qualité des règles de corrélation |
| Copilote d'investigation | LLM génératif | Accélère la rédaction et la synthèse | Peut halluciner des détails dans un résumé |
| Détection de phishing | Classification de texte et d'URL | Filtre en amont un volume élevé | Contournable par reformulation adverse |
| Threat intelligence automatisée | NLP sur sources ouvertes | Couverture large et continue | Bruit important, besoin de validation humaine |
Comment évaluer la performance d'un modèle de détection
Avant d'adopter un outil, il faut savoir lire les chiffres que son fournisseur met en avant — et ceux qu'il omet. Trois indicateurs suffisent à cadrer une discussion sérieuse.
La précisionprécisionIAProportion des alertes émises par un modèle qui sont justifiées. Elle s'oppose au rappel : améliorer l'une dégrade l'autre.Voir dans le glossaire mesure la proportion d'alertes réellement pertinentes parmi toutes les alertes déclenchées : un modèle très précis génère peu de faux positifs. Le rappelrappelIAProportion des cas positifs réels effectivement détectés par un modèle. Sur un jeu déséquilibré, c'est un indicateur bien plus parlant que l'exactitude globale.Voir dans le glossaire mesure la proportion de menaces réelles effectivement détectées parmi toutes celles qui existaient : un modèle à fort rappel manque peu de menaces, mais souvent au prix d'alertes plus nombreuses. Ces deux mesures évoluent en tension : améliorer l'une dégrade généralement l'autre, d'où l'usage fréquent du score F1, une moyenne qui pénalise les modèles déséquilibrés dans un sens ou dans l'autre.
Ces chiffres ne valent que si le jeu de testjeu de testIAPartie des données réservée à l'évaluation finale, à n'utiliser qu'une seule fois. Ajuster le modèle d'après ses résultats sur ce jeu lui ôte toute valeur de mesure indépendante.Voir dans le glossaire sur lequel ils ont été calculés ressemble à l'environnement réel de déploiement. Un modèle annoncé à 98 % de précision sur un jeu de données académique peut chuter fortement une fois confronté au trafic spécifique d'une organisation — volumétrie différente, outilstool callingIACapacité d'un agent ou d'un LLM à invoquer des outils externes (API, calcul, recherche) pendant le raisonnement.Voir dans le glossaire métier inhabituels, langue des utilisateurs, fuseau horaire des connexions légitimes. C'est pourquoi une phase de calibration sur les données propres à l'environnement cible est indispensable avant toute mise en production, et pourquoi un chiffre de performance annoncé sans préciser le jeu de test associé doit être accueilli avec réserve.
Un autre biaisbiaisIARégularité correctement apprise dans des données qui ne représentent pas la réalité visée, ou qui enregistrent des décisions passées avec leurs préjugés. Changer d'algorithme ne le corrige pas.Voir dans le glossaire fréquent concerne le déséquilibre des classes : dans un trafic réel, les événements malveillants représentent une fraction infime du volume total. Un modèle qui classerait systématiquement tout comme « bénin » afficherait une exactitude globale trompeusement élevée, tout en étant inutile. C'est précisément pour cette raison que la précision et le rappel, calculés spécifiquement sur la classe « malveillant », sont des indicateurs plus fiables que l'exactitude globale dans ce contextefenêtre de contexteIAQuantité de texte qu'un modèle peut prendre en compte simultanément : question, documents fournis et historique. Au-delà, les éléments les plus anciens sortent du champ.Voir dans le glossaire.
Enfin, la performance mesurée au moment de l'évaluation initiale ne garantit rien pour les mois suivants : c'est le rôle du suivi de la dérivedériveIADégradation progressive des performances d'un modèle après son déploiement, causée par l'évolution des comportements ou du contexte. Elle impose surveillance et réentraînement.Voir dans le glossaire des données, évoqué plus loin, de vérifier que ces indicateurs restent stables dans le temps.
Promesses commerciales et réalité opérationnelle
Le marché de la cybersécurité vend abondamment de l'« IA » comme argument différenciant. Il est utile de savoir ce que ces promesses recouvrent réellement.
« Détection en temps réel de toutes les menaces. » En pratique, tout modèle de détection opère un compromis entre taux de détection et taux de faux positifs. Augmenter la sensibilité pour capter davantage de menaces réelles augmente mécaniquement le nombre de fausses alertes, qui finissent par noyer les analystes — l'inverse de l'objectif recherché.
« Zéro-day détecté automatiquement. » Les modèles comportementaux peuvent effectivement signaler une activité inhabituelle liée à une exploitation inconnue, mais ils ne « comprennent » pas qu'il s'agit d'un zéro-day : ils signalent un écart statistique. La qualification reste un travail humain.
« L'IA remplace l'analyste junior. » Les tâches répétitives de premier niveau (tri, enrichissement de contexte) sont effectivement de bons candidats à l'automatisation. Mais la validation finale, la contextualisation métier et la décision de remédiation restent des compétences humaines, en particulier parce que la responsabilité juridique et opérationnelle d'un incident ne peut pas être déléguée à un modèle.
Un modèle de détection entraîné sur les attaques d'hier reste structurellement aveugle aux techniques inédites qui ne ressemblent à rien de son jeu d'entraînement. C'est un filtre statistique, pas une compréhension causale de la menace. Aucun déploiement ne doit reposer sur l'hypothèse d'une couverture exhaustive.
Les pièges structurels à connaître
Certaines limites ne sont pas des bugs corrigibles par une prochaine version : elles découlent du principe même de ces systèmes.
- Dérive des données (data drift). L'environnement défendu change en permanence — nouveaux usages, nouveaux outils, nouveaux collaborateurs. Un modèle entraîné sur un état passé du système d'information voit sa pertinence se dégrader silencieusement si personne ne surveille cette dérive.
- Attaques adversariales. Un attaquant qui connaît (ou devine) la logique d'un classifieur peut construire une charge malveillante spécifiquement conçue pour rester sous le seuil de détection — reformulation d'un email de phishing, fragmentation d'un flux réseau, mimétisme comportemental. La détection par IA devient elle-même une surface à défendre.
- Empoisonnement des données d'entraînement. Si un modèle se ré-entraîne en continu sur des données issues du trafic observé, un attaquant patient peut injecter progressivement du bruit ou des faux exemples pour biaiser le modèle en sa faveur.
- Absence d'explicabilité. Beaucoup de modèles de détection produisent un score sans justification exploitable. Un analyste qui ne peut pas comprendre pourquoi une alerte a été générée — ou supprimée — ne peut ni la challenger ni en tirer un apprentissage transférable.
- HallucinationhallucinationIAProduction par un modèle d'un énoncé faux formulé avec la même assurance qu'un fait établi. Le phénomène est structurel : le modèle optimise la vraisemblance, pas la vérité.Voir dans le glossaire dans les copilotes. Un LLM utilisé pour résumer un incident peut introduire un détail plausible mais faux — une adresse IPadresse IPRéseauxIdentifiant numérique attribué à une machine sur un réseau, qui permet de l'atteindre depuis n'importe où. Elle tient sur 32 bits en IPv4 et sur 128 bits en IPv6.Voir dans le glossaire légèrement modifiée, une chronologie réordonnée. Dans un contexte d'investigation, une telle erreur peut orienter une décision de remédiation sur une base fausse.
Ces limites ne disqualifient pas l'usage de l'IA en SOC. Elles définissent le périmètre dans lequel ces outils sont fiables : accélérateurs de traitement et de tri, pas oracles de vérité. La suite de cette formation détaille comment calibrer cette confiance cas par cas.
Checklist avant d'introduire de l'IA dans un SOC
- Le cas d'usage vise-t-il la détection, le triage ou la synthèse ? Ce ne sont pas les mêmes garanties attendues.
- Existe-t-il un mécanisme de suivi du taux de faux positifs et de faux négatifs dans le temps, ou le modèle est-il évalué une fois puis oublié ?
- Qui valide chaque alerte critique avant action ? Une décision de remédiation automatique sans validation humaine doit être justifiée et documentée.
- Le fournisseur documente-t-il les données d'entraînement, au moins à un niveau suffisant pour évaluer les biais probables (secteur, langue, type de trafic) ?
- Existe-t-il un plan de surveillance de la dérive des données, avec un seuil de ré-entraînement ou de réévaluation ?
- Les sorties d'un copilote génératif sont-elles systématiquement vérifiables (source citée, log associé) avant d'être intégrées à un rapport officiel ?
- L'équipe sait-elle expliquer, en une phrase, pourquoi une alerte a été priorisée ou écartée par le système ?
Commencez toujours par un cas d'usage à faible risque de décision — le triage plutôt que le blocage automatique — pour construire la confiance et calibrer les seuils avant d'envisager une automatisation de la réponse.
Ce qui reste du ressort humain
Même dans les déploiements les plus avancés, trois responsabilités ne se délèguent pas à un modèle : la décision finale sur un incident à fort impact, l'interprétation du contexte métier (criticité réelle d'un système pour l'organisation) et la responsabilité juridique de la réponse apportée. L'IA change le volume de travail qu'une équipe peut absorber ; elle ne change pas la nature de la décision de sécurité, qui reste un arbitrage humain informé par des données produites — en partie — par des machines.
Cette répartition des rôles a aussi une conséquence organisationnelle directe : elle change le profil de compétences recherché dans une équipe de sécurité. Savoir lire un score de risque, challenger une alerte générée par un modèle, ou repérer qu'un résumé produit par un copilote contient une incohérence devient aussi important que la maîtrise technique classique d'un outil SIEM. Les équipes qui réussissent leur transition ne sont pas celles qui achètent le plus d'outils marqués « IA », mais celles qui forment leurs analystes à comprendre les mécanismes sous-jacents — au moins à un niveau suffisant pour savoir quand faire confiance à une sortie de modèle et quand la remettre en question.
La suite de cette formation approfondira chacun de ces cas d'usage : détection comportementale, copilotes d'investigation, automatisation de la réponse, puis — dans un chapitre séparé — la sécurisation des systèmes d'IA lorsqu'ils deviennent eux-mêmes une cible.
L'essentiel à retenir
Ce chapitre distingue deux sujets souvent confondus : utiliser l'IA comme outil de défense (détection, triage, réponse) et sécuriser les systèmes d'IA eux-mêmes, qui sera traité plus loin dans la formation. Il présente les cas d'usage concrets de l'IA en SOC — détection d'anomalies, priorisation d'alertes, copilotes d'analyse, threat intelligence — avec leurs mécanismes de fonctionnement. Il expose aussi les limites structurelles de ces outils : faux positifs, dérive des données, contournement adversarial, dépendance excessive. Une checklist de fin de chapitre aide à évaluer un projet d'IA en cybersécurité avant déploiement.
Questions fréquentes
L'IA peut-elle remplacer un SOC humain ?
Pourquoi mon outil de détection IA génère-t-il autant de faux positifs ?
Un attaquant peut-il contourner un système de détection basé sur l'IA ?
Faut-il faire confiance aux résumés d'incidents générés par un copilote IA ?
Quelle est la différence entre ce chapitre et un chapitre sur la sécurité des systèmes d'IA ?
Par où commencer pour introduire de l'IA dans une équipe de sécurité déjà en place ?
Qu'est-ce que la fatigue d'alerte et pourquoi l'IA est-elle censée y répondre ?
Les modèles de détection IA fonctionnent-ils contre les attaques inédites (zero-day) ?
Progression sauvegardée dans votre navigateur.
Quiz de validation
Quiz Player
Quiz de validation
Plusieurs réponses possibles — validez ensuite.
Vrai ou faux.
Quiz indisponible (données invalides).