





Triage d'alertes assisté
Comment un moteur de scoring assisté par IA hiérarchise les alertes de sécurité, et pourquoi la décision finale doit rester entre les mains de l'analyste. Ce chapitre couvre le scoring, le human-in-the-loop et les métriques MTTD/MTTR.
Table des matières
Pourquoi ce chapitre est le plus opérationnel
Le triage n'est pas une tâche périphérique du SOC (Security Operations Center) : c'est le goulot d'étranglement qui détermine si une intrusion réelle est traitée en dix minutes ou noyée sous cinq mille faux positifs. Un analyste qui traite manuellement chaque alerte y consacre en moyenne moins de trente secondes — pas parce qu'il est négligent, mais parce que le volume ne laisse pas d'autre choix. C'est précisément ce terrain que l'IAintelligence artificielleIAEnsemble des techniques permettant à un programme d'accomplir une tâche qui demanderait de l'intelligence humaine. Le terme couvre aussi bien les systèmes à règles écrites que ceux qui apprennent de données.Voir dans le glossaire de triage vient occuper : non pas remplacer le jugement de l'analyste, mais réduire l'espace de recherche avant qu'il n'intervienne.
Ce chapitre décrit le mécanisme de scoring, la place exacte de l'humain dans la boucleHuman-in-the-loopIABoucle où un opérateur humain valide, corrige ou arbitre les décisions du système IA avant une action irréversible.Voir dans le glossaire, et les deux métriques — MTTD et MTTR — qui permettent de vérifier si le système apporte un gain réel ou seulement un déplacement du problème.
Le problème du volume : alert fatigue
Un SIEM (Security Information and Event Management) moyen dans une organisation de taille intermédiaire génère entre 2 000 et 10 000 alertes par jour, selon la couverture des sources (EDR, pare-feupare-feuRéseauxÉquipement ou logiciel qui filtre le trafic selon des règles (ports, adresses, états) pour réduire la surface d'attaque.Voir dans le glossaire, proxy, DNSDNSRéseauxSystème qui traduit un nom de domaine en adresse IP, par interrogations successives de la racine, des serveurs de premier niveau puis des serveurs faisant autorité.Voir dans le glossaire, IAM). La très grande majorité — souvent plus de 95 % — correspond à du bruit : scans automatisés déjà bloqués, règles de détection mal calibrées, comportements légitimes mais atypiques (un administrateur qui se connecte depuis un nouveau poste, par exemple).
Ce déséquilibre produit un phénomène bien documenté en ergonomie de la sécurité : l'alert fatigue. Un analyste exposé en continu à un flux dominé par le bruit développe des réflexes de rejet rapide, y compris sur les alertes qui mériteraient une investigation. Le risque n'est donc pas seulement la perte de temps — c'est la perte de vigilance sur les signaux rares mais critiques, noyés dans la masse.
L'objectif d'un système de triage assisté n'est pas de réduire le nombre d'alertes générées en amont, mais de réordonner ce qui arrive à l'analyste pour que les 5 % pertinents soient traités en premier. Confondre les deux objectifs conduit à mal calibrer le projet dès le départ.
Comment fonctionne un moteur de scoring
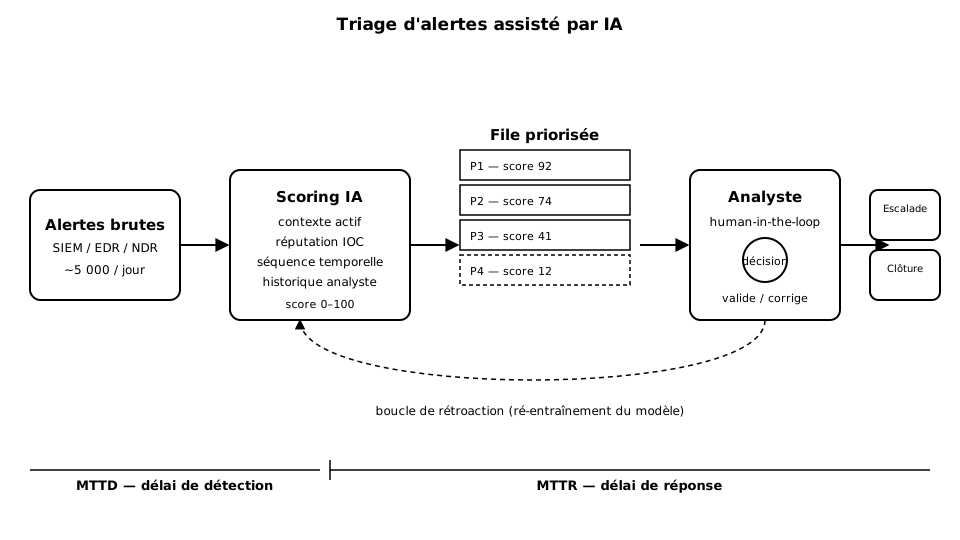
Le cœur du dispositif est un modèle qui attribue à chaque alerte un score numérique, en général entre 0 et 100, représentant une estimation de sa probabilité d'être un incident réel nécessitant une action. Ce score s'appuie sur plusieurs familles de signaux, combinées plutôt qu'utilisées isolément :
- Contextefenêtre de contexteIAQuantité de texte qu'un modèle peut prendre en compte simultanément : question, documents fournis et historique. Au-delà, les éléments les plus anciens sortent du champ.Voir dans le glossaire de l'actif — criticité métier de la machine ou du compte concerné (un serveur de paie n'a pas le même poids qu'un poste de test), exposition réseau, historique de vulnérabilités connues.
- Réputation des indicateurs — une adresse IPadresse IPRéseauxIdentifiant numérique attribué à une machine sur un réseau, qui permet de l'atteindre depuis n'importe où. Elle tient sur 32 bits en IPv4 et sur 128 bits en IPv6.Voir dans le glossaire, un hash de fichier ou un domaine déjà associés à des campagnes malveillantes connues (threat intelligence externe).
- Séquence temporelle — une alerte isolée pèse moins qu'une chaîne d'événements cohérente sur une fenêtre courte (reconnaissance, puis élévation de privilèges, puis mouvement latéral).
- Historique analyste — la manière dont des alertes similaires ont été traitées par le passé (clôturées comme faux positif, ou escaladées) sert de signal d'apprentissage.
Ce score n'est pas une vérité binaire : c'est une estimation probabiliste. Deux alertes ayant reçu un score de 70 ne représentent pas nécessairement le même niveau de risque réel — elles indiquent seulement une probabilité comparable selon les signaux disponibles au moment du calcul.
En amont du calcul, un travail de préparation des donnéesdonnéesIAEnsemble d'informations structurées ou non utilisées pour entraîner, évaluer ou alimenter un modèle. La qualité, la quantité et la représentativité des données sont les facteurs décisifs pour les performances en apprentissage automatique.Voir dans le glossaire conditionne toute la qualité du scoring. Les événements bruts issus du SIEM, de l'EDR ou des journaux d'authentification sont hétérogènes : formats différents, granularités différentes, horodatages parfois décalés d'une source à l'autre. Une étape de normalisation et d'enrichissement transforme ces événements en un jeu de variables comparables — c'est ce qu'on appelle le feature engineering. Par exemple, un événement de connexion brut devient une variable « distance géographique par rapport à la dernière connexion connue », ou « nombre de tentatives d'authentification échouées dans les dix minutes précédentes ». La qualité de ce travail de transformation pèse souvent plus lourd sur la performance finale du modèle que le choix de l'algorithme de classification lui-même.
La plupart des moteurs de scoring de production reposent sur des modèles de classification supervisée relativement classiques (gradient boosting, forêts aléatoires) plutôt que sur des grands modèles de langagegrand modèle de langageIAModèle entraîné à prédire le token suivant d'une séquence de texte. Toutes ses capacités apparentes — résumer, traduire, coder — découlent de cette unique tâche.Voir dans le glossaire. Les LLMLLMIAGrand modèle de langage (Large Language Model) entraîné sur d'énormes corpus pour prédire et générer du texte.Voir dans le glossaire interviennent surtout en aval, pour résumer une alerte ou proposer une piste d'investigation en langage naturel — pas pour calculer le score lui-même.
Le pipeline complet, du SIEM à la décision
Le schéma ci-dessous détaille les étapes intermédiaires entre la réception d'une alerte brute et la décision finale, avec la boucle de rétroaction qui permet au modèle de s'améliorer à partir des décisions de l'analyste.
Human-in-the-loop : où l'humain reste décisionnaire
Le terme human-in-the-loop désigne un principe précis : le système propose, l'humain dispose. Concrètement, cela signifie que le score IA détermine l'ordre de traitement des alertes, mais jamais leur clôture automatique sans qu'un analyste ait validé la décision — sauf dans des cas très encadrés et à faible enjeu (par exemple, blocage automatique d'une IP déjà connue comme malveillante avec un score de confiance proche de 100, réversible en un clic).
Trois raisons structurelles justifient ce garde-fou :
- Le modèle apprend sur des données historiques, donc il reproduit les biaisbiaisIARégularité correctement apprise dans des données qui ne représentent pas la réalité visée, ou qui enregistrent des décisions passées avec leurs préjugés. Changer d'algorithme ne le corrige pas.Voir dans le glossaire de triage passés. Si des alertes légitimes ont historiquement été mal classées comme faux positifs, le modèle apprendra à les sous-pondérer à nouveau.
- Le contexte métier évolue plus vite que le modèle. Une réorganisation, une fusion, un nouveau prestataire externe changent la surface légitime d'activité sans que le modèle en soit informé en temps réel.
- Le coût d'un faux négatif est asymétrique. Clore automatiquement une alerte qui s'avère être une intrusion réelle a un coût potentiellement très supérieur au coût de faire réexaminer une alerte bénigne par un humain.
Ne configurez jamais un système de triage pour clôturer automatiquement des alertes sous un certain score sans échantillonnage de contrôle. Un score bas dans la queue basse de la distribution masque parfois exactement le type d'attaque « low and slow » que les attaquants privilégient pour éviter la détection.
En phase de déploiement, commencez par un mode assistif pur : le modèle réordonne la file, l'analyste traite dans cet ordre, mais toute alerte reste visible et clôturable manuellement. N'introduisez l'automatisation d'actions (blocage, quarantaine) qu'après plusieurs mois de mesure de la fiabilité du score sur votre propre environnement.
Mesurer l'impact : MTTD et MTTR
Deux métriques permettent de vérifier objectivement si un projet de triage assisté produit un gain réel, au-delà de l'impression subjective de « moins de bruit ».
| Métrique | Définition | Ce qu'elle mesure |
|---|---|---|
| MTTD (Mean Time To Detect) | Délai moyen entre le début réel d'une activité malveillante et sa détection par le SOC | Efficacité de la couverture de détection et de la priorisation |
| MTTR (Mean Time To Respond) | Délai moyen entre la détection d'un incident et sa remédiation effective | Efficacité du processus d'investigation et de réponse |
Un moteur de scoring bien calibré agit principalement sur le MTTD : en remontant les alertes à fort potentiel de gravité en tête de file, il réduit le temps que ces alertes passent noyées dans la pile avant d'être examinées. L'effet sur le MTTR est indirect mais réel : un analyste qui reçoit une alerte accompagnée d'un contexte pré-agrégé (actifs concernés, IOC déjà enrichis, chronologie des événements liés) investigue plus vite qu'un analyste qui part d'une ligne de log brute.
Un centre opérationnel traitant 6 000 alertes par jour mesure un MTTD moyen de 4 h 12 avant le déploiement d'un moteur de scoring. Après trois mois d'utilisation en mode assistif, avec réentraînement mensuel sur les décisions des analystes, le MTTD moyen descend à 1 h 48 pour les alertes de score supérieur à 80 — sans amélioration mesurable pour les alertes de score inférieur à 30, ce qui est attendu : le système reclasse, il ne comble pas les angles morts de détection en amont.
Ces deux métriques doivent être suivies par segment de gravité, pas en moyenne globale. Une moyenne globale peut s'améliorer artificiellement si le système accélère le traitement des alertes déjà faciles, sans rien changer sur les alertes critiques — ce qui serait un échec du projet malgré un tableau de bord flatteur.
Anatomie d'une alerte triée
Pour rendre le mécanisme moins abstrait, voici comment une alerte concrète traverse le pipeline. Un EDR signale l'exécution d'un script PowerShell encodé en base64 sur un poste de travail appartenant à un compte du service comptabilité, en dehors des horaires habituels de connexion de cet utilisateur.
Au moment du scoring, plusieurs signaux se combinent : l'exécution de scripts encodés est une technique fréquemment associée à des tentatives d'évasion de détection (poids fort dans le score) ; l'actif est un poste utilisateur standard, pas un serveur critique (poids modéré à la baisse) ; l'horaire est atypique par rapport au comportement historique du compte (poids fort) ; aucun indicateur de compromission connu n'est associé au hash du script (poids neutre, car l'absence de réputation négative n'est pas une preuve d'innocuité). Le score résultant, par exemple 81 sur 100, place l'alerte en tête de la file de l'analyste de garde, alors qu'un scan de portportRéseauxNuméro sur 16 bits qui désigne l'application destinataire sur une machine. Les ports 0 à 1023 sont réservés aux services système, comme 443 pour HTTPS.Voir dans le glossaire isolé sur un serveur déjà exposé publiquement, moins signifiant statistiquement, reçoit un score de 22 et attend son tour plus bas dans la file.
L'analyste ouvre l'alerte enrichie : le contexte pré-agrégé lui indique déjà l'actif concerné, l'historique de connexion du compte et les autres événements survenus dans la même fenêtre temporelle sur le même poste. Il confirme qu'il s'agit d'une activité malveillante après trois minutes d'investigation, escalade vers l'équipe de réponse à incident, et cette décision — escalade, pas clôture — est réintégrée dans le jeu de données qui servira au prochain réentraînement du modèle.
Ce cas illustre pourquoi le score seul ne suffit jamais : il oriente l'ordre de passage, mais c'est la lecture du contexte enrichi par un humain formé qui transforme un chiffre en décision de sécurité.
Pièges fréquents
Dérive du modèledériveIADégradation progressive des performances d'un modèle après son déploiement, causée par l'évolution des comportements ou du contexte. Elle impose surveillance et réentraînement.Voir dans le glossaire (model drift). Les techniques d'attaque évoluent, l'infrastructure de l'organisation aussi. Un modèle entraîné il y a huit mois sur un périmètre différent perd progressivement en pertinence. Un réentraînement périodique et un suivi de la distribution des scores dans le temps permettent de détecter cette dérive avant qu'elle ne dégrade silencieusement la priorisation.
EmpoisonnementempoisonnementCybersécuritéIntroduction délibérée d'exemples corrompus dans un jeu d'entraînement, afin d'altérer durablement le comportement du modèle.Voir dans le glossaire de la boucle de rétroaction. Si le modèle apprend à partir des clôtures des analystes, et qu'un analyste clôture rapidement des alertes par lassitude plutôt que par analyse réelle, le modèle apprend à reproduire ce raccourci. La qualité du signal d'apprentissage dépend directement de la qualité du geste de triage humain — un système de triage assisté n'est jamais meilleur que les décisions sur lesquelles il s'entraîne.
Confusion entre score de risque et verdict. Un score élevé signale une priorité d'examen, pas une confirmation d'incident. Traiter le score comme un verdict conduit à des escalades automatiques mal justifiées, et à une perte de confiance des équipes de réponse envers l'outil dès les premiers faux positifs à fort score.
Checklist avant déploiement
- Le score du modèle est-il documenté et explicable (quels signaux pèsent le plus, sur quelles données il a été entraîné) ?
- Existe-t-il un mécanisme d'échantillonnage pour contrôler manuellement un pourcentage d'alertes à faible score ?
- Le MTTD et le MTTR sont-ils mesurés par segment de gravité, avant et après déploiement ?
- La boucle de rétroaction est-elle auditée périodiquement pour détecter un empoisonnement du signal d'apprentissage ?
- Une procédure de rollback existe-t-elle si le modèle dérive de façon mesurable ?
- Les analystes ont-ils été formés à interpréter le score comme une priorité, pas comme un verdict ?
Cette checklist ne garantit pas la réussite du projet, mais elle évite les erreurs de cadrage les plus coûteuses : automatiser une clôture sans contrôle, ou mesurer un gain de façade sur une moyenne globale qui masque l'absence de progrès sur les cas critiques.
L'essentiel à retenir
Un SOC moderne reçoit des milliers d'alertes quotidiennes et l'essentiel du travail d'un analyste consiste à décider, en quelques secondes, lesquelles méritent une investigation. Ce chapitre explique comment un moteur de scoring assisté par IA construit une priorisation à partir de signaux de contexte, de réputation et de séquence temporelle, puis pourquoi cette priorisation doit toujours passer par une validation humaine avant escalade ou clôture. Il détaille aussi les deux métriques qui permettent de mesurer l'impact réel d'un tel système, le MTTD et le MTTR, et les pièges classiques d'un déploiement mal cadré : dérive du modèle, empoisonnement de la boucle de rétroaction, clôture automatique de faux négatifs.
Questions fréquentes
Un système de triage assisté peut-il remplacer complètement une équipe SOC ?
Faut-il un grand modèle de langage pour faire du scoring d'alertes ?
Comment savoir si le modèle de scoring dérive dans le temps ?
Quel est le risque principal si on automatise trop tôt la clôture d'alertes à faible score ?
Le MTTD peut-il s'améliorer sans que la détection en amont change ?
Comment les analystes doivent-ils interpréter un score de 90 sur 100 ?
Quelle est la fréquence recommandée de réentraînement d'un modèle de scoring ?
Progression sauvegardée dans votre navigateur.
Quiz de validation
Quiz Player
Quiz de validation
Plusieurs réponses possibles — validez ensuite.
Vrai ou faux.
Quiz indisponible (données invalides).