





Limites et attaques adversariales
Les modèles de machine learning déployés en sécurité (détection d'intrusion, scoring de phishing, EDR comportemental) ont des failles structurelles que l'attaquant peut exploiter délibérément. Ce chapitre détaille l'empoisonnement, l'évasion, la fuite de données et la dérive, et donne une checklist de validation avant mise en production.
Table des matières
Pourquoi ce chapitre change votre lecture d'un rapport de détection
Un modèle de machine learningapprentissage automatiqueIABranche de l'IA où le programme dégage lui-même ses règles à partir d'exemples, au lieu de les recevoir d'un développeur. C'est ce déplacement des règles écrites vers les régularités apprises qui définit l'IA moderne.Voir dans le glossaire intégré à un SOC n'est pas un composant qui échoue au hasard. Il échoue selon des mécanismes précis, et un attaquant qui connaît ces mécanismes peut les provoquer délibérément. La différence est fondamentale pour la posture de sécurité : un faux négatif aléatoire relève de la robustesse générale du système, un faux négatif provoqué relève d'une attaque contre le modèle lui-même, avec son propre vecteur, sa propre chronologie et ses propres traces.
Un modèle de détection n'a pas de notion d'intention. Il calcule une probabilité à partir de motifs statistiques appris. Si un attaquant façonne son comportement — ou les données d'entraînementdonnéesIAEnsemble d'informations structurées ou non utilisées pour entraîner, évaluer ou alimenter un modèle. La qualité, la quantité et la représentativité des données sont les facteurs décisifs pour les performances en apprentissage automatique.Voir dans le glossaire — pour que le motif appris ne corresponde plus à l'activité malveillante réelle, le modèle continue de fonctionner « normalement » tout en étant devenu inefficace ou dirigé contre son propriétaire.
Ce chapitre couvre quatre familles de limites structurelles — empoisonnementempoisonnementCybersécuritéIntroduction délibérée d'exemples corrompus dans un jeu d'entraînement, afin d'altérer durablement le comportement du modèle.Voir dans le glossaire, évasion, fuite de donnéesfuite de donnéesIAErreur consistant à laisser entrer dans l'entraînement une information qui n'existera pas au moment réel de la prédiction. Le modèle affiche des scores excellents puis s'effondre en production.Voir dans le glossaire, dérivedériveIADégradation progressive des performances d'un modèle après son déploiement, causée par l'évolution des comportements ou du contexte. Elle impose surveillance et réentraînement.Voir dans le glossaire — puis un cas spécifique aux copilotes IAintelligence artificielleIAEnsemble des techniques permettant à un programme d'accomplir une tâche qui demanderait de l'intelligence humaine. Le terme couvre aussi bien les systèmes à règles écrites que ceux qui apprennent de données.Voir dans le glossaire générative désormais intégrés aux SOC : l'injection de promptInjection de promptCybersécuritéAttaque visant à détourner un LLM en insérant des instructions malveillantes dans le contexte (entrée utilisateur, document RAG, etc.).Voir dans le glossaire. Il ne s'agit pas de dissuader l'usage du machine learning en sécurité, mais de savoir ce que ces systèmes ne garantissent pas, pour construire des contrôles compensatoires en conséquence.
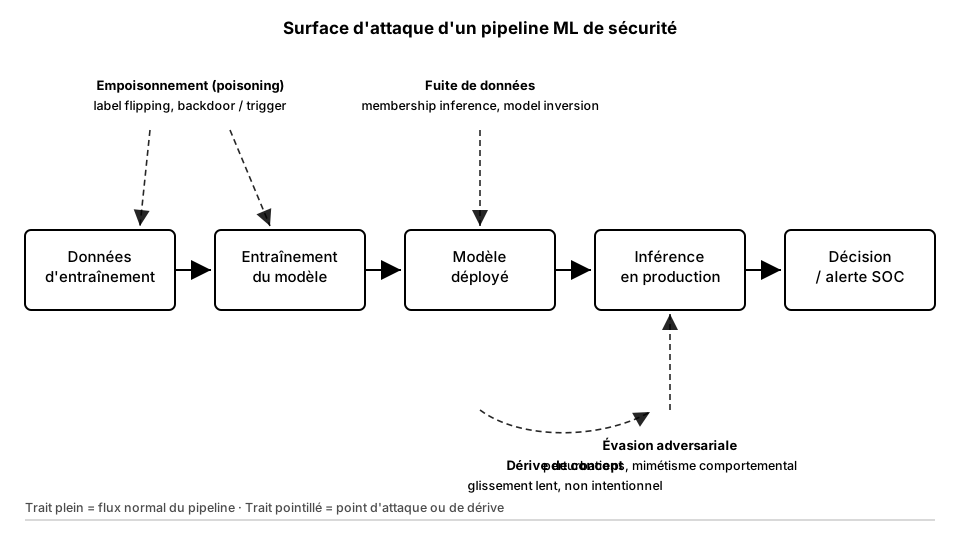
Empoisonnement des données d'entraînement (poisoning)
Un modèle apprend ce qu'on lui donne à apprendre. Si les données d'entraînement contiennent des exemples corrompus, le modèle intègre cette corruption comme s'il s'agissait d'un signal légitime. C'est l'empoisonnement.
Label flipping. L'attaquant fait en sorte que des échantillons malveillants soient étiquetés comme bénins dans le jeu d'entraînement — par exemple en injectant, dans un flux de télémétrie réseau collecté en continu, du trafic d'exfiltration maquillé pour ressembler à du trafic de sauvegarde habituel, puis validé sans revue humaine par le pipeline de labellisation automatique. Le modèle réentraîné apprend alors que ce motif est normal.
Porte dérobée (backdoor). Plus subtil : l'attaquant n'essaie pas de dégrader la précisionprécisionIAProportion des alertes émises par un modèle qui sont justifiées. Elle s'oppose au rappel : améliorer l'une dégrade l'autre.Voir dans le glossaire générale du modèle, ce qui serait visible dès la validation. Il insère un motif déclencheur (trigger) — une combinaison de caractéristiques rare et spécifique — associé systématiquement à une classification bénigne. Le modèle conserve une excellente précision sur tous les cas de test standards. Seul le trigger produit l'effet recherché. C'est l'équivalent, côté modèle, d'un compte à privilèges caché dans un système : invisible tant qu'on ne cherche pas spécifiquement à le déclencher.
Un fournisseur d'EDR entraîne périodiquement son moteur comportemental sur des échantillons remontés par ses clients et validés par une sandbox automatisée. Un attaquant patient soumet, sur plusieurs mois, des variantes bénignes de son propre outillage contenant une signature d'appel système rare mais constante. Une fois cette signature associée au label « bénin » dans suffisamment de cycles de réentraînement, l'attaquant l'intègre à son implant réel : celui-ci passe la détection comportementale sans qu'aucune règle n'ait été modifiée.
L'empoisonnement se détecte rarement à la performance globale du modèle, qui reste bonne sur les jeux de validation standards. Le contrôle efficace porte sur la provenance des données : traçabilité des sources, quotas par contributeur, détection d'anomalies statistiques dans la distribution des nouveaux échantillons avant intégration au jeu d'entraînement.
Évasion adversariale à l'inférence
L'évasion ne touche pas les données d'entraînement mais l'objet analysé au moment de la décision. L'attaquant modifie légèrement l'artefact — fichier, requête réseau, séquence d'appels — pour franchir la frontière de décision du modèle sans changer sa fonction malveillante.
Sur des données structurées (image, son), ces perturbations sont souvent imperceptibles à l'œil humain : un bruit calculé pixel par pixel qui fait basculer une classification. Sur des données de sécurité, la mécanique est différente mais l'objectif identique :
- Malware evasion — ajout de sections inertes, de padding, de chaînes de caractères bénignes dans un binaire, pour déplacer son vecteur de caractéristiques loin de la zone que le classifieur associe au code malveillant, sans toucher au code exécuté.
- Mimétisme comportemental (mimicry attack) — un implant fractionne ses actions dans le temps ou les intercale avec des appels système légitimes, pour que la séquence observée par le modèle comportemental ressemble statistiquement à un processus normal.
- Perturbation de trafic réseau — ajustement du volume, du timing ou du padding des paquets d'exfiltration pour rester sous les seuils appris par un détecteur d'anomalies de flux.
Ce qui distingue l'évasion adversariale d'un simple contournement de règle : elle exploite la frontière de décision apprise, pas une faille de configuration. Deux malwares fonctionnellement identiques peuvent recevoir des scores opposés selon qu'ils ont été façonnés pour rester du bon côté de cette frontière.
Un classifieur seul ne suffit jamais comme unique ligne de défense. La pratique robuste combine plusieurs détecteurs de nature différente (signatures, heuristiques, ML, comportemental) dont les frontières de décision ne coïncident pas : un artefact façonné pour évader l'un a peu de chances d'évader les autres simultanément, sauf effort d'ingénierie disproportionné.
Fuite de données et inversion de modèle
Un modèle entraîné sur des données sensibles — journaux internes, indicateurs de compromission propriétaires, échantillons de malwares clients — peut, dans certaines conditions, révéler des informations sur ces données à quiconque interroge le modèle de façon répétée.
Membership inference. L'attaquant cherche à déterminer si un enregistrement précis faisait partie du jeu d'entraînement, en observant la confiance ou le comportement du modèle face à cet enregistrement comparé à des enregistrements inconnus. Appliqué à un modèle de détection entraîné sur des incidents réels d'une entreprise, cela peut révéler qu'un incident spécifique — donc une compromission passée — a bien eu lieu, information que l'entreprise n'a jamais rendue publique.
Inversion de modèle (model inversion). Plus poussée, cette technique tente de reconstruire, à partir des sorties du modèle, une approximation des données d'entraînement elles-mêmes. Sur un modèle entraîné à reconnaître des signatures de malwares propriétaires ou des schémas d'attaque internes à un secteur, cela revient à exfiltrer indirectement de la propriété intellectuelle sans jamais accéder au système qui héberge le modèle.
Ces deux techniques ne nécessitent pas d'accès au code ni aux poids du modèle : une API d'inférenceinférenceIAUtilisation d'un modèle déjà entraîné sur une donnée nouvelle. Peu coûteuse à l'unité mais répétée à chaque requête, elle constitue le coût récurrent d'exploitation.Voir dans le glossaire exposée publiquement, avec des réponses suffisamment fines (scores de confiance, probabilités par classe), fournit assez d'information pour les mener à bien. C'est un argument fort pour limiter la granularité des réponses exposées par une API de scoring de sécurité tournée vers l'extérieur.
Dérive et robustesse dans le temps
Un modèle validé au déploiement se dégrade ensuite pour deux raisons de nature différente, qu'il est essentiel de distinguer dans un rapport d'incident.
La dérive de concept (concept drift) est un glissement non intentionnel : les usages légitimes évoluent (nouvelle application métier, nouveau fournisseur cloud, changement d'architecture réseau), et la distribution du trafic « normal » s'éloigne progressivement de celle apprise à l'entraînement. Le modèle se met à générer plus de faux positifs, ou au contraire perd en sensibilité sur des motifs qu'il classait bien auparavant.
La dérive adversariale est le même symptôme observable — baisse de performance dans le temps — mais causée par un ajustement délibéré et progressif du comportement d'un attaquant qui teste itérativement les limites du détecteur, souvent en environnement non détecté avant l'attaque finale.
Le piège classique consiste à traiter systématiquement une baisse de performance comme un problème de dérive naturelle à corriger par réentraînement, alors qu'elle peut signaler une reconnaissance active en cours. Le réentraînement automatique sur des données récentes, sans revue, est alors le pire réflexe possible : il revient à intégrer le comportement de l'attaquant comme nouvelle norme, ce qui est une forme d'empoisonnement graduel.
Le cas des copilotes IA générative en SOC
L'intégration de modèles de langage comme assistants d'analyse — résumé d'alertes, corrélation d'incidents, rédaction de rapports — introduit une surface d'attaque supplémentaire : l'injection de promptpromptIAConsigne ou contexte fourni à un modèle de langage pour orienter sa réponse. La qualité du prompt conditionne souvent la qualité du résultat.Voir dans le glossaire. Un copilote qui lit des tickets, des pages web, des e-mails de phishing ou des logs bruts pour les résumer traite ce contenu comme du texte à analyser, mais un modèle de langagegrand modèle de langageIAModèle entraîné à prédire le token suivant d'une séquence de texte. Toutes ses capacités apparentes — résumer, traduire, coder — découlent de cette unique tâche.Voir dans le glossaire ne distingue pas structurellement une donnée d'une instruction formulée en langage naturel.
Un attaquant peut donc dissimuler, dans un e-mail de phishing soumis pour analyse ou dans un champ de log qu'il contrôle, une instruction destinée à manipuler le résumé produit par le copilote — par exemple pour le pousser à qualifier l'alerte de faux positif, ou à omettre un indicateur de compromission clé du rapport final relufonction d'activationIAOpération non linéaire appliquée en sortie d'un neurone. Sans elle, empiler des couches serait inutile : une succession d'opérations linéaires reste équivalente à une seule.Voir dans le glossaire par l'analyste.
Un copilote SOC ne doit jamais disposer d'un droit d'action autonome (fermeture d'alerte, modification de règle, ouverture de ticket) sans validation humaine, précisément parce que son entrée inclut du contenu potentiellement contrôlé par l'attaquant qu'il est censé aider à détecter.
Synthèse comparative
| Attaque | Moment | Cible | Impact typique | Levier de mitigation principal |
|---|---|---|---|---|
| Poisoning | Entraînement | Jeu de données | Backdoor, biaisbiaisIARégularité correctement apprise dans des données qui ne représentent pas la réalité visée, ou qui enregistrent des décisions passées avec leurs préjugés. Changer d'algorithme ne le corrige pas.Voir dans le glossaire durable | Provenance et audit des données |
| Évasion | Inférence | Artefact analysé | Faux négatif ciblé | Détection multi-couches hétérogène |
| Membership inference / inversion | Inférence répétée | API du modèle | Fuite de données sensibles | Limiter la granularité des réponses |
| Dérive de concept | Post-déploiement | Distribution des données | Faux positifs/négatifs croissants | Monitoring continu, réentraînement superviséapprentissage superviséIAMéthode où chaque exemple d'entraînement est accompagné de la réponse attendue. C'est la famille la plus employée en entreprise, mais elle exige des données étiquetées — souvent le poste de coût principal.Voir dans le glossaire |
| Injection de prompt | Inférence (LLMLLMIAGrand modèle de langage (Large Language Model) entraîné sur d'énormes corpus pour prédire et générer du texte.Voir dans le glossaire) | Contenu analysé par le copilote | Rapport ou décision manipulés | Séparation stricte donnée/instruction, pas d'action autonome |
Checklist avant tout déploiement d'un modèle de sécurité
- Documenter la provenance de chaque source de données d'entraînement et la fréquence de réentraînement.
- Vérifier l'absence de corrélation anormale entre un motif rare et une classe de sortie (test de backdoor par recherche de triggers).
- Tester le modèle contre des variantes perturbées d'échantillons connus (tests d'évasion internes, red team dédiée au modèle).
- Limiter la granularité des scores exposés par toute API d'inférence accessible depuis l'extérieur du périmètre de confiance.
- Mettre en place un monitoring de dérive distinct de l'alerting métier, avec seuils déclenchant une revue humaine avant réentraînement automatique.
- Interdire toute action autonome d'un copilote IA générative sans validation humaine, et traiter tout contenu externe comme non fiable par défaut.
- Conserver un second mécanisme de détection de nature différente pour chaque décision critique, afin d'éviter la dépendance à une frontière de décision unique.
Ce qu'il faut retenir
Aucune de ces limites ne se corrige par une simple mise à jour de version. Elles découlent de la nature même de l'apprentissage statistique : un modèle généralise à partir de ce qu'il a vu, et tout ce qui influence ce qu'il voit — au moment de l'entraînement, de l'inférence ou de la relecture par un copilote — influence sa fiabilité. La bonne pratique n'est pas de renoncer au machine learning en sécurité, mais de ne jamais lui confier une décision critique sans un second mécanisme de contrôle de nature différente, et sans une traçabilité complète des données qui l'ont façonné.
L'essentiel à retenir
Un modèle de sécurité basé sur le machine learning n'est pas seulement faillible par erreur statistique : il peut être délibérément manipulé par un attaquant qui connaît son fonctionnement. Ce chapitre distingue quatre familles de risques structurels — l'empoisonnement des données d'entraînement, l'évasion à l'inférence, la fuite de données par inversion de modèle, et la dérive de concept dans le temps — et montre comment chacune s'exploite concrètement contre un IDS, un antivirus comportemental ou un copilote SOC. Il se termine par une checklist opérationnelle destinée à être appliquée avant tout déploiement en production.
- Empoisonnement des données d'entraînement (data poisoning)
- Porte dérobée algorithmique (backdoor / trigger)
- Évasion adversariale à l'inférence
- Fuite de données par inférence d'appartenance (membership inference)
- Inversion de modèle (model inversion)
- Dérive de concept (concept drift)
- Injection de prompt contre un copilote SOC
Questions fréquentes
Peut-on rendre un modèle de détection totalement insensible aux attaques adversariales ?
Un modèle de sécurité détecte-t-il lui-même qu'il est en train d'être attaqué de façon adversariale ?
Le fine-tuning d'un modèle avec des données issues d'un partenaire externe est-il risqué ?
Comment détecter une éventuelle backdoor dans un modèle pré-entraîné téléchargé publiquement ?
La fuite de données par inversion de modèle est-elle concernée par le RGPD ?
Faut-il renoncer aux copilotes IA générative dans un SOC à cause du risque d'injection de prompt ?
Quelle différence pratique entre robustesse et fiabilité d'un modèle de sécurité ?
Progression sauvegardée dans votre navigateur.
Quiz de validation
Quiz Player
Quiz de validation
Plusieurs réponses possibles — validez ensuite.
Vrai ou faux.
Quiz indisponible (données invalides).