





Enrichir le SIEM avec l'IA
Comment l'IA transforme un flux d'événements bruts en alertes contextualisées et priorisées, à travers la corrélation, l'enrichissement asset/utilisateur et la construction de pipelines fiables.
Table des matières
Pourquoi enrichir plutôt qu'ajouter des règles
Un SIEM (Security Information and Event Management) collecte des événements — connexions, exécutions de processus, requêtes DNSDNSRéseauxSystème qui traduit un nom de domaine en adresse IP, par interrogations successives de la racine, des serveurs de premier niveau puis des serveurs faisant autorité.Voir dans le glossaire, modifications de permissions — et les fait passer à travers des règles de détection. Le problème n'est pas la détection elle-même : c'est le volume de ce qu'elle produit. Une équipe SOC de taille moyenne reçoit couramment plusieurs milliers d'alertes par jour, dont l'écrasante majorité sont des faux positifs ou des événements bénins mal qualifiés. Cette situation porte un nom : la fatigue d'alertes. Elle a un effet mesurable — au-delà d'un certain volume, les analystes ferment les tickets plus vite qu'ils ne les investiguent, et le taux de détection réel de l'organisation baisse alors même que le nombre de règles augmente.
Ajouter des règles ne résout pas ce problème, il l'aggrave généralement. Chaque règle supplémentaire ajoute du bruit avant d'ajouter du signal. L'approche qui fonctionne consiste à enrichir chaque événement avec le contextefenêtre de contexteIAQuantité de texte qu'un modèle peut prendre en compte simultanément : question, documents fournis et historique. Au-delà, les éléments les plus anciens sortent du champ.Voir dans le glossaire nécessaire pour qu'un humain — ou un modèle — puisse juger de sa gravité réelle en quelques secondes plutôt qu'en ouvrant cinq consoles différentes.
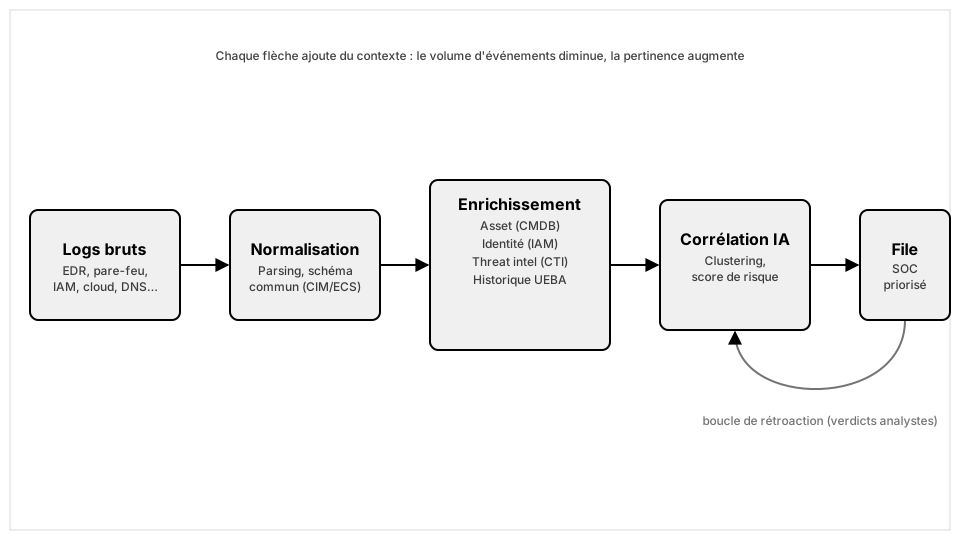
Enrichir un SIEM ne veut pas dire y brancher un chatbot. Il s'agit d'un pipeline de donnéesdonnéesIAEnsemble d'informations structurées ou non utilisées pour entraîner, évaluer ou alimenter un modèle. La qualité, la quantité et la représentativité des données sont les facteurs décisifs pour les performances en apprentissage automatique.Voir dans le glossaire classique — ingestion, jointure, scoring — dans lequel un ou plusieurs modèles interviennent à des étapes précises, souvent en complément de règles déterministes plutôt qu'à leur place.
Les quatre couches de contexte
Un événement brut — par exemple « l'utilisateur j.martin s'est connecté depuis l'adresse IPadresse IPRéseauxIdentifiant numérique attribué à une machine sur un réseau, qui permet de l'atteindre depuis n'importe où. Elle tient sur 32 bits en IPv4 et sur 128 bits en IPv6.Voir dans le glossaire 41.203.12.8 » — ne dit presque rien en soi. Sa gravité dépend entièrement du contexte qu'on lui associe. Quatre couches reviennent systématiquement dans les architectures d'enrichissement matures.
L'identité. Le référentiel IAM (Active Directory, Okta, Entra ID) indique le rôle de l'utilisateur, ses habitudes de connexion, son appartenance à des groupes sensibles. Un administrateur du domaine qui se connecte à 3h du matin depuis un pays inhabituel n'a pas le même poids qu'un stagiaire.
L'actif. La CMDB ou l'inventaire cloud précise ce qu'est la machine concernée — poste utilisateur, serveur de production, contrôleur de domaine — sa criticité métier, les vulnérabilités connues qui l'affectent, sa date de dernier correctif.
Le renseignement sur la menace (CTI). Les flux de threat intelligence — commerciaux, sectoriels, open source — permettent de savoir si l'adresse IP, le hash de fichier ou le domaine observé est déjà associé à une campagne connue, à un groupe d'attaquants identifié, ou à une infrastructure jetable récemment enregistrée.
L'historique comportemental (UEBA). L'analyse comportementale utilisateur et entité établit une ligne de base — volumes de données transférées, horaires habituels, machines fréquentées — puis signale les écarts. C'est ici que le modèle statistique ou le modèle d'apprentissage automatiqueapprentissage automatiqueIABranche de l'IA où le programme dégage lui-même ses règles à partir d'exemples, au lieu de les recevoir d'un développeur. C'est ce déplacement des règles écrites vers les régularités apprises qui définit l'IA moderne.Voir dans le glossaire a le plus de valeur, car aucune règle statique ne peut capturer le comportement normal de chaque utilisateur individuellement.
| Source de contexte | Ce qu'elle apporte | Mode de défaillance typique |
|---|---|---|
| IAM / annuaire | Rôle, privilèges, groupes sensibles | Comptes fantômes, droits non révoqués |
| CMDB / inventaire | Criticité de l'actif, exposition | Inventaire incomplet ou périmé |
| Threat intelligence | Réputation IOC, attribution | Faux positifs sur IP partagées, latence de publication |
| UEBA / comportemental | Écarts par rapport à une ligne de base | Base d'apprentissage biaisée par une activité déjà compromise |
Une ligne de base UEBA construite sur une période durant laquelle un compte était déjà compromis normalise l'activité malveillante au lieu de la signaler. Vérifiez systématiquement l'hygiène de la fenêtre d'apprentissage avant d'activer une détection comportementale en production.
Corrélation assistée par IA : du volume au signal
Une fois les événements enrichis, l'étape de corrélation regroupe ce qui appartient probablement à la même chaîne d'attaque et attribue un score de risque global plutôt qu'un score par événement isolé. Trois techniques sont couramment combinées.
Le clustering non superviséapprentissage non superviséIAMéthode où aucune réponse n'est fournie : le modèle doit dégager seul une structure dans les données, par exemple en regroupant des éléments semblables ou en repérant des anomalies.Voir dans le glossaire rapproche des événements qui partagent des caractéristiques statistiques proches — même sous-réseau, même séquence temporelle, même type de processus — sans qu'une règle explicite ait été écrite pour ce cas précis. Il est particulièrement utile pour détecter des variantes de comportements déjà connus sans multiplier les signatures.
La détection d'anomalies supervisée s'appuie sur des historiques d'incidents confirmés pour apprendre à distinguer une séquence bénigne d'une séquence malveillante. Sa qualité dépend directement de la qualité et du volume des exemples étiquetés — un SOC qui commence tout juste à structurer ses données d'incidents obtiendra des résultats médiocres avec cette approche.
Les modèles de langage interviennent en aval, pour résumer une chaîne d'événements corrélés en un texte lisible par l'analyste, proposer une hypothèse d'investigation, ou rédiger un premier brouillon de rapport. Leur rôle n'est pas de décider si l'alerte est vraie ou fausse — cette décision reste un scoring numérique déterministe ou statistique — mais de réduire le temps de lecture humaine.
Un pipeline corrèle en dix minutes : une connexion VPNVPNRéseauxRéseau privé virtuel qui chiffre le trafic entre deux points sur un réseau public. Il crée un tunnel sécurisé permettant d'accéder à des ressources distantes comme si on était sur le réseau local.Voir dans le glossaire depuis un pays inhabituel, une élévation de privilèges sur ce compte, puis une exfiltration de 2 Go vers un stockage cloud externe. Pris séparément, chacun de ces trois événements franchit un seuil de règle classique mais reste noyé dans le flux. Corrélés et enrichis du contexte « compte administrateur, actif critique, destination jamais utilisée par cet utilisateur », ils remontent en tête de file avec un score de risque de 92/100 et un résumé généré automatiquement en une phrase.
Anatomie d'un pipeline d'enrichissement
L'architecture qui fonctionne en production suit toujours la même logique séquentielle, même si les outilstool callingIACapacité d'un agent ou d'un LLM à invoquer des outils externes (API, calcul, recherche) pendant le raisonnement.Voir dans le glossaire varient.
- Ingestion — collecte des logs depuis les agentsagentIASystème qui enchaîne des appels d'outils de façon autonome pour atteindre un objectif : il planifie, agit, observe, recommence. Sa fiabilité décroît exponentiellement avec le nombre d'étapes.Voir dans le glossaire EDR, pare-feux, proxys, IAM et services cloud, sans transformation.
- Normalisation — conversion vers un schéma commun (par exemple ECS ou un Common Information Model) pour que les champs « utilisateur » ou « adresse IP source » soient comparables entre sources hétérogènes.
- Enrichissement — jointure en quasi temps réel avec les quatre couches de contexte décrites plus haut, via des appels API ou des tables de correspondance mises en cache.
- Corrélation et scoring — regroupement des événements liés et calcul d'un score de risque agrégé, généralement par un modèle combinant règles pondérées et composante statistique.
- Triage — présentation à l'analyste d'une file d'alertes ordonnée par score, avec le résumé et les preuves associées.
L'enrichissement doit se faire avant la corrélation, jamais après. Corréler des événements sans contexte produit des regroupements statistiquement corrects mais sémantiquement inutiles — le modèle rapprochera des événements similaires en apparence sans savoir lesquels concernent un compte à privilèges ou un actif critique.
Le coût réel
Le coût d'un pipeline d'enrichissement ne se limite pas à la licence de l'outil. Trois postes sont systématiquement sous-estimés lors du chiffrage initial.
Le calcul et les appels externes. Chaque enrichissement CTI ou chaque résumé généré par un modèle de langagegrand modèle de langageIAModèle entraîné à prédire le token suivant d'une séquence de texte. Toutes ses capacités apparentes — résumer, traduire, coder — découlent de cette unique tâche.Voir dans le glossaire représente un appel API facturé — au volume d'événements, au tokentokenIAFragment de texte manipulé par un modèle de langage, généralement plus court qu'un mot — trois à quatre caractères en français. La tarification et la limite de contexte se comptent en tokens.Voir dans le glossaire, ou aux deux. Un SIEM qui traite un million d'événements par jour ne peut pas se permettre d'enrichir chaque événement individuellement avec un appel à un grand modèle : le coût comme la latence deviennent prohibitifs. La pratique courante consiste à filtrer en amont avec des règles peu coûteuses, puis à ne réserver l'enrichissement le plus coûteux — résumé par modèle de langage, requête CTI premium — qu'aux événements ayant déjà franchi un premier seuil de suspicion.
La latence. Un enrichissement synchrone qui ajoute deux secondes par événement devient inacceptable à grande échelle. Les architectures matures découplent l'ingestion de l'enrichissement via une file de messages, et acceptent un enrichissement asynchrone de quelques secondes à quelques minutes plutôt que du temps réel strict, sauf pour les cas où la vitesse de réponse conditionne le confinement.
Les faux positifs résiduels. Aucun pipeline d'enrichissement ne fait disparaître les faux positifs, il en déplace la proportion. Une organisation qui déploie ce type de système doit budgéter du temps d'analyste pour calibrer les seuils de score sur plusieurs semaines — un seuil trop bas noie à nouveau l'équipe, un seuil trop haut masque des incidents réels.
Mesurez le coût par alerte utile plutôt que le coût par événement ingéré. Un pipeline deux fois plus cher en calcul mais qui divise par cinq le nombre d'alertes à investiguer réduit malgré tout le coût total, car le temps d'analyste senior est presque toujours le poste le plus onéreux du SOC.
Pièges et angles morts
Plusieurs erreurs reviennent régulièrement lors du déploiement de ces pipelines.
- Contexte périmé. Un enrichissement CMDB qui date de plusieurs semaines peut attribuer une criticité obsolète à un actif — serveur décommissionné, machine reclassée. Le contexte doit être rafraîchi à une fréquence cohérente avec le rythme réel de changement de l'infrastructure.
- Sur-confiance dans le score agrégé. Un score unique masque la logique qui l'a produit. Sans traçabilité — quelles couches ont contribué, avec quel poids — l'analyste ne peut ni faire confiance au chiffre ni le contester efficacement.
- EmpoisonnementempoisonnementCybersécuritéIntroduction délibérée d'exemples corrompus dans un jeu d'entraînement, afin d'altérer durablement le comportement du modèle.Voir dans le glossaire du contexte. Si un attaquant compromet en amont une source de contexte — par exemple en modifiant son propre profil dans l'annuaire pour paraître moins sensible — l'enrichissement travaillera contre la détection plutôt que pour elle. Les sources de contexte doivent être aussi protégées que le SIEM lui-même.
- DérivedériveIADégradation progressive des performances d'un modèle après son déploiement, causée par l'évolution des comportements ou du contexte. Elle impose surveillance et réentraînement.Voir dans le glossaire silencieuse du modèle. Un modèle de scoring entraîné sur les incidents d'une année donnée se dégrade progressivement à mesure que les techniques d'attaque évoluent. Sans réentraînement périodique et sans suivi de ses métriques de performance, la qualité du triage se détériore sans qu'aucune alerte ne le signale.
Ne déployez jamais un pipeline d'enrichissement en mode « boîte noire » où seul le score final est visible. En cas d'incident majeur, l'équipe doit pouvoir reconstituer en quelques minutes pourquoi un événement a été classé comme prioritaire ou, pire, pourquoi il ne l'a pas été.
Checklist avant mise en production
- Les quatre sources de contexte (identité, actif, CTI, comportement) sont-elles connectées et rafraîchies à une fréquence documentée ?
- Le pipeline filtre-t-il les événements en amont avant d'engager les enrichissements les plus coûteux ?
- La latence d'enrichissement est-elle compatible avec les cas d'usage nécessitant une réponse rapide ?
- Le score de risque est-il décomposable — chaque couche visible individuellement — plutôt qu'un chiffre opaque ?
- Une fenêtre de calibration des seuils est-elle prévue avec le temps d'analyste correspondant ?
- Les sources de contexte elles-mêmes sont-elles surveillées contre la falsification ?
- Un processus de réentraînement ou de révision périodique du modèle de scoring existe-t-il ?
Un pipeline d'enrichissement bien construit ne remplace pas l'analyste, il change la nature de son travail : moins de tri manuel dans le bruit, davantage d'investigation sur des cas déjà contextualisés. C'est ce déplacement de valeur, plus que la technologie elle-même, qui justifie l'investissement.
L'essentiel à retenir
Un SIEM classique produit un volume d'alertes que peu d'équipes peuvent traiter intégralement, car chaque événement arrive sans contexte sur l'actif, l'utilisateur ou la menace concernée. L'IA intervient pour enrichir ces événements avec des données d'identité, d'inventaire et de renseignement sur la menace, puis pour corréler l'ensemble en un score de risque exploitable. Ce chapitre détaille l'architecture d'un pipeline d'enrichissement, les sources de contexte à connecter, et les coûts réels — calcul, latence, faux positifs résiduels — que ce type de déploiement engendre. Il se termine par une checklist pour éviter les pièges les plus fréquents lors de la mise en production.
Questions fréquentes
Est-ce que l'IA remplace les règles de détection classiques dans un SIEM ?
Combien de temps faut-il pour qu'une ligne de base UEBA devienne fiable ?
Faut-il enrichir tous les événements ou seulement certains ?
Quel est le risque si le score de risque agrégé n'est pas décomposable ?
Comment savoir si les seuils de score sont bien calibrés ?
Une petite équipe SOC peut-elle mettre en place ce type de pipeline sans budget important ?
Que faire si les sources de contexte comme la CMDB sont incomplètes ou périmées ?
Progression sauvegardée dans votre navigateur.
Quiz de validation
Quiz Player
Quiz de validation
Plusieurs réponses possibles — validez ensuite.
Vrai ou faux.
Quiz indisponible (données invalides).