





Détection d'anomalies
Comment les systèmes de sécurité repèrent un comportement suspect à partir de la télémétrie, entre apprentissage supervisé et non supervisé, et pourquoi la gestion des faux positifs conditionne tout le reste.
Table des matières
Pourquoi ce chapitre est le plus utile
Un outil de détection d'anomalies ne dit jamais « voici une attaque ». Il dit « voici un événement statistiquement inhabituel, compte tenu de ce que j'ai observé jusqu'ici ». La différence entre ces deux phrases est le sujet entier de ce chapitre. Comprendre comment un modèle construit sa notion de « normal », ce qui la fait dériver, et pourquoi un taux de faux positifs de 1 % peut suffire à noyer une équipe entière, est un préalable à tout déploiement sérieux de ces systèmes dans un SOC (Security Operations Center).
Ce chapitre ne présente pas un produit ni une suite d'algorithmes à mémoriser. Il pose le cadre conceptuel — superviséapprentissage superviséIAMéthode où chaque exemple d'entraînement est accompagné de la réponse attendue. C'est la famille la plus employée en entreprise, mais elle exige des données étiquetées — souvent le poste de coût principal.Voir dans le glossaire contre non superviséapprentissage non superviséIAMéthode où aucune réponse n'est fournie : le modèle doit dégager seul une structure dans les données, par exemple en regroupant des éléments semblables ou en repérant des anomalies.Voir dans le glossaire, baseline, télémétrie, triage — qui permet ensuite d'évaluer n'importe quel outil de détection avec les bonnes questions.
Supervisé vs non supervisé : deux logiques différentes
La détection d'anomalies en cybersécurité s'appuie sur deux familles de méthodes, dont la logique diffère profondément.
L'apprentissage supervisé entraîne un modèle sur des exemples étiquetés : des millions d'événements déjà classés « bénin » ou « malveillant » par des analystes ou des sources de threat intelligence. Le modèle apprend à reconnaître les motifs associés aux attaques connues — une signature de phishing, une séquence de commandes typique d'un ransomware, un pattern de exfiltration DNSDNSRéseauxSystème qui traduit un nom de domaine en adresse IP, par interrogations successives de la racine, des serveurs de premier niveau puis des serveurs faisant autorité.Voir dans le glossaire. Sa force est la précisionprécisionIAProportion des alertes émises par un modèle qui sont justifiées. Elle s'oppose au rappel : améliorer l'une dégrade l'autre.Voir dans le glossaire sur des menaces déjà documentées. Sa limite est structurelle : il ne détecte que ce qui ressemble, de près ou de loin, à ce qu'il a déjà vu. Une technique réellement inédite passe à travers.
L'apprentissage non supervisé ne cherche pas à reconnaître une attaque connue. Il construit un modèle de ce qui est statistiquement normal pour une entité donnée — un utilisateur, une machine, un service — et signale tout ce qui s'en écarte significativement. Il n'a besoin d'aucune étiquetteétiquetageIATravail consistant à associer à chaque exemple la réponse attendue. C'est presque toujours le poste le plus coûteux d'un projet d'apprentissage supervisé.Voir dans le glossaire « attaque » : il apprend uniquement de la distribution des comportements observés. Sa force est de pouvoir repérer des menaces jamais vues, y compris des attaques internes ou des usages détournés de comptes légitimes. Sa limite est tout aussi structurelle : un écart statistique n'est pas une preuve d'intention malveillante. Un administrateur qui se connecte à 3h du matin pour une maintenance planifiée produit exactement le même signal qu'un compte compromis actif hors horaires.
Ces deux approches ne sont pas concurrentes, elles sont complémentaires. Un SOC mature les combine : le supervisé filtre rapidement les menaces connues à faible coût de calcul, le non supervisé couvre l'angle mort des attaques inédites. Un outil qui ne propose que l'un des deux a une couverture par construction incomplète.
Dans la pratique, une troisième catégorie s'est imposée : les approches semi-supervisées, qui entraînent un modèle uniquement sur du trafic considéré comme normal (sans exemples d'attaque) et mesurent l'écart à cette normalité — c'est en réalité une variante du non supervisé, mais le terme circule beaucoup dans les fiches produit UEBA (User and Entity Behavior Analytics).
Construire une baseline : la partie la plus sous-estimée
La baseline est le référentiel de comportement normal contre lequel chaque nouvel événement est comparé. C'est elle qui détermine, en creux, tout ce qui sera considéré comme anormal.
Une baseline se construit à plusieurs granularités simultanément :
- Par entité — chaque utilisateur, chaque machine, chaque service a son propre profil. Le volume de requêtes DNS normal pour un serveur de résolution n'a rien à voir avec celui d'un poste de travail.
- Par période — un pic de connexions à 9h un lundi n'a pas la même signification qu'à 9h un dimanche. Les baselines sérieuses intègrent la saisonnalité horaire, hebdomadaire et parfois métier (clôture comptable de fin de mois, période de soldes pour un e-commerçant).
- Par contextefenêtre de contexteIAQuantité de texte qu'un modèle peut prendre en compte simultanément : question, documents fournis et historique. Au-delà, les éléments les plus anciens sortent du champ.Voir dans le glossaire organisationnel — un accès à un serveur de paie est normal pour le service RH, anormal pour un développeur, même si le volume de donnéesdonnéesIAEnsemble d'informations structurées ou non utilisées pour entraîner, évaluer ou alimenter un modèle. La qualité, la quantité et la représentativité des données sont les facteurs décisifs pour les performances en apprentissage automatique.Voir dans le glossaire transférées est identique.
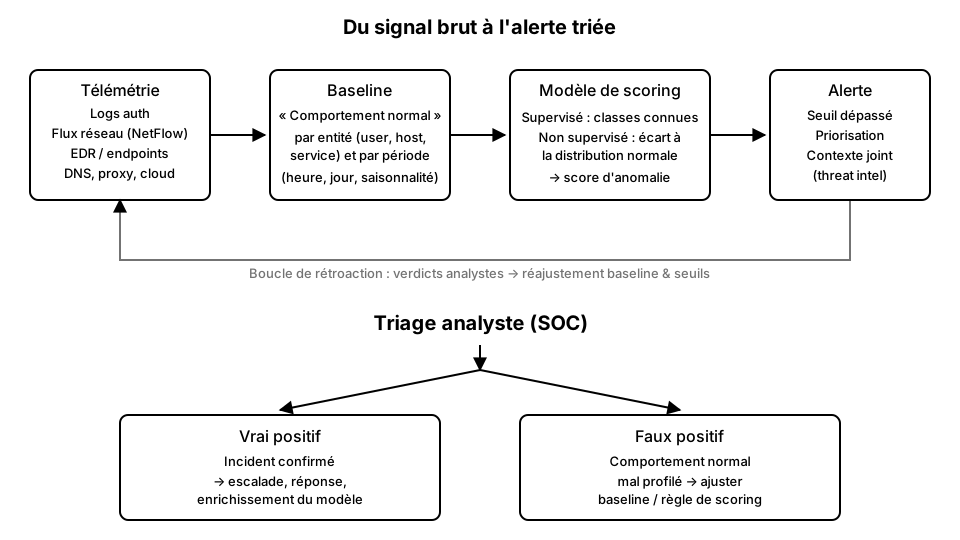
Une baseline n'est jamais figée. Elle doit être réentraînée périodiquement, faute de quoi deux problèmes apparaissent :
- La dérivedériveIADégradation progressive des performances d'un modèle après son déploiement, causée par l'évolution des comportements ou du contexte. Elle impose surveillance et réentraînement.Voir dans le glossaire de concept (concept drift) — l'environnement change (nouvel outil SaaS adopté, migration cloud, réorganisation des équipes) et la baseline devient obsolète, générant des faux positifs en masse sur des comportements devenus légitimes.
- L'empoisonnementempoisonnementCybersécuritéIntroduction délibérée d'exemples corrompus dans un jeu d'entraînement, afin d'altérer durablement le comportement du modèle.Voir dans le glossaire lent — si un attaquant est déjà présent au moment où la baseline se construit ou se met à jour, son comportement malveillant est appris comme « normal ». C'est un risque documenté sur les fenêtres d'apprentissage glissantes trop permissives.
Un réentraînement automatique sans supervision humaine peut faire disparaître une alerte légitime simplement parce que le comportement suspect s'est répété assez longtemps pour intégrer la nouvelle baseline. C'est un angle mort classique des systèmes purement non supervisés en boucle fermée.
Le score d'anomalie et le problème du seuil
Un modèle de détection non supervisé ne produit pas une décision binaire mais un score continu — souvent une distance statistique par rapport au comportement attendu (écart-type, distance de Mahalanobis, score de reconstruction pour un autoencodeur, etc.). Une alerte n'existe que lorsque ce score franchit un seuil défini.
Ce seuil est un arbitrage, pas une vérité technique. Le baisser augmente la sensibilité — on détecte davantage d'attaques réelles — mais aussi le volume de faux positifs. Le monter réduit le bruit mais laisse passer des signaux faibles, souvent caractéristiques des attaques les plus sophistiquées (mouvement latéral lent, exfiltration fractionnée sur plusieurs semaines).
| Position du seuil | Effet sur les vrais positifs | Effet sur les faux positifs | Risque dominant |
|---|---|---|---|
| Bas (sensible) | Détection maximale | Volume élevé | Fatigue d'alerte, incidents noyés |
| Haut (strict) | Détection réduite | Volume faible | Faux négatifs, attaques lentes non vues |
| Adaptatif par entité | Meilleur compromis | Complexité de gestion accrue | Dérive silencieuse si mal supervisé |
Une baisse de seuil de 15 % sur un outil UEBA appliqué à 5 000 employés peut faire passer le nombre d'alertes quotidiennes de 40 à plus de 300. Si l'équipe SOC ne compte que trois analystes, ce changement de paramètre transforme un outil utile en un système que plus personne ne consulte réellement au bout de deux semaines.
Quelques familles d'algorithmes courantes
Derrière le terme générique de « détection d'anomalies » se cachent des mécanismes assez différents, qu'il est utile de distinguer pour évaluer un outil sans se fier uniquement à sa présentation marketing.
- Isolation forest — construit des arbres de décision aléatoires et mesure le nombre de coupures nécessaires pour isoler un point. Un point anormal s'isole en peu d'étapes, car il se situe loin de la masse des observations. Peu coûteux en calcul, efficace sur des données tabulaires à grand volume.
- Clustering (k-means, DBSCAN) — regroupe les comportements en familles homogènes ; tout point qui n'appartient à aucun cluster dense, ou qui se situe loin du centre du cluster le plus proche, est considéré comme anormal. DBSCAN a l'avantage de ne pas imposer de nombre de clusters fixé à l'avance, ce qui convient bien à des populations d'utilisateurs hétérogènes.
- Autoencodeurs — réseaux de neuronesréseau de neuronesIAFonction mathématique composée de neurones artificiels organisés en couches, dont les coefficients sont ajustés pendant l'entraînement. Malgré son nom, il n'a presque rien de commun avec un cerveau.Voir dans le glossaire entraînés à reconstruire leur propre entrée après l'avoir compressée. Sur un comportement normal, l'erreur de reconstruction reste faible ; sur un comportement inédit, le modèle « échoue » à le reconstruire fidèlement, et cette erreur devient le score d'anomalie. Utile sur des données à haute dimension (séquences d'appels API, télémétrie multi-capteurs).
- Modèles de séries temporelles (ARIMA, Prophet, decomposition saisonnière) — modélisent l'évolution attendue d'une métrique dans le temps (volume de connexions, débit réseau) et signalent tout écart significatif par rapport à l'intervalle de prédiction. Particulièrement adaptés à la détection de pics ou de creux anormaux sur des métriques agrégées.
Aucune de ces familles n'est universellement supérieure. Le choix dépend de la nature des données (tabulaires, séquentielles, temporelles), du volume disponible et de la capacité de l'équipe à interpréter et déboguer les scores produits. Un modèle plus complexe qui produit des scores inexplicables aux analystes finit souvent ignoré, quelle que soit sa précision théorique.
Faux positifs : le vrai coût opérationnel
Le faux positif est souvent présenté comme un simple désagrément statistique. Dans un SOC, c'est un coût direct et cumulatif.
Chaque alerte, vraie ou fausse, consomme du temps d'analyste : collecte de contexte, corrélation avec d'autres logs, décision de qualification. Un taux de faux positifs élevé produit ce qu'on appelle la fatigue d'alerte (alert fatigue) : au-delà d'un certain volume, les analystes développent des réflexes de qualification rapide, voire de fermeture automatique, qui finissent par inclure les vrais positifs. C'est le mécanisme documenté derrière plusieurs incidents majeurs où l'alerte pertinente existait bien dans les journaux, mais avait été close sans investigation approfondie faute de temps.
Le rapport signal/bruit d'un outil de détection est souvent un meilleur indicateur de sa valeur opérationnelle réelle que son taux de détection brut annoncé en fiche produit. Un outil qui détecte 98 % des attaques connues mais génère dix fois plus de bruit qu'un outil à 92 % peut être objectivement moins utile en production.
Les leviers pour réduire les faux positifs sans sacrifier la couverture :
- Enrichissement contextuel — croiser le score d'anomalie avec des données tierces (threat intelligence, criticité de l'actif touché, appartenance à un groupe à risque) avant de générer une alerte.
- Corrélation multi-signaux — exiger la conjonction de plusieurs indicateurs faibles plutôt que de déclencher sur un seul signal isolé.
- Rétroaction analyste structurée — chaque verdict (vrai positif / faux positif) doit être capturé et réinjecté dans le modèle ou la règle de seuil, pas seulement archivé dans un ticket fermé.
- SegmentationChunkingIADécoupage d'un document en segments de taille fixe ou sémantique avant indexation vectorielle, pour optimiser la récupération RAG.Voir dans le glossaire fine des baselines — un seuil unique appliqué à toute l'organisation ignore les différences légitimes entre populations (administrateurs systèmes, commerciaux itinérants, machines serveurs).
Télémétrie : la matière première
Aucun modèle, aussi sophistiqué soit-il, ne compense une télémétrie incomplète ou de mauvaise qualité. La détection d'anomalies dépend directement de ce qui est effectivement collecté, avec quelle fréquence, et avec quelle fiabilité.
Les sources typiques d'un pipeline de détection couvrent plusieurs couches :
- Identité et accès — authentifications, élévations de privilèges, créations de comptes.
- Réseau — flux NetFlow, résolutions DNS, trafic proxy et pare-feupare-feuRéseauxÉquipement ou logiciel qui filtre le trafic selon des règles (ports, adresses, états) pour réduire la surface d'attaque.Voir dans le glossaire.
- Endpoints — événements EDR (Endpoint Detection and Response) : processus lancés, connexions établies, modifications de fichiers sensibles.
- Applications et cloud — journaux d'API, actions sur les consoles cloud (IAM, stockage, calcul).
La qualité de cette télémétrie ne se limite pas à sa couverture : elle dépend aussi de sa normalisation. Un même événement d'authentification peut apparaître sous des formats radicalement différents selon la source (Active Directory, fournisseur d'identité cloud, VPNVPNRéseauxRéseau privé virtuel qui chiffre le trafic entre deux points sur un réseau public. Il crée un tunnel sécurisé permettant d'accéder à des ressources distantes comme si on était sur le réseau local.Voir dans le glossaire), avec des horodatages dans des fuseaux différents et des identifiants d'utilisateur incohérents d'un système à l'autre. Sans une couche de normalisation rigoureuse en amont, le modèle de détection travaille sur des données bruitées avant même d'avoir commencé à chercher une anomalie — et les erreurs de corrélation qui en résultent sont difficiles à distinguer d'une vraie dérive de baseline.
Avant d'évaluer un outil de détection, faites l'inventaire de votre télémétrie existante et de ses trous. Un modèle non supervisé entraîné sur trois semaines de logs incomplets, avec des interruptions de collecte non documentées, produira une baseline biaisée et difficile à diagnostiquer a posteriori.
Deux pièges reviennent fréquemment :
- La télémétrie asymétrique — certaines équipes ou certains systèmes sont mieux instrumentés que d'autres. Un attaquant rationnel privilégie les zones les moins surveillées, ce qui rend la couverture inégale particulièrement dangereuse.
- La latence de collecte — un log arrivé avec plusieurs heures de retard dans le pipeline de détection retarde d'autant la détection elle-même, indépendamment de la qualité du modèle.
Checklist avant déploiement
- La baseline est-elle segmentée par entité et par période, ou uniforme sur toute l'organisation ?
- Existe-t-il une procédure de réentraînement documentée, avec supervision humaine des changements significatifs ?
- Le taux de faux positifs a-t-il été mesuré sur un échantillon réel avant mise en production, pas seulement communiqué par l'éditeur ?
- La capacité de traitement du SOC (nombre d'analystes, temps moyen de qualification) a-t-elle été confrontée au volume d'alertes attendu ?
- Les verdicts des analystes sont-ils réinjectés de façon structurée dans le système, ou perdus dans des tickets fermés ?
- La télémétrie couvre-t-elle les zones à risque identifiées (comptes à privilèges, accès distants, actifs critiques) sans angle mort connu ?
En synthèse
La détection d'anomalies n'élimine pas le jugement humain, elle en déplace le point d'application. Au lieu d'examiner chaque événement brut, l'analyste examine des alertes déjà filtrées et scorées — à condition que la baseline, le seuil et la télémétrie aient été construits avec rigueur. Le chapitre suivant explore comment ces alertes s'intègrent concrètement dans les flux de travail d'un SOC, du triage initial à la réponse à incident.
L'essentiel à retenir
Ce chapitre explique comment un système de détection transforme des flux de télémétrie bruts (logs, réseau, endpoints) en alertes exploitables par un SOC. Il distingue l'apprentissage supervisé, qui reconnaît des attaques déjà étiquetées, de l'apprentissage non supervisé, qui repère un écart par rapport à une baseline de comportement normal. Il détaille la construction et le vieillissement de cette baseline, ainsi que le compromis structurel entre faux positifs et faux négatifs qui détermine la charge réelle d'un centre opérationnel de sécurité.
Questions fréquentes
Un outil de détection d'anomalies peut-il remplacer un SOC humain ?
Faut-il privilégier le supervisé ou le non supervisé pour démarrer un projet de détection ?
Combien de temps faut-il pour construire une baseline fiable ?
Qu'est-ce qu'un faux négatif, et pourquoi est-il plus difficile à mesurer qu'un faux positif ?
La détection d'anomalies fonctionne-t-elle aussi bien sur un environnement cloud que sur site ?
Comment savoir si le seuil d'alerte actuel est mal calibré ?
Les modèles de détection d'anomalies nécessitent-ils des données étiquetées pour être évalués ?
Progression sauvegardée dans votre navigateur.
Quiz de validation
Quiz Player
Quiz de validation
Plusieurs réponses possibles — validez ensuite.
Vrai ou faux.
Quiz indisponible (données invalides).