





Threat intelligence et NLP
Comment le traitement automatique du langage accélère l'extraction d'indicateurs de compromission depuis des rapports non structurés, et pourquoi la déduplication et la notation de confiance des sources restent des étapes critiques.
Table des matières
Pourquoi automatiser l'extraction de threat intelligence
Un analyste SOC qui suit l'actualité des menaces reçoit chaque semaine des dizaines de rapports : publications de vendeurs de sécurité, notes d'incident, fils Twitter/X d'chercheurs, pastebins de forums criminels, bulletins CERT. Chaque document contient potentiellement des indicateurs de compromission (IOC) exploitables — adresses IPadresse IPRéseauxIdentifiant numérique attribué à une machine sur un réseau, qui permet de l'atteindre depuis n'importe où. Elle tient sur 32 bits en IPv4 et sur 128 bits en IPv6.Voir dans le glossaire, domaines, hashs de fichiers, clés de registre, user-agentsagentIASystème qui enchaîne des appels d'outils de façon autonome pour atteindre un objectif : il planifie, agit, observe, recommence. Sa fiabilité décroît exponentiellement avec le nombre d'étapes.Voir dans le glossaire — mais noyés dans du texte narratif rédigé pour être lu par un humain, pas parsé par une machine.
Lire manuellement ce volume est impossible à l'échelle d'une équipe réduite. C'est exactement le type de tâche où le traitement automatique du langage (NLP) apporte un gain mesurable : transformerTransformerIAArchitecture introduite en 2017, fondée sur le mécanisme d'attention, qui traite une séquence entière en parallèle. Elle sert de base à tous les grands modèles de langage actuels.Voir dans le glossaire du texte libre en donnéesdonnéesIAEnsemble d'informations structurées ou non utilisées pour entraîner, évaluer ou alimenter un modèle. La qualité, la quantité et la représentativité des données sont les facteurs décisifs pour les performances en apprentissage automatique.Voir dans le glossaire structurées, à un rythme qu'aucune équipe humaine ne peut égaler.
Mais ce chapitre ne vend pas une solution miracle. L'extraction automatisée introduit ses propres défaillances — extraction incomplète, doublons, indicateurs faux ou périmés — qu'il faut connaître avant de brancher un pipeline sur un EDR en mode blocage automatique.
Un IOC extrait automatiquement n'est pas un IOC validé. Le NLP produit des candidats. La décision de bloquer, alerter ou ignorer reste une étape distincte, généralement assortie d'un score de confiance et d'une revue humaine pour les actions à fort impact.
Ce qu'on extrait, et sous quelle forme
Les IOC les plus courants extraits d'un rapport de threat intelligence :
- Réseau : adresses IP, domaines, URLs complètes, plages CIDRCIDRRéseauxNotation qui indique combien de bits d'une adresse IP identifient le réseau, sous la forme /24 par exemple. Elle a remplacé les anciennes classes A, B et C, trop rigides.Voir dans le glossaire
- Fichiers : hashs MD5/SHA1/SHA256, noms de fichiers, chemins
- Identité : adresses e-mail, comptes utilisateurs, clés SSHSSHRéseauxProtocole sécurisé d'accès distant à un serveur, chiffrant session et authentification (clé ou mot de passe).Voir dans le glossaire
- Comportement : commandes shell, clés de registre Windows, mutex, user-agents HTTP
- Attribution : noms de familles de malware, noms de groupes APT, CVE référencées
La difficulté ne vient pas de la liste elle-même — un simple jeu de regex capture correctement une IPv4IPv4RéseauxVersion historique du protocole IP, dont les adresses tiennent sur 32 bits — soit environ 4,3 milliards de combinaisons, aujourd'hui épuisées.Voir dans le glossaire ou un hash SHA256 bien formé. Elle vient du contextefenêtre de contexteIAQuantité de texte qu'un modèle peut prendre en compte simultanément : question, documents fournis et historique. Au-delà, les éléments les plus anciens sortent du champ.Voir dans le glossaire rédactionnel : les rapports emploient volontairement du defanging (hxxp://malicious[.]example[.]com, 1.2.3[.]4) pour éviter qu'un lien reste cliquable ou qu'un antivirus de messagerie déclenche une alerte sur le rapport lui-même. Un pipeline d'extraction doit donc normaliser ces formes avant tout traitement, sous peine de manquer la majorité des indicateurs d'un rapport bien écrit.
Traitez la normalisation comme une étape à part entière, testée indépendamment de l'extraction. Une bibliothèque de règles de defanging maintenue et versionnée évite de réintroduire des angles morts à chaque nouveau format de rapport rencontré.
Regex, NER, ou modèle de langage : trois niveaux d'extraction
Regex ciblées. Efficaces sur les formats à structure fixe (hash, IPv4, CVE). Rapides, déterministes, faciles à auditer. Insuffisantes dès que l'indicateur est entouré de texte ambigu — un domaine cité dans une phrase peut être un IOC malveillant ou une simple référence à un service légitime mentionné pour le contexte (« la victime utilisait Office 365 »).
Reconnaissance d'entités nommées (NER). Un modèle entraîné à repérer des catégories d'entités dans du texte libre — ici adaptée aux entités du renseignement cyber (nom de malware, nom de groupe, secteur ciblé, pays). Le NER capture des informations que les regex ne voient pas : associer un hash à la campagne qui l'utilise, relier une IP à la technique MITRE ATT&CK décrite dans le paragraphe voisin.
Modèles de langage génératifs. Utiles pour synthétiser un rapport long en résumé structuré (acteur, TTP, secteur visé, IOC associés) et pour extraire des relations complexes entre entités. Le risque principal ici est l'hallucinationhallucinationIAProduction par un modèle d'un énoncé faux formulé avec la même assurance qu'un fait établi. Le phénomène est structurel : le modèle optimise la vraisemblance, pas la vérité.Voir dans le glossaire : un modèle génératif peut produire un indicateur plausible mais absent du texte source, en particulier sur des formats de hash ou d'IP qu'il a mémorisés lors de son entraînement sans lien avec le document analysé.
Ne jamais faire confiance à un IOC produit par un modèle génératif sans vérification de sa présence littérale dans le document source. Un pipeline robuste recoupe systématiquement chaque extraction générative avec une recherche exacte dans le texte d'origine, et rejette tout indicateur qui n'y figure pas mot pour mot.
En pratique, les pipelines matures combinent les trois niveaux : regex pour la capture initiale à haut rappelrappelIAProportion des cas positifs réels effectivement détectés par un modèle. Sur un jeu déséquilibré, c'est un indicateur bien plus parlant que l'exactitude globale.Voir dans le glossaire, NER pour la contextualisation et la relation entre entités, modèle génératif pour le résumé de haut niveau — jamais pour la génération finale de la liste d'IOC elle-même.
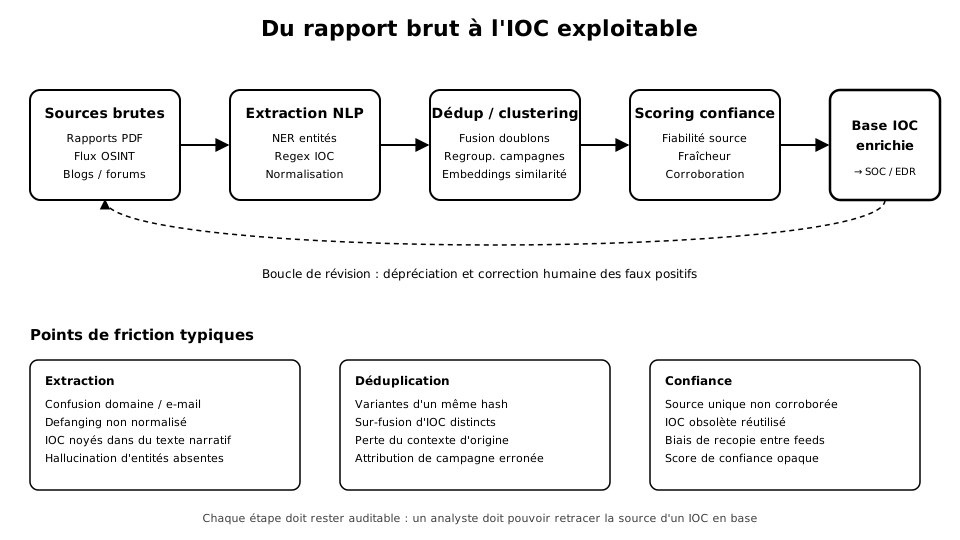
Déduplication et clustering
Une base d'IOC alimentée par plusieurs flux accumule rapidement des doublons : le même hash reporté par trois vendeurs différents avec une casse ou un formatage distinct, la même IP décrite dans dix rapports qui recopient tous la même source primaire. Sans déduplication, la base gonfle sans gain d'information et les analystes perdent du temps à traiter dix fois le même signal.
La déduplication combine plusieurs niveaux :
- Normalisation stricte — casse, encodage, suppression des espaces et du defanging résiduel
- Correspondance exacte — comparaison directe après normalisation
- Similarité approximative — distance d'édition pour les domaines proches (typosquatting, variantes d'un même domaine C2)
- Clustering sémantique par embeddingsembeddingIAReprésentation numérique dense d'un texte, d'une image ou d'un objet dans un espace vectoriel, utilisée pour la similarité et la recherche sémantique.Voir dans le glossaire — regrouper des IOC issus de rapports différents mais décrivant la même campagne, même sans chevauchement textuel exact
Le clustering apporte une valeur au-delà de la simple déduplication : il permet de regrouper des indicateurs disparates sous une même campagne ou un même acteur, ce qui aide à prioriser la réponse (un cluster de vingt IOC actifs liés à un acteur connu pèse plus qu'un IOC isolé d'origine incertaine).
Trois rapports publiés à une semaine d'intervalle décrivent la même campagne de phishing. Le premier cite
login-secure-portal[.]com, le secondlogin-secure-portal.net, le troisième une IP d'hébergement partagée par les deux domaines. Un clustering par similarité lexicale et par infrastructure partagée (même ASN, même certificat TLSTLSRéseauxProtocole cryptographique assurant confidentialité et intégrité des communications applicatives (notamment HTTPS).Voir dans le glossaire) relie les trois éléments en une seule fiche de campagne, au lieu de trois entrées isolées sans lien apparent dans la base.
Le risque inverse existe aussi : la sur-fusion. Un clustering trop agressif peut regrouper des indicateurs réellement distincts sous prétexte de similarité de surface — deux familles de malware différentes qui partagent un même packer, par exemple. Une sur-fusion fausse l'attribution et peut conduire à bloquer du trafic légitime associé à tort à une campagne malveillante.
Scoring de confiance des sources
Toutes les sources de threat intelligence ne se valent pas. Un CERT national qui publie un IOC après investigation forensique n'a pas le même niveau de fiabilité qu'un flux communautaire agrégé automatiquement, ou qu'un post de forum non vérifié. Un pipeline mature attribue à chaque source — et par extension à chaque IOC qui en provient — un score de confiance basé sur plusieurs critères :
| Critère | Question posée | Impact sur le score |
|---|---|---|
| Historique de la source | Taux de faux positifs constaté sur les 90 derniers jours | Pondération de base |
| Méthode de production | Investigation forensique vs agrégation automatique de flux tiers | Multiplicateur |
| Corroboration | Combien de sources indépendantes rapportent le même IOC | Bonus additif |
| Fraîcheur | Ancienneté de la première observation, dernière confirmation | Dépréciation dans le temps |
| Spécificité | IOC unique et ciblé vs IP partagée (CDN, cloud mutualisé) | Pénalité si trop générique |
La corroboration mérite une attentionattentionIAMécanisme par lequel un modèle pondère l'importance de chaque token du contexte lorsqu'il en traite un autre, quelle que soit la distance qui les sépare.Voir dans le glossaire particulière : plusieurs flux qui « confirment » un même IOC peuvent en réalité tous recopier une source primaire unique, sans observation indépendante. Ce biaisbiaisIARégularité correctement apprise dans des données qui ne représentent pas la réalité visée, ou qui enregistrent des décisions passées avec leurs préjugés. Changer d'algorithme ne le corrige pas.Voir dans le glossaire de recopie gonfle artificiellement la confiance perçue si le pipeline compte les sources sans vérifier leur indépendance réelle.
La dépréciation temporelle est souvent négligée. Une IP malveillante d'il y a dix-huit mois a de fortes chances d'avoir été réattribuée à un hébergeur légitime depuis. Sans mécanisme d'expiration ou de repondération dans le temps, une base d'IOC accumule un bruit croissant qui dilue la pertinence des alertes.
Pièges opérationnels à anticiper
Faux positifs par infrastructure partagée. Une IP appartenant à un CDN ou un cloud public peut être signalée dans un rapport parce qu'elle hébergeait temporairement du contenu malveillant, sans que l'IP elle-même soit intrinsèquement dangereuse. Bloquer cette IP en aveugle revient à bloquer potentiellement des milliers de domaines légitimes co-hébergés.
Perte de traçabilité. Un IOC qui arrive dans le SIEM sans référence à son rapport d'origine devient impossible à réévaluer si sa fiabilité est mise en doute plus tard. Chaque entrée doit conserver un lien vers la source, la date d'extraction et la méthode utilisée.
Sur-confiance dans l'automatisation. Un pipeline qui fonctionne bien sur les formats de rapport habituels peut échouer silencieusement sur un format inhabituel (capture d'écran de terminal, tableau scanné, langue étrangère) sans lever d'alerte — il produit simplement zéro extraction, ce qui peut passer inaperçu si personne ne surveille le taux de rendement du pipeline.
Volume sans priorisation. Extraire davantage d'IOC n'améliore pas la posture de sécurité si le SOC ne peut pas absorber le volume. Un pipeline efficace priorise activement — via le score de confiance et le clustering par campagne — plutôt que de maximiser le nombre brut d'indicateurs produits.
Mesurer la performance réelle du pipeline
Un pipeline d'extraction ne se juge pas seulement au nombre d'IOC produits. Trois métriques permettent d'en évaluer l'utilité opérationnelle réelle :
- Le rappel — la proportion d'indicateurs réellement présents dans un rapport qui ont effectivement été extraits. Un rappel faible signifie que le pipeline laisse passer des IOC exploitables, souvent parce que le format du rapport diverge de ceux utilisés pour calibrer les règles d'extraction.
- La précisionprécisionIAProportion des alertes émises par un modèle qui sont justifiées. Elle s'oppose au rappel : améliorer l'une dégrade l'autre.Voir dans le glossaire — la proportion d'indicateurs extraits qui sont réellement valides et pertinents. Une précision faible noie le SOC sous des faux positifs et érode la confiance des analystes envers le pipeline, au point qu'ils finissent par ignorer ses sorties.
- Le délai d'extraction — le temps écoulé entre la publication d'un rapport et l'intégration de ses IOC dans la base opérationnelle. Sur une campagne active, quelques heures de retard peuvent suffire à manquer la fenêtre d'exploitation d'un indicateur encore actif.
Ces trois métriques s'opposent souvent : optimiser agressivement le rappel dégrade généralement la précision, et inversement. Le bon compromis dépend du contexte d'usage — un pipeline qui alimente une alerte automatique nécessite une précision élevée, tandis qu'un pipeline de veille destiné à des analystes qui trient manuellement peut tolérer davantage de bruit en échange d'un meilleur rappel. Constituez un jeu de rapports annotés manuellement, renouvelé périodiquement, pour mesurer ces métriques dans la durée plutôt qu'au moment du déploiement initial : la dérivedériveIADégradation progressive des performances d'un modèle après son déploiement, causée par l'évolution des comportements ou du contexte. Elle impose surveillance et réentraînement.Voir dans le glossaire de performance d'un pipeline NLP face à de nouveaux formats de rapport est progressive et passe facilement inaperçue sans mesure continue.
Articulation avec le reste de la chaîne SOC
Une base d'IOC enrichie n'a de valeur que si elle s'intègre effectivement au reste de la chaîne de détection. Concrètement, cela suppose une interface claire entre le pipeline de threat intelligence et les systèmes consommateurs :
- Export vers le SIEM sous un format standardisé (STIX/TAXII le plus souvent), avec le score de confiance et les métadonnées de traçabilité conservés dans les champs personnalisés
- Règles de corrélation qui pondèrent les alertes selon le score de confiance de l'IOC déclencheur, plutôt qu'un traitement binaire présent/absent
- Retour d'information depuis le SOC vers le pipeline : lorsqu'un analyste confirme ou infirme manuellement un IOC, cette décision doit alimenter la révision du score de la source concernée
Cette boucle de retour humain vers le pipeline, représentée dans le schéma plus haut, est souvent l'élément le plus négligé des déploiements — on investit dans l'extraction, beaucoup moins dans le mécanisme qui permet au système de s'améliorer à partir des corrections des analystes.
Checklist avant mise en production
- La normalisation (defanging, encodage, casse) est testée sur un corpus représentatif des formats de rapport réellement reçus
- Chaque IOC généré conserve une référence vérifiable à sa source et à la date d'extraction
- Les extractions issues de modèles génératifs sont recoupées avec une présence littérale dans le texte source avant intégration
- Un score de confiance est calculé pour chaque source et révisé périodiquement selon le taux de faux positifs observé
- Un mécanisme de dépréciation retire ou repondère les IOC anciens non reconfirmés
- Le taux de rendement du pipeline (rapports traités / IOC extraits) est surveillé pour détecter les échecs silencieux sur des formats non couverts
- Les actions à fort impact (blocage automatique, isolation de poste) restent soumises à un seuil de confiance élevé et, idéalement, à une revue humaine
- Le clustering est audité périodiquement pour détecter les sur-fusions entre campagnes distinctes
Ce pipeline n'élimine pas le travail de l'analyste : il change sa nature. Moins de temps passé à copier des indicateurs depuis des PDF, davantage de temps consacré à trancher les cas ambigus que le score de confiance ne permet pas de résoudre seul.
L'essentiel à retenir
Ce chapitre montre comment le NLP transforme des rapports de threat intelligence non structurés (PDF, blogs, flux OSINT) en indicateurs de compromission exploitables par un SOC. Il détaille les techniques d'extraction d'entités, les méthodes de déduplication et de clustering pour éviter la saturation des bases IOC, ainsi que les modèles de scoring de confiance des sources. Il insiste sur les pièges structurels : hallucination d'entités, sur-fusion d'indicateurs distincts, IOC obsolètes recopiés d'un feed à l'autre. Une checklist opérationnelle conclut le chapitre pour cadrer le déploiement d'un pipeline d'extraction assisté par IA.
Questions fréquentes
Un pipeline NLP peut-il remplacer complètement un analyste threat intelligence ?
Comment vérifier qu'un modèle n'a pas halluciné un IOC lors de l'extraction ?
Faut-il faire confiance à un IOC simplement parce qu'il est rapporté par plusieurs flux différents ?
Quelle est la différence entre déduplication et clustering dans ce contexte ?
Pourquoi bloquer automatiquement toutes les IP extraites d'un rapport de threat intelligence est-il risqué ?
Quels formats de rapport échappent le plus souvent à un pipeline d'extraction automatisé ?
Le NLP appliqué à la threat intelligence fonctionne-t-il aussi bien dans toutes les langues ?
Progression sauvegardée dans votre navigateur.
Quiz de validation
Quiz Player
Quiz de validation
Plusieurs réponses possibles — validez ensuite.
Vrai ou faux.
Quiz indisponible (données invalides).