





Gouvernance et déploiement
Comment faire passer un projet d'IA cyber du prototype à la production : mesure du ROI, conformité réglementaire, MLOps sécurisé et checklist de mise en service.
Table des matières
Pourquoi la gouvernance précède le déploiement
Un modèle de détection qui atteint 98 % de rappelrappelIAProportion des cas positifs réels effectivement détectés par un modèle. Sur un jeu déséquilibré, c'est un indicateur bien plus parlant que l'exactitude globale.Voir dans le glossaire en laboratoire n'est pas un système prêt pour la production. Entre le prototype qui impressionne en démonstration et l'outil qui tourne en continu sur le SOC, il y a un cycle de décisions : qui valide le passage en production, quelles donnéesdonnéesIAEnsemble d'informations structurées ou non utilisées pour entraîner, évaluer ou alimenter un modèle. La qualité, la quantité et la représentativité des données sont les facteurs décisifs pour les performances en apprentissage automatique.Voir dans le glossaire alimentent le modèle, comment mesurer sa dérivedériveIADégradation progressive des performances d'un modèle après son déploiement, causée par l'évolution des comportements ou du contexte. Elle impose surveillance et réentraînement.Voir dans le glossaire dans le temps, qui est responsable en cas de faux négatif sur un incident réel. Ce chapitre couvre ce cycle dans son ensemble — gouvernance, ROI, conformité, MLOps sécurisé — et se termine par une checklist de mise en production directement utilisable.
Ignorer cette étape ne retarde pas seulement le déploiement, elle produit des systèmes fragiles : des modèles jamais réévalués après leur mise en service, des alertes automatisées sans piste d'audit, des coûts de traitement des faux positifs qui finissent par dépasser la valeur créée par l'outil. La gouvernance n'est pas une couche bureaucratique ajoutée après coup — c'est ce qui transforme un modèle qui fonctionne en laboratoire en un système sur lequel une équipe peut fonder des décisions opérationnelles.
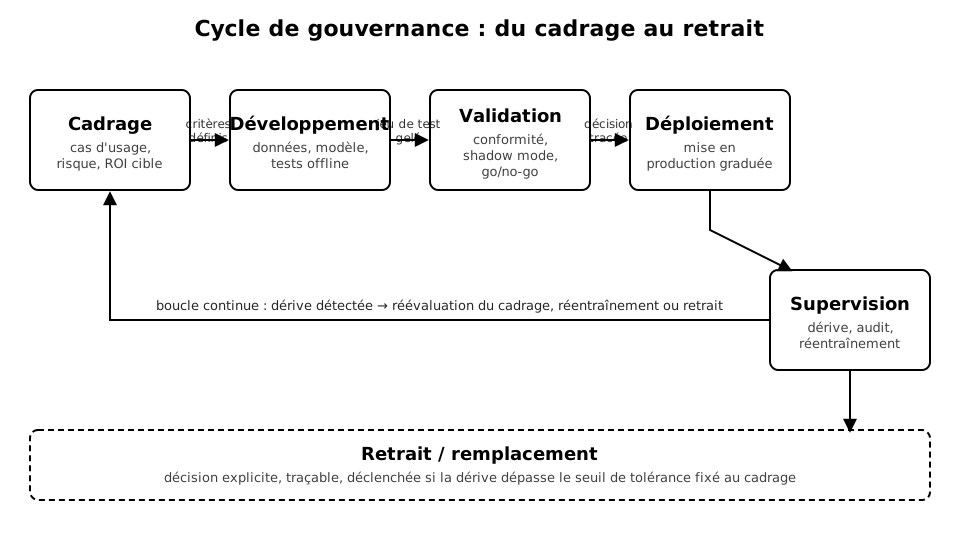
Le cycle de vie : du cadrage au retrait
Un projet d'IAintelligence artificielleIAEnsemble des techniques permettant à un programme d'accomplir une tâche qui demanderait de l'intelligence humaine. Le terme couvre aussi bien les systèmes à règles écrites que ceux qui apprennent de données.Voir dans le glossaire appliqué à la cybersécurité traverse cinq étapes distinctes, chacune avec un critère de sortie explicite.
- Cadrage — le cas d'usage est défini précisément (triage d'alertes EDR, détection d'anomalies réseau, classification de phishing), avec un objectif de performance mesurable et un budget de faux positifs tolérable. C'est ici que se fixe le seuil de dérive qui déclenchera plus tard une réévaluation.
- Développement — constitution du jeu de données, entraînement, tests hors ligne sur un jeu de testjeu de testIAPartie des données réservée à l'évaluation finale, à n'utiliser qu'une seule fois. Ajuster le modèle d'après ses résultats sur ce jeu lui ôte toute valeur de mesure indépendante.Voir dans le glossaire gelé et jamais utilisé pour l'entraînement.
- Validation — vérification de conformité, exécution en shadow mode (le modèle produit des verdicts qui sont journalisés mais n'influencent aucune action réelle), décision go/no-go tracée et documentée.
- Déploiement — mise en production progressive, généralement avec un humain dans la boucleHuman-in-the-loopIABoucle où un opérateur humain valide, corrige ou arbitre les décisions du système IA avant une action irréversible.Voir dans le glossaire pour les premières semaines.
- Supervision — suivi continu de la dérive, audits périodiques, réentraînement ou retrait selon les seuils fixés au cadrage.
Chaque étape doit produire un artefact traçable : critères de cadrage écrits, rapport de validation, journal de décision go/no-go. En cas d'incident impliquant une décision automatisée, c'est cette trace qui permet de reconstituer pourquoi le système a été jugé fiable — et qui a signé cette décision. Un modèle sans registre de décisions est un modèle qu'on ne peut pas défendre devant un auditeur, un régulateur ou sa propre direction.
Calculer le ROI d'un projet IA-cyber
Le retour sur investissement d'un outil de détection ne se limite pas au coût de la licence ou du calcul. Il faut comparer le coût complet du système au coût qu'il évite — et ce dernier terme est souvent mal estimé, dans les deux sens.
Côté coûts : infrastructure d'inférenceinférenceIAUtilisation d'un modèle déjà entraîné sur une donnée nouvelle. Peu coûteuse à l'unité mais répétée à chaque requête, elle constitue le coût récurrent d'exploitation.Voir dans le glossaire, stockage des journaux d'entraînement, temps d'ingénierie pour le MLOps, temps d'analystes pour valider les alertes générées, coût du réentraînement périodique. Côté valeur : réduction du temps moyen de détection (MTTD), réduction du temps moyen de réponse (MTTR), diminution de la charge de triage manuel, incidents évités ou contenus plus tôt.
| Poste | Coût direct | Coût caché fréquemment oublié |
|---|---|---|
| Modèle de détection d'anomalies | Licence / calcul d'entraînement | Temps analyste pour trier les faux positifs générés |
| Triage automatisé d'alertes | Intégration SIEM/SOAR | Perte de confiance des analystes si le taux d'erreur est mal communiqué |
| Détection de phishing par IA | Coût d'inférence par email scanné | Faux négatifs sur les campagnes ciblées absentes du jeu d'entraînement |
| Réentraînement périodique | Cycle MLOps | Dérive non détectée entre deux cycles |
Avant tout chiffrage de ROI, exigez un mois de fonctionnement en shadow mode. Cela donne un taux de faux positifs et de faux négatifs réel, sur votre trafic, avant d'engager le budget de déploiement complet. Les chiffres annoncés par un éditeur sur son propre jeu de données ne se transposent pas automatiquement à votre environnement.
Un ROI honnête inclut aussi le coût de l'attentionattentionIAMécanisme par lequel un modèle pondère l'importance de chaque token du contexte lorsqu'il en traite un autre, quelle que soit la distance qui les sépare.Voir dans le glossaire détournée : chaque alerte automatisée mal calibrée consomme du temps d'analyste qui aurait pu être investi ailleurs. Un système qui réduit le MTTD de 20 % mais double le volume d'alertes à trier peut avoir un ROI négatif malgré une performance technique correcte.
Deux indicateurs méritent un suivi séparé plutôt qu'un chiffre agrégé unique. Le premier est le coût par alerte traitée, qui doit diminuer une fois le système en place — s'il augmente, c'est le signe que le triage automatisé génère plus de travail de vérification qu'il n'en économise. Le second est le taux de confiance des analystes dans les verdicts du système, mesurable par la proportion d'alertes qu'ils rouvrent manuellement sans faire confiance au score fourni. Un outil ignoré par les équipes qui devraient s'en servir a un ROI nul, quelle que soit sa performance mesurée en laboratoire. Le calcul doit donc être révisé à intervalle régulier, pas figé au moment du go-live : la valeur créée par un système de détection évolue avec le paysage de la menace, et un ROI positif en année un peut devenir négatif en année trois si le modèle n'est plus réentraîné.
Conformité : ce qui s'applique réellement
Trois cadres réglementaires se recoupent sur les projets d'IA en cybersécurité, avec des obligations distinctes.
RGPDRGPDConformitéRèglement européen sur la protection des données personnelles. Il s'applique dès qu'un système d'IA traite de telles données, et se cumule avec l'AI Act.Voir dans le glossaire — s'applique dès que le système traite des données à caractère personnel, ce qui est fréquent en cybersécurité : adresses IPadresse IPRéseauxIdentifiant numérique attribué à une machine sur un réseau, qui permet de l'atteindre depuis n'importe où. Elle tient sur 32 bits en IPv4 et sur 128 bits en IPv6.Voir dans le glossaire, identifiants utilisateurs, contenus d'emails analysés pour la détection de phishing. La base légale doit être identifiée (intérêt légitime, le plus souvent), et une analyse d'impactAIPDConformitéAnalyse d'impact relative à la protection des données, obligatoire dès qu'un traitement est susceptible d'engendrer un risque élevé — ce qui couvre la plupart des systèmes de profilage.Voir dans le glossaire (AIPD) est recommandée dès que le traitement est automatisé et peut avoir des conséquences sur une personne — par exemple un blocage de compte déclenché par un score de risque.
NIS2 — impose aux entités concernées des obligations de gestion des risques et de notification d'incidents. Un système de détection basé sur l'IA ne dispense pas de ces obligations : il doit au contraire être intégré dans le dispositif de notification, avec une capacité à documenter comment un incident a été détecté et pourquoi il n'a pas été détecté plus tôt si c'est le cas.
AI ActAI ActConformitéRèglement européen sur l'intelligence artificielle, adopté en 2024. Il classe les systèmes en quatre niveaux de risque selon leur usage — jamais selon leur technologie.Voir dans le glossaire (règlement européen sur l'IA) — classe les systèmes par niveau de risque. La plupart des outilstool callingIACapacité d'un agent ou d'un LLM à invoquer des outils externes (API, calcul, recherche) pendant le raisonnement.Voir dans le glossaire de détection d'anomalies ou de triage d'alertes relèvent d'un risque limité, mais un système qui prend des décisions automatisées ayant un effet direct sur des personnes (blocage d'accès, signalement à une autorité) peut basculer en risque élevéhaut risqueConformitéCatégorie de l'AI Act regroupant les usages soumis à conditions strictes : recrutement, crédit, éducation, infrastructures critiques. Elle impose documentation, examen des biais et contrôle humain effectif.Voir dans le glossaire, avec des obligations de documentation technique, de supervision humaine et de robustesse renforcées.
La classification AI Act d'un système dépend de son usage réel, pas de sa description marketing. Un même modèle de détection d'anomalies peut être à risque limité s'il alimente un tableau de bord consulté par un analyste, et à risque élevé s'il déclenche automatiquement une suspension de compte sans validation humaine. Documentez l'usage effectif, pas l'usage prévu à l'origine.
MLOps sécurisé : la chaîne du modèle est une surface d'attaque
Un modèle de détection déployé en production devient lui-même une cible. Trois familles de risques concernent spécifiquement le MLOps en contextefenêtre de contexteIAQuantité de texte qu'un modèle peut prendre en compte simultanément : question, documents fournis et historique. Au-delà, les éléments les plus anciens sortent du champ.Voir dans le glossaire cyber.
Empoisonnement des donnéesempoisonnementCybersécuritéIntroduction délibérée d'exemples corrompus dans un jeu d'entraînement, afin d'altérer durablement le comportement du modèle.Voir dans le glossaire d'entraînement. Si un attaquant peut influencer les journaux qui servent à réentraîner un modèle de détection, il peut apprendre au système à ignorer son propre trafic. Ce risque est réel dès que le pipeline de réentraînement ingère des données produites par des systèmes exposés (journaux réseau, emails, requêtes applicatives) sans validation d'intégrité.
Dérive de modèle non détectée. Le trafic réseau, les techniques d'attaque et le comportement des utilisateurs évoluent en continu. Un modèle figé se dégrade silencieusement : son taux de faux négatifs augmente sans qu'aucune alerte ne le signale, puisque par définition, un faux négatif ne génère pas d'alerte. Deux formes de dérive doivent être surveillées séparément : le data drift (les données d'entrée changent de distribution) et le concept drift (la relation entre les données et l'étiquetteétiquetageIATravail consistant à associer à chaque exemple la réponse attendue. C'est presque toujours le poste le plus coûteux d'un projet d'apprentissage supervisé.Voir dans le glossaire à prédire change — une nouvelle technique d'attaque ne ressemble à rien de ce qui a été appris).
Supply chain du modèle. Un modèle pré-entraîné téléchargé depuis un dépôt public, une bibliothèque de features ou un service d'inférence tiers introduit une dépendance dont l'intégrité doit être vérifiée au même titre qu'un package logiciel. L'absence de signature ou de provenance vérifiable sur un artefact de modèle est un risque équivalent à l'absence de vérification d'intégrité sur un binaire.
Ces trois familles de risques appellent des contrôles distincts, qu'il est utile de traiter séparément plutôt que sous une politique générique de « sécurité MLOps ». Contre l'empoisonnement, la validation porte sur la source des données de réentraînement : séparation stricte entre journaux bruts et jeu d'entraînement validé, avec une étape de revue avant toute intégration de nouvelles données produites par des systèmes exposés à Internet. Contre la dérive, la validation porte sur la mesure continue de performance, pas sur la seule surveillance de disponibilité du service. Contre les risques de supply chain, la validation porte sur la traçabilité de chaque artefact : origine, version, empreinte cryptographique, et journal des modifications appliquées avant intégration dans le pipeline de production.
Le silence d'un modèle de détection n'est pas une preuve d'absence de menace — il peut être la conséquence d'une dérive non corrigée. Un pipeline MLOps sécurisé doit mesurer activement la performance du modèle sur des échantillons étiquetés récents, pas seulement surveiller sa disponibilité technique. Un modèle qui répond vite et ne détecte plus rien passe tous les contrôles d'infrastructure classiques.
Un SOC déploie un modèle de classification de phishing entraîné sur dix-huit mois de campagnes connues. Six mois après la mise en production, une nouvelle famille de kits de phishing générés automatiquement change la structure des pages piégées. Le taux de détection chute de 92 % à 61 % en quelques semaines, sans qu'aucune alerte de supervision ne se déclenche, car le pipeline ne suivait que la disponibilité du service, pas son taux de rappel réel. Le problème n'est détecté qu'après une revue trimestrielle manuelle — trop tard pour plusieurs campagnes.
La checklist de mise en production
Avant de faire passer un système d'IA cyber du shadow mode à la production active, chaque point suivant doit être vérifié et documenté :
- Le cas d'usage et les critères de succès sont écrits et signés par le responsable métier concerné.
- Le jeu de test de validation est distinct des données d'entraînement et représentatif du trafic réel de l'organisation.
- Le taux de faux positifs et de faux négatifs mesuré en shadow mode est connu et jugé acceptable par les équipes qui devront le gérer.
- La base légale RGPD du traitement est identifiée ; une AIPD a été réalisée si le traitement a un effet sur des personnes.
- La classification AI Act du système a été évaluée sur la base de son usage réel, pas de sa description initiale.
- Un mécanisme de supervision humaine existe pour les décisions à fort impact (blocage, signalement, suspension).
- Un indicateur de dérive (data drift ou concept drift) est instrumenté et alerte en dessous d'un seuil défini au cadrage.
- Le pipeline de réentraînement valide l'intégrité et la provenance des données et des artefacts de modèle utilisés.
- Un plan de retrait existe : conditions précises qui déclenchent la désactivation ou le remplacement du système.
- Un registre de décisions (qui a validé le go-live, quand, sur quelle base) est archivé et accessible pour audit.
Après le déploiement : supervision et sortie
La mise en production n'est pas la fin du cycle, c'est le début de la phase la plus longue. Un modèle en production doit être réévalué à intervalle régulier sur un échantillon frais et étiqueté manuellement, indépendamment de ses propres verdicts — sans quoi le système finit par valider ses propres erreurs en boucle.
Le critère de retrait mérite la même rigueur que le critère de mise en production. Un système dont le taux de faux négatifs dépasse le seuil fixé au cadrage doit être suspendu ou repassé en shadow mode, pas maintenu en production parce qu'il a coûté cher à développer. Le coût irrécupérable d'un projet ne justifie jamais son maintien en dessous du niveau de performance requis pour la sécurité qu'il est censé apporter.
Enfin, la gouvernance d'un système d'IA cyber n'est jamais figée : elle doit être révisée chaque fois que le périmètre d'usage change, qu'une nouvelle source de données est ajoutée, ou que le contexte réglementaire évolue. Un système validé pour le triage d'alertes internes n'est pas automatiquement validé pour un usage étendu à des décisions ayant un effet direct sur des tiers.
L'essentiel à retenir
Ce chapitre traite du passage d'un projet d'IA cyber du prototype à la production : cadrage, validation, déploiement graduel et supervision continue. Il détaille comment calculer un ROI réaliste (coût du run vs. valeur des incidents évités), quelles obligations réglementaires s'appliquent (RGPD, NIS2, AI Act) et comment sécuriser la chaîne MLOps contre l'empoisonnement de données et la dérive de modèle. Une checklist de mise en production et des critères de retrait explicites concluent la démarche.
- Gouvernance du cycle de vie IA (cadrage, validation, déploiement, retrait)
- ROI d'un projet d'IA cyber
- Shadow mode et déploiement graduel
- Conformité RGPD, NIS2 et AI Act appliquée à la cybersécurité
- MLOps sécurisé et supply chain des modèles
- Dérive de modèle (data drift, concept drift)
- Checklist de mise en production (go-live)
- Traçabilité et responsabilité des décisions automatisées
Questions fréquentes
Faut-il toujours réaliser une AIPD pour un système d'IA de détection cyber ?
Combien de temps faut-il maintenir un modèle en shadow mode avant la production ?
Un modèle qui fonctionne bien peut-il quand même être classé à risque élevé par l'AI Act ?
Comment détecter une dérive de modèle si les faux négatifs ne génèrent pas d'alerte ?
Qui doit signer la décision de passage en production d'un système d'IA cyber ?
Le coût de développement déjà engagé justifie-t-il de maintenir un système sous-performant ?
Le MLOps sécurisé concerne-t-il uniquement les grands modèles de langage ?
Progression sauvegardée dans votre navigateur.
Quiz de validation
Quiz Player
Quiz de validation
Plusieurs réponses possibles — validez ensuite.
Vrai ou faux.
Quiz indisponible (données invalides).