





Copilotes SOC
Comment un copilote fondé sur un modèle de langage assiste un analyste SOC dans l'investigation, la rédaction de playbooks et la synthèse d'incidents, et pourquoi ses sorties doivent rester vérifiables et tracées à chaque étape.
Table des matières
Un copilote n'est pas un détecteur
Le terme « copilote SOC » désigne un assistant fondé sur un grand modèle de langageLLMIAGrand modèle de langage (Large Language Model) entraîné sur d'énormes corpus pour prédire et générer du texte.Voir dans le glossaire, intégré aux outilstool callingIACapacité d'un agent ou d'un LLM à invoquer des outils externes (API, calcul, recherche) pendant le raisonnement.Voir dans le glossaire d'un centre opérationnel de sécurité pour accélérer des tâches de rédaction, de synthèse et de recherche. Il ne faut pas le confondre avec les moteurs de détection ou de scoring abordés dans les chapitres précédents : un copilote ne repère pas d'intrusion par lui-même, il aide un analyste à travailler plus vite sur des donnéesdonnéesIAEnsemble d'informations structurées ou non utilisées pour entraîner, évaluer ou alimenter un modèle. La qualité, la quantité et la représentativité des données sont les facteurs décisifs pour les performances en apprentissage automatique.Voir dans le glossaire déjà produites par le SIEM, l'EDR ou les flux de threat intelligence.
Cette distinction conditionne tout le reste du chapitre. Un moteur de scoring produit un chiffre à partir d'un modèle statistique entraîné sur des données étiquetées ; un copilote produit du texte à partir d'un modèle entraîné à prédire la suite la plus probable d'une séquence de mots. Le second mécanisme n'a aucune garantie intégrée d'exactitude factuelle — c'est précisément ce qui fait sa polyvalence et sa fragilité.
Dans la pratique, un copilote SOC est presque toujours un habillage métier au-dessus d'un modèle de langagegrand modèle de langageIAModèle entraîné à prédire le token suivant d'une séquence de texte. Toutes ses capacités apparentes — résumer, traduire, coder — découlent de cette unique tâche.Voir dans le glossaire généraliste, connecté par API à des outils internes (SIEM, base de tickets, référentiel d'actifs). La qualité perçue de l'outil dépend autant de la qualité de ces connexions que du modèle lui-même.
Trois usages concrets
Traduire une intention en requête technique
L'usage le plus mesurable est la traduction d'une question posée en langage naturel vers une requête technique exécutable — KQL, SPL, ou tout autre langage de requête propre au SIEM utilisé. Un analyste formule : « montre-moi toutes les connexions RDP externes vers des serveurs de production depuis sept jours » ; le copilote génère la requête correspondante, l'analyste l'exécute et en vérifie le résultat.
Cet usage réduit une friction réelle : la maîtrise fine d'un langage de requête prend des mois à acquérir, et un analyste junior perd un temps disproportionné à chercher la syntaxe exacte plutôt qu'à raisonner sur les résultats. Le gain est net, à condition de garder une règle simple : la requête générée est toujours exécutée et son résultat toujours lu par l'analyste avant toute conclusion — le copilote ne rapporte jamais lui-même un résultat qu'il n'a pas vu s'exécuter.
Résumer et reconstituer une chronologie
Une investigation produit rapidement un volume de données difficile à tenir en tête : dizaines d'événements EDR, plusieurs sources de logs, tickets liés, échanges avec d'autres équipes. Un copilote peut ingérer cet ensemble et produire un résumé structuré ou une chronologie ordonnée, ce qui fait gagner un temps important par rapport à une reconstruction manuelle.
Ce cas d'usage est aussi le plus exposé au risque d'hallucinationhallucinationIAProduction par un modèle d'un énoncé faux formulé avec la même assurance qu'un fait établi. Le phénomène est structurel : le modèle optimise la vraisemblance, pas la vérité.Voir dans le glossaire, détaillé plus loin : un résumé lisse naturellement les détails, et un modèle de langage peut combler une zone d'incertitude par un énoncé plausible plutôt que de signaler explicitement un manque d'information.
Rédiger des playbooks et des rapports
Le copilote peut proposer un brouillon de playbook de réponse à incident — la séquence d'actions à mener face à un scénario donné (compte compromis, ransomware, exfiltration) — en s'appuyant sur des playbooks existants et sur le contextefenêtre de contexteIAQuantité de texte qu'un modèle peut prendre en compte simultanément : question, documents fournis et historique. Au-delà, les éléments les plus anciens sortent du champ.Voir dans le glossaire de l'incident en cours. Il peut aussi rédiger un premier jet de rapport post-incident à partir des notes prises pendant l'investigation.
Dans les deux cas, le copilote produit un brouillon, pas un document final. La distinction entre playbook assisté et playbook automatisé est ici centrale : un playbook assisté propose une séquence d'étapes qu'un analyste valide et déclenche lui-même ; un playbook automatisé exécute directement des actions (isolement d'un poste, révocation d'un jeton) sans intervention humaine à chaque étape. Confier la rédaction à un copilote ne justifie en rien de sauter l'étape de validation avant exécution.
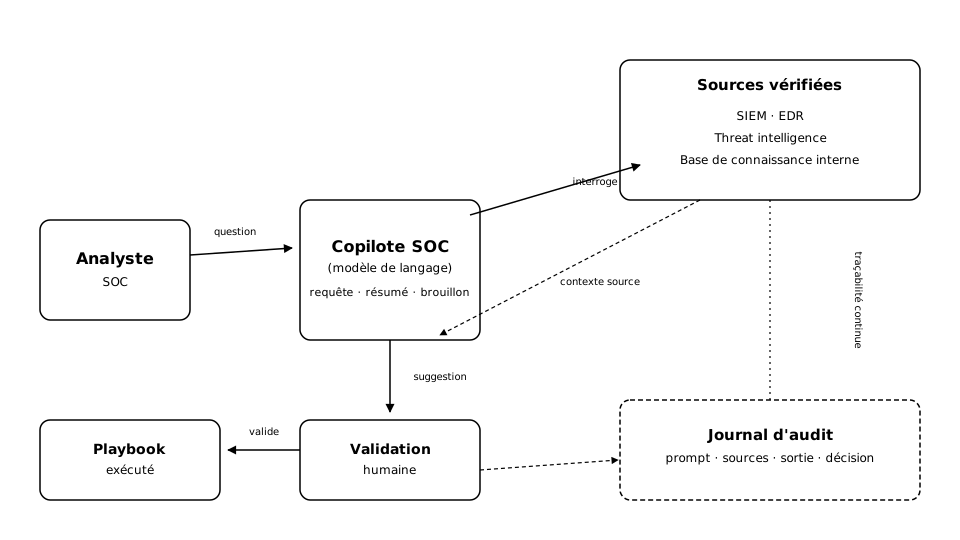
Un analyste demande au copilote de rédiger un playbook de réponse pour un cas de compte de messagerie compromis. Le brouillon généré propose sept étapes cohérentes avec les pratiques standard : révocation des sessions actives, réinitialisation du mot de passe, vérification des règles de transfert automatique créées récemment, recherche d'e-mails envoyés depuis la compromission. L'analyste relit le brouillon, corrige une étape qui référence un outil de MFA différent de celui réellement déployé dans l'organisation, puis valide le playbook corrigé pour exécution. Le gain de temps porte sur la structure et l'exhaustivité initiale, pas sur la dispense de relecture.
Le risque structurel : l'hallucination en contexte d'investigation
Un modèle de langage génère la suite la plus probable d'une séquence de texte, sans mécanisme interne pour distinguer un fait vérifié d'un énoncé simplement vraisemblable. Appliqué à la synthèse d'incidents, ce mécanisme produit un risque spécifique : le modèle peut inventer une adresse IPadresse IPRéseauxIdentifiant numérique attribué à une machine sur un réseau, qui permet de l'atteindre depuis n'importe où. Elle tient sur 32 bits en IPv4 et sur 128 bits en IPv6.Voir dans le glossaire légèrement différente de celle observée dans les logs, réordonner une chronologie de façon plausible mais erronée, ou attribuer à un événement une cause qu'aucune donnée ne confirme réellement.
Ce risque est amplifié par le format même du copilote SOC : les sorties sont rédigées avec la même fluidité et la même assurance apparente, qu'elles soient exactes ou non. Un analyste sous pression de temps, qui lit un résumé bien structuré, a naturellement tendance à lui accorder plus de crédit qu'à une donnée brute et fragmentée — alors que c'est précisément la donnée brute qui porte la garantie d'exactitude.
Ne jamais copier directement la sortie d'un copilote dans un rapport d'incident officiel, une notification réglementaire ou une communication à un client sans revérifier chaque élément factuel (horodatages, adresses IP, noms de comptes, actions effectuées) contre la source brute. Une hallucination dans un rapport transmis en externe engage la crédibilité de l'organisation et, selon le contexte, sa responsabilité juridique.
Deux techniques réduisent — sans l'éliminer — ce risque :
- L'ancrage des réponses (grounding) consiste à contraindre le modèle à ne répondre qu'à partir de documents ou de résultats de requêtes fournis explicitement en contexte, plutôt que sur sa connaissance générale. Un copilote bien conçu cite la source exacte (ligne de log, ticket, requête) associée à chaque affirmation, ce qui permet une vérification rapide.
- La citation systématique des sources dans chaque sortie transforme un énoncé invérifiable en énoncé traçable. Une sortie qui affirme un fait sans indiquer d'où il vient doit être traitée comme une hypothèse à vérifier, jamais comme une donnée établie.
Auditabilité : tracer chaque suggestion
Un copilote intégré au flux de travail d'un SOC touche, par nature, des décisions à conséquence — une requête qui oriente une investigation, un playbook qui déclenche des actions, un rapport qui documente un incident pour un régulateur ou un assureur. Cela impose un niveau de traçabilité comparable à celui exigé pour toute autre action d'un analyste.
Un journal d'audit correctement conçu conserve, pour chaque interaction : le promptpromptIAConsigne ou contexte fourni à un modèle de langage pour orienter sa réponse. La qualité du prompt conditionne souvent la qualité du résultat.Voir dans le glossaire exact soumis par l'analyste, les sources fournies en contexte au modèle, la sortie générée, et la décision finale prise par l'humain (validée, corrigée, rejetée). Cette dernière donnée est souvent négligée alors qu'elle est la plus utile : elle permet de mesurer, dans la durée, le taux de suggestions acceptées telles quelles, corrigées, ou écartées, et donc la fiabilité réelle de l'outil sur le terrain — pas seulement sur un benchmark fourni par l'éditeur.
L'auditabilité n'est pas une fonctionnalité de confort : dans un contexte réglementé (obligations de notification d'incident, exigences d'un assureur cyber, contrôle interne), il doit être possible de reconstituer a posteriori quelle part d'une décision de sécurité provient d'une suggestion générée et quelle part relève d'une vérification humaine indépendante. L'absence de cette traçabilité complique fortement une investigation post-mortem ou un audit de conformité.
Cette exigence a une conséquence pratique sur le choix d'un outil : un copilote qui ne permet pas d'exporter ou de consulter son historique de prompts et de sorties, ou qui masque les sources utilisées pour construire une réponse, doit être considéré comme structurellement inadapté à un usage SOC — quelle que soit la qualité apparente de ses réponses.
Où placer la frontière homme-machine
La règle générale déjà posée dans les chapitres précédents sur le triage s'applique ici avec une nuance : un copilote ne prend jamais de décision, il produit un texte que l'humain doit relire avant tout usage. La question n'est donc pas de savoir si un humain doit intervenir, mais à quel niveau d'exigence cette relecture doit se faire selon l'enjeu de la sortie produite.
| Usage du copilote | Enjeu si erreur | Niveau de vérification requis |
|---|---|---|
| Génération de requête SIEM | Faible (résultat vérifié à l'exécution) | Lecture du résultat de la requête |
| Résumé interne pour l'analyste | Modéré (oriente l'investigation) | Relecture croisée avec les logs bruts sur les points clés |
| Brouillon de playbook | Modéré à élevé (peut déclencher des actions) | Validation explicite avant activationfonction d'activationIAOpération non linéaire appliquée en sortie d'un neurone. Sans elle, empiler des couches serait inutile : une succession d'opérations linéaires reste équivalente à une seule.Voir dans le glossaire, étape par étape |
| Rapport transmis en externe (client, régulateur) | Élevé (engagement juridique et réputationnel) | Vérification factuelle intégrale, ligne par ligne |
Formez les analystes à traiter systématiquement une sortie de copilote comme un brouillon rédigé par un collègue compétent mais qui n'a pas eu accès à toutes les données — ni le bénéfice du doute automatique, ni la défiance systématique, mais une vérification proportionnée à l'enjeu de la sortie produite.
Pièges fréquents
Confiance disproportionnée à la fluidité du texte. Un texte bien rédigé, sans fautes ni hésitations, est perçu comme plus fiable qu'une donnée brute, alors que la qualité rédactionnelle d'un modèle de langage n'a aucun lien avec l'exactitude factuelle de son contenu.
Copilote non ancré utilisé comme moteur de recherche. Interroger un copilote sur un point technique général (une CVE, une technique MITRE ATT&CK) sans lui fournir de source vérifiée en contexte revient à lui demander de reconstituer une connaissance à partir de sa mémoire d'entraînement, potentiellement datée ou approximative sur des détails précis.
Absence de suivi du taux de correction. Sans mesure du taux de suggestions corrigées ou rejetées par les analystes, une organisation ne peut pas savoir si l'outil s'améliore, se dégrade, ou si son usage réel diverge de l'usage prévu au moment de l'achat.
Automatisation prématurée du playbook. Le passage d'un playbook assisté (proposé, validé, exécuté par un humain) à un playbook automatisé (exécuté sans validation) doit être une décision explicite et documentée, jamais une dérivedériveIADégradation progressive des performances d'un modèle après son déploiement, causée par l'évolution des comportements ou du contexte. Elle impose surveillance et réentraînement.Voir dans le glossaire progressive née de la confiance accumulée envers l'outil.
Checklist avant déploiement
- Le copilote cite-t-il systématiquement ses sources (log, ticket, requête) pour chaque affirmation factuelle ?
- Un journal d'audit conserve-t-il le prompt, le contexte fourni, la sortie et la décision finale de l'analyste ?
- Les analystes ont-ils été formés à distinguer un brouillon à vérifier d'un résultat validé ?
- Existe-t-il une règle explicite interdisant la copie directe d'une sortie de copilote dans un document transmis en externe sans vérification ?
- Le taux de suggestions corrigées ou rejetées est-il suivi dans le temps, par type d'usage (requête, résumé, playbook, rapport) ?
- La frontière entre playbook assisté et playbook automatisé est-elle documentée et validée par les responsables de la réponse à incident ?
Cette checklist ne rend pas un copilote infaillible — aucune ne le pourrait, puisque l'hallucination est une propriété structurelle du mécanisme sous-jacent. Elle réduit le risque qu'une sortie non vérifiée se transforme en décision de sécurité prise sur une base fausse.
L'essentiel à retenir
Un copilote SOC est un assistant fondé sur un modèle de langage qui traduit des requêtes en langage naturel vers des requêtes SIEM, résume des investigations et rédige des brouillons de playbooks ou de rapports d'incident. Ce chapitre détaille trois usages concrets de ce type d'outil, puis explique pourquoi l'hallucination — l'invention d'un détail plausible mais faux — constitue un risque structurel particulièrement dangereux en contexte d'investigation de sécurité. Il présente ensuite les mécanismes d'auditabilité indispensables pour tracer chaque suggestion jusqu'à sa source et sa validation, ainsi qu'une checklist pour cadrer un déploiement sans transformer un accélérateur de productivité en source d'erreurs de décision.
- Copilote SOC comme accélérateur de traitement, pas moteur de détection
- Traduction langage naturel vers requête SIEM
- Hallucination en contexte d'investigation de sécurité
- Auditabilité et journal des suggestions
- Playbook assisté vs playbook automatisé
- Validation humaine avant intégration à un rapport officiel
- Ancrage des réponses sur des sources vérifiées (grounding)
Questions fréquentes
Un copilote SOC peut-il détecter une intrusion par lui-même ?
Comment reconnaître qu'une sortie de copilote contient probablement une hallucination ?
Faut-il faire confiance à un copilote pour générer directement des requêtes exécutées sans relecture ?
Pourquoi l'auditabilité est-elle présentée comme une exigence et pas seulement une bonne pratique ?
Un copilote qui cite ses sources est-il à l'abri de toute hallucination ?
Quelle différence pratique entre un playbook rédigé par un copilote et un playbook rédigé par un analyste senior ?
Comment mesurer si un déploiement de copilote SOC apporte un gain réel ?
Progression sauvegardée dans votre navigateur.
Quiz de validation
Quiz Player
Quiz de validation
Plusieurs réponses possibles — validez ensuite.
Vrai ou faux.
Quiz indisponible (données invalides).